Прогнозирование продаж Python. Как находить и сглаживать выбросы с помощью фильтра Хэмплея

Те, кто работает с временными рядами, часто сталкивается с двумя проблемами. Первая – нет полных данных. Вторая – битые данные, когда встречается много выбросов, шума и пропусков. Редко встречаются случаи, когда всё было бы идеально. И данных много, и можно легко найти нужные. Такое встретишь крайне редко или почти никогда.
Возникает вопрос — как решить эту проблему? Я нашёл решение. Давайте расскажу вам, как я решаю проблему битых данных, выбросов, пропусков. Какие я использовал методы, в чем их отличия, преимущества и какие я считаю самыми лучшими.
Начнём мы с первого метода – фильтра Хэмплея. В этой статье речь пойдёт именно о нём. Я постараюсь как можно проще рассказать о его особенностях и показать всё на наглядных примерах. Приступим.
Как работает фильтр Хэмплея
Для начала стоит понять, что такое фильтр Хэмплея. В интернете о нём вы мало что найдёте. По крайней мере, я встретил лишь скудную информацию. Хотя потратил много времени на поиски нужной информации о фильтре.
Главная цель Хэмплея – найти и заменить выбросы в заданном временном ряду. Для этого в своей основе он использует скользящее среднее с заданным окном. Для каждой итерации или окна фильтр вычисляет медиану и стандартное отклонение. Оно выражается в среднем абсолютном значении и обозначается как MAD.

Чтобы MAD стал последовательной оценкой стандартного отклонения надо умножить его на постоянный коэффициент k. Коэффициент зависит от распределения. Мы считаем, что данные подчиняются распределению Гаусса, поэтому берём коэффициент равным 1,4826.
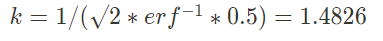
Если значение медианы окна скользящего среднего больше чем х стандартных отклонений, то это – выброс.
Фильтр Хэмплея имеет 2 настраиваемых параметра:
· размер раздвижного окна
· количество стандартных отклонений, которые идентифицируют выброс
Для начала надо импортировать нужные библиотеки:
import matplotlib.pyplot as plt import warnings import pandas as pd import numpy as npЗагрузить данные из csv файла:
df = pd.read_csv('data.csv')df.head()
Вы можете заметить, что выбросы в df уже помечены. Это делается для того, чтобы мы могли сравнить работу алгоритма с фактом.
Далее визуализируем наш df
plt.plot(df.x, df.y) plt.scatter(df[df.outlier == 1].x, df[df.outlier == 1].y, c='r', label='outlier')
Теперь можно реализовывать фильтр Хэмпеля. Для этого используем 3 стандартных отклонения. Почему именно 3? Потому что этого с лихвой хватит для нашего временного ряда.
def hampel(y, window_size, simg=3): n = len(y) new_y = y.copy() k = 1.4826 idx = [] for i in range((window_size),(n - window_size)): r_median = np.median(y[(i - window_size):(i + window_size)]) #скользящая медиана r_mad = np.median(np.abs(y[(i - window_size):(i + window_size)] - r_median)) #скользящий MAD if (np.abs(y[i] - r_median) > simg * r_mad): new_y[i] = r_median #замена выброса idx.append(i) return new_y, idxВызываем фильтр Хэмплея с окном скользящего среднего равного 3, чтобы определить выброс. Этого будет достаточно для нашей задачи.
new_y, outliers = hampel(df.y, 3)В переменной new_y лежит новый временный ряд без выбросов. В outliers — индексы выбросов во временном ряду.
Заливаем новый временный ряд в df вместе с признаками выбросов.
df['new_y'] = new_y df.loc[outliers, 'outlier_hampel'] = 1Осталось визуализировать данные.
from matplotlib.pyplot import figure figure(figsize=(15, 6), dpi=80) plt.plot(df.x, df.y) plt.plot(df.x, df.new_y) plt.scatter(df[df.outlier == 1].x, df[df.outlier == 1].y, c='r', label='outlier') plt.scatter(df[df.outlier_hampel == 1].x, df[df.outlier_hampel == 1].y, c='b', label='outlier')Выбросы, размеченные вручную, выделяются красным цветом. Синие выбросы – это определение модели.

На графике видно, что красного цвета нет. Вывод – алгоритм работает на отлично.
Для лучшего понимания возьмём другой временной ряд, чтобы снова проверить алгоритм.

Здесь заметим, что выбросов гораздо больше.
new_y, outliers = hampel(df_new.y, 3) df_new['new_y'] = res df_new.loc[detected_outliers, 'outlier_hampel'] = 1 from matplotlib.pyplot import figure figure(figsize=(15, 6), dpi=80) plt.plot(df_new.x, df_new.y) plt.plot(df_new.x, df_new.new_y) plt.scatter(df_new[df_new.outlier == 1].x, df_new[df_new.outlier == 1].y, c='r', label='outlier') plt.scatter(df_new[df_new.outlier_hampel == 1].x, df_new[df_new.outlier_hampel == 1].y, c='b', label='outlier')
Увеличим окно скользящего среднего.
new_y, outliers = hampel(df_new.y, 5) df_new['new_y'] = res df_new.loc[detected_outliers, 'outlier_hampel'] = 1 from matplotlib.pyplot import figure figure(figsize=(15, 6), dpi=80) plt.plot(df_new.x, df_new.y) plt.plot(df_new.x, df_new.new_y) plt.scatter(df_new[df_new.outlier == 1].x, df_new[df_new.outlier == 1].y, c='r', label='outlier') plt.scatter(df_new[df_new.outlier_hampel == 1].x, df_new[df_new.outlier_hampel == 1].y, c='b', label='outlier')
Видно, что стало гораздо лучше.
Что касается точности, то она равна 93.33333333333333 %. Я считаю, что это отличный процент.
(df_new[df_new.outlier_hampel == 1].shape[0]/df_new[df_new.outlier == 1].shape[0])*100
Что в итоге?
Фильтр Хэмпеля прекрасно справляется со своей задачей. Его главным преимуществом стала простота реализации. Он может работать быстро как на малых, так и на больших объемах данных. Само собой, есть что улучшить, но в качестве простого и рабочего инструмента фильтр Хэмпеля показывает себя весьма неплохо.
Но так ли он хорош, если сравнивать его с другими алгоритмами? Например, с тестом Греббса, критерием выбора Рознера и рандомным лесом. Об этом я расскажу в следующих статьях, а в конце сравним результаты работы каждого алгоритма и вынесем окончательный вердикт, что же лучше.
Пишем свой прогноз погоды на Python
У Практикума появился новый бесплатный мини-курс — «Прогноз погоды на Python за час». Мы посмотрели, как он работает, и решили повторить это у себя в статье — как обычно, с комментариями и разбором. При этом на курсе всё удобнее — там в тренажёре можно сразу увидеть результат и получить совет, как исправить ошибки, если они появятся.
Можете сейчас пролистать статью, а потом пойти потренироваться в Практикуме. У них написано, что это приключение на час, но описанная в этой статье часть займёт минут пятнадцать. Вводить данные карты не нужно. Выглядит так:
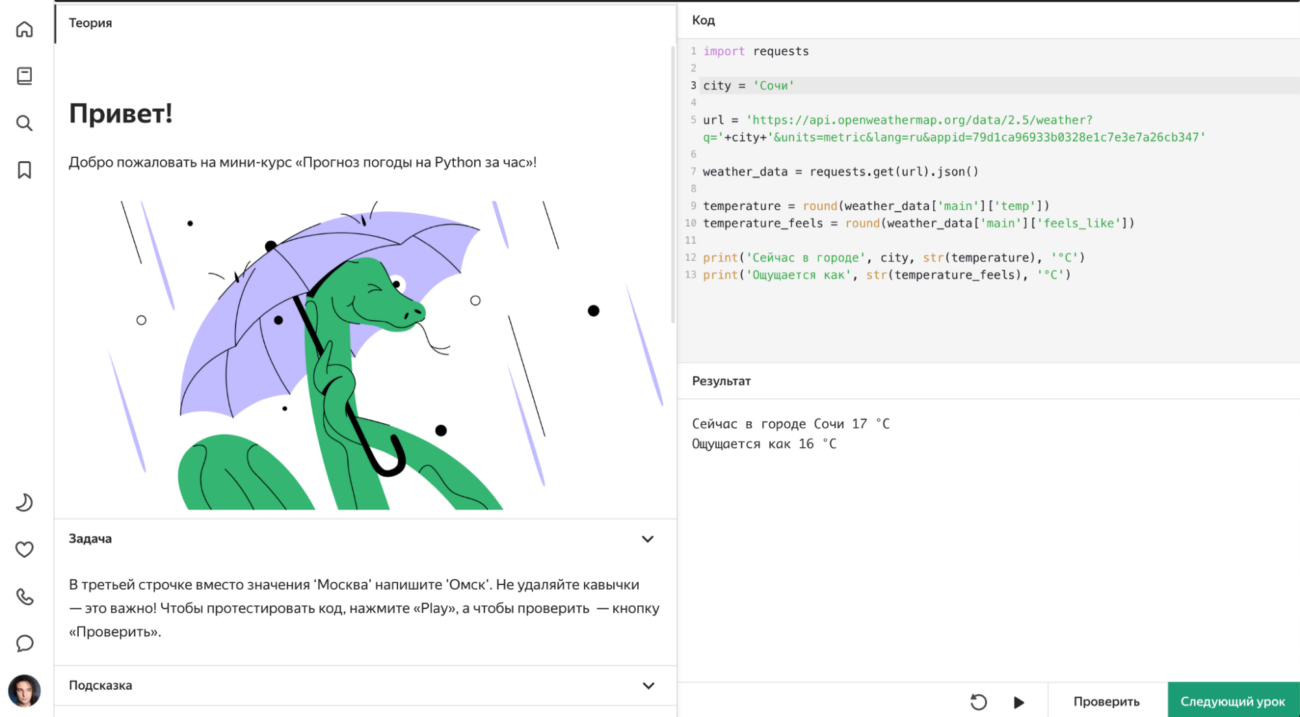
Что делаем
Пишем скрипт, который покажет погоду в выбранном городе. Для этого мы:
- Подключаемся к службе погоды OpenWeather.
- Выбираем город.
- Получаем текущую температуру воздуха в этом городе и то, как она ощущается.
- Выводим результаты на экран.
На деле это проще, чем кажется, — за нас всю работу сделает API службы погоды, а мы только получим и обработаем результаты.
Для работы нам понадобится Python. Если будете делать проект без тренажёра Практикума, вам потребуется среда разработки. Прочитайте, как установить Python на компьютер и начать на нём писать.
Если будете делать в тренажёре Практикума, там среда уже настроена, можно просто делать без установки.
Подключаемся к службе погоды
Чтобы скрипт мог отправлять запросы к другим серверам, нам понадобится библиотека requests . Если вы делаете всё в тренажёре Практикума, эта библиотека уже установлена. А для установки её на свой компьютер нужно открыть терминал и выполнить такую команду:
pip install requests
После установки мы сразу можем подключить библиотеку к своему скрипту. Это уже пишем в коде, а не в терминале:
С этого момента наша программа будет знать, как отправлять запросы на сервер и получать в ответ новые данные. Теперь сделаем переменную с городом, погоду в котором нам интересно узнать:
Город в переменной может стоять любой — Москва, Брянск, Тула, Воронеж или что угодно ещё. Главное, чтобы о нём знала служба погоды OpenWeather.
Перед тем как отправить запрос, нам нужно его сформировать: подготовить специальную строку, которую сервер сможет обработать, чтобы вернуть нам данные о погоде. Она будет состоять из трёх частей:
- Адреса сервера, к которому мы отправляем запрос → https://api.openweathermap.org/data/2.5/weather
- Города, температуру в котором нам интересно узнать → он лежит в переменной city
- Служебных параметров: единиц измерения и ключа приложения → &units=metric&lang=ru&appid=79d1ca96933b0328e1c7e3e7a26cb347
Собираем всё вместе и кладём результат в переменную url:
url = 'https://api.openweathermap.org/data/2.5/weather?q='+city+'&units=metric&lang=ru&appid=79d1ca96933b0328e1c7e3e7a26cb347'Теперь подробнее про службу погоды.
Служба погоды OpenWeather
OpenWeather — это погодный сервис, который собирает данные о погоде в городах со всего мира. У него есть сайт, на который можно зайти, вбить свой город и узнать погоду на сегодня (на английском):
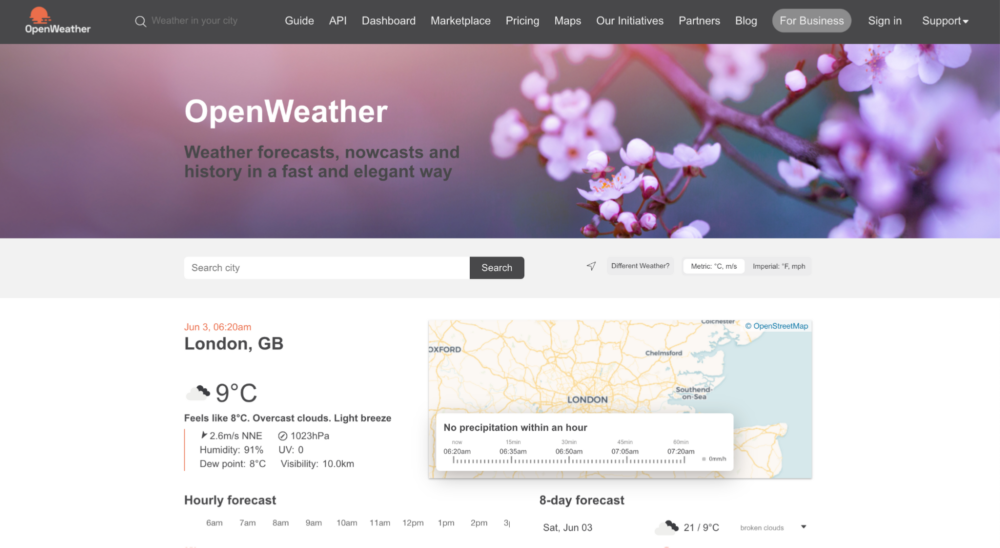
Но особенность этого сервиса в том, что он ещё умеет отвечать на внешние запросы — такие же, как мы сформировали в скрипте.
Если мы заменим переменную в адресе на конкретный город, а затем вставим эту строку в браузер и перейдём по этому адресу, то получим полную информацию о погоде и расположении этого города:

А вот что нам вернул сервер:
В скрипте мы получим эти же данные, а потом обработаем их, чтобы сразу видеть, как там с погодой, не разбираясь во всех этих числах.
Это JSON. Обратите внимание на строку выше. Это называется JSON — JavaScript Object Notation. Это способ передать структурированные данные от одной программы к другой, используя при этом строку текста. В этой строке зашифрованы объекты, их свойства и значения.
Например, видно, что сначала мы задаём нечто под названием coord (координаты), внутри него лежат две сущности lon и lat — широта и долгота. В каждой из этих сущностей лежат числа. Получается, что мы зашифровали в строке какие-то координаты. Благодаря этой разметке можно вкладывать много сущностей друг в друга и передавать так данные между программами. Читайте подробнее об этом в нашей статье про JSON.
Отправляем запрос и выводим результат
Для отправки запроса в службу погоды используем команду requests.get().json() .
Команда Get() отвечает за сам запрос, а json() разбирает ответ в json-формате на составляющие, с которыми потом будет удобно работать:
После этой команды в переменной weather_data появятся все данные с сервера. Чтобы посмотреть их в удобном виде, используем такие команды:
weather_data_structure = json.dumps(weather_data, indent=2) print(weather_data_structure)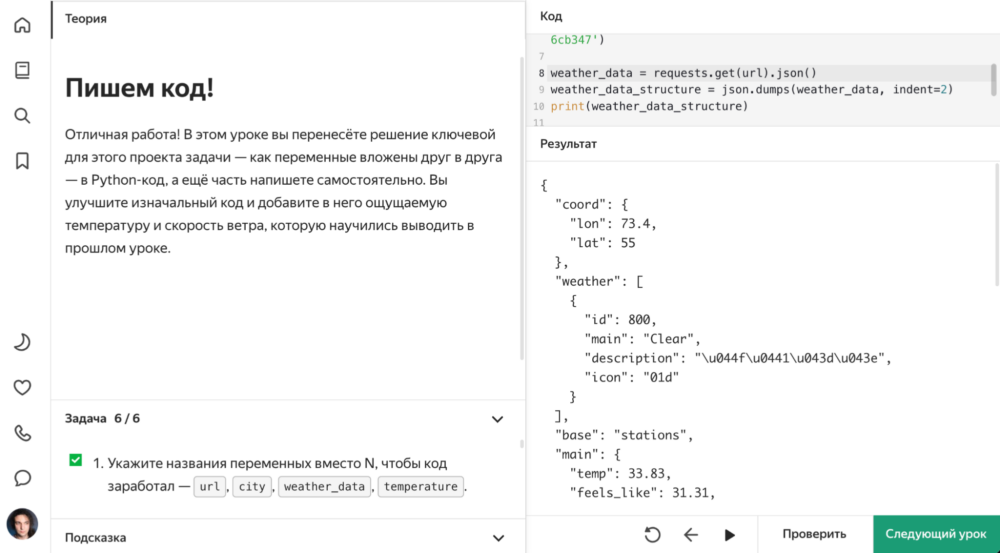
Видно, что данные остались теми же, но стали выглядеть структурированно и понятно. Например, можно заметить, что данные о погоде лежат в разделе main в блоке temp . Используем это, чтобы вывести значение температуры в выбранном городе и то, как она ощущается. Сразу округлим значения функцией round() , чтобы воспринимать градусы было удобнее:
# получаем данные о температуре и о том, как она ощущается temperature = round(weather_data['main']['temp']) temperature_feels = round(weather_data['main']['feels_like']) # выводим значения на экран print('Сейчас в городе', city, str(temperature), '°C') print('Ощущается как', str(temperature_feels), '°C')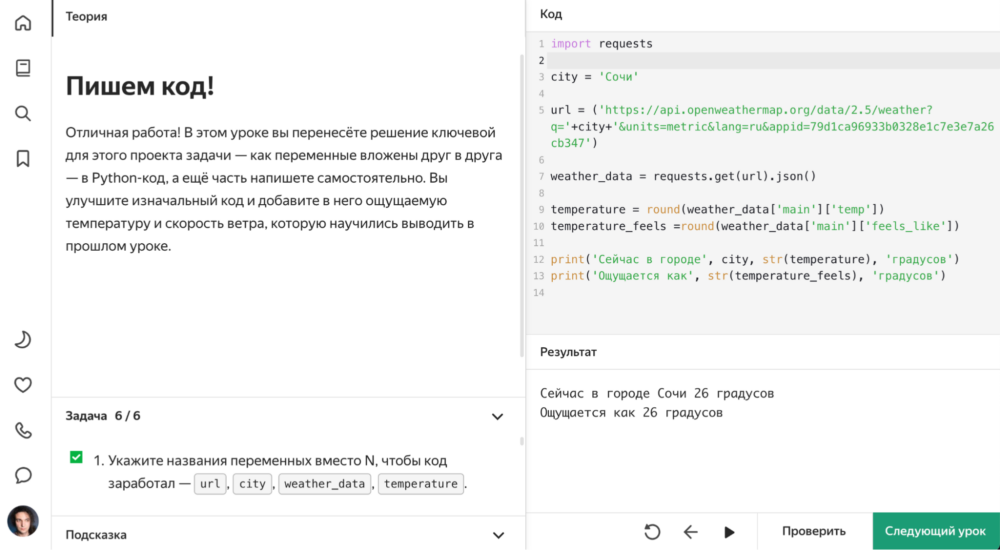
Готовый код
# подключаем библиотеку для работы с запросами import requests # указываем город city = 'Сочи' # формируем запрос url = 'https://api.openweathermap.org/data/2.5/weather?q='+city+'&units=metric&lang=ru&appid=79d1ca96933b0328e1c7e3e7a26cb347' # отправляем запрос на сервер и сразу получаем результат weather_data = requests.get(url).json() # получаем данные о температуре и о том, как она ощущается temperature = round(weather_data['main']['temp']) temperature_feels = round(weather_data['main']['feels_like']) # выводим значения на экран print('Сейчас в городе', city, str(temperature), '°C') print('Ощущается как', str(temperature_feels), '°C')Что дальше
Теперь, когда вы знаете, как выглядит структура данных с ответом от сервера и как получить к ним доступ, вы сможете вывести:
- скорость ветра;
- время рассвета и заката;
- облачность;
- координаты города;
- и много других параметров.
Если хотите разобраться с тем, как работать с такими данными и что ещё можно с ними сделать, — пройдите бесплатный тренажёр «Прогноз погоды на Python за час». Там есть моменты, которые мы не разбирали в статье, — про работу функций и json-форматирование.
Попробуйте бесплатное в «Яндекс Практикуме»
В «Яндекс Практикуме» есть бесплатные курсы, на которых можно получить полезные навыки для работы в ИТ: от Git и Excel до основ Python и облачных технологий.
Получите ИТ-профессию
В «Яндекс Практикуме» можно стать разработчиком, тестировщиком, аналитиком и менеджером цифровых продуктов. Первая часть обучения всегда бесплатная, чтобы попробовать и найти то, что вам по душе. Дальше — программы трудоустройства.
Модель прогнозирования продаж. Временной ряд
1) Код товара 2) Сумма скидки — скидка при покупке 3) Сумма бонуса — начисленно бонусов при покупке 4) Количество — количество едениц проданного товара 5) Код торгового автомата — уникальный код торвого автомата / витрины 6) Дата и время покупки
Есть таблица транзакций торговых автоматов. Мне нужно построить почасовой прогноз на месяц вперед. Хочу прогнозировать объем продаж по каждому конкретному коду товара. Я новичок в анализе данных. Подскажите куда смотреть — буду рад любой помощи. p.s. Интересно как вообще такого рода задачи решаются. Это будет простая регрессия по каждому из кодов товара ?
- python
- машинное-обучение
- синтаксический-анализ
- анализ-данных
Отслеживать
1,270 3 3 золотых знака 23 23 серебряных знака 51 51 бронзовый знак
задан 5 янв 2020 в 10:25
Max Kapustin Max Kapustin
71 1 1 серебряный знак 5 5 бронзовых знаков
5 янв 2020 в 11:20
Там может быть всякое. Может и простая регрессия сработает, а может там есть сезонность и без выделения сезонности и т.д. не получится хорошо. Надо пробовать.
9 янв 2020 в 17:54
1 ответ 1
Сортировка: Сброс на вариант по умолчанию
Решил отказаться от почасового прогноза и прибегнуть к дневному прогнозу.
Прогноз продаж продуктов конкретной витрины на N дней
Шаги:
- Импортирование библиотек
- Загрузить данные
- Обработка данных: Создание векторов для ID продукта и витрины.Группировка(Суммирование продаж) продаж по уникальному набору витрина-категория-товар на каждый.Добавление продаж за последний день на каждый уникальный набор витрина-категория-товар.Добавление продаж(средний) за последние 2 наблюдения на каждый уникальный набор витрина-категория-товар.
- Создание словаря витрина-категория-товар-стоимост_товара
- Генерация данных для прогноза
- Преобразование данных в соответствующие тип данных для обучение
- Разделение данных для тренировки и валидации модели
- Внесение данных и обучение
- Прогноз и проверка валидации
import numpy as np import pandas as pd pd.set_option('display.max_rows', 500) pd.set_option('display.max_columns', 100) from itertools import product from sklearn import preprocessing import seaborn as sns import matplotlib.pyplot as plt from xgboost import XGBRegressor from xgboost import plot_importance import time import sys import gc import pickle import random def plot_features(booster, figsize): fig, ax = plt.subplots(1,1,figsize=figsize) return plot_importance(booster=booster, ax=ax) sys.version_info Загрузка данных
xl = pd.ExcelFile("source.xlsx") sheets = xl.sheet_names df = xl.parse(sheets[0]) df Обработка данных
Для начала надо преобразовать дату в порядковое число, то есть все наблюдения отсортировать по возрастанию даты и перевести дни в числовой вектор. А потом нормализовать год и порядковый номер дня. Так как есть промежуточные id товаров и магазинов, то надо их тоже преобразовать в порядковый и уникальный номер.
# Преобразование 'date' в правильный 'datetime' формат # Извлечение дней, месяцев и годов из 'date' df['date'] = pd.to_datetime(df['date']) df['day'] = df['date'].dt.day df['month'] = df['date'].dt.month df['year'] = df['date'].dt.year # Извлечение день недели для каждой даты df['dayofweek'] = df['date'].dt.dayofweek # Преобразование первоначальных ID товара, магазина и года(чтобы получить потом порядковый номер дня) в нормализованный вектор [0-max] shelf_le = preprocessing.LabelEncoder() shelf_le.fit(df['shelf_id'].unique()) df['shelf_id_encoded'] = shelf_le.transform(df['shelf_id']) product_le = preprocessing.LabelEncoder() product_le.fit(df['product_id'].unique()) df['product_id_encoded'] = product_le.transform(df['product_id']) year_le = preprocessing.LabelEncoder() year_le.fit(df['year'].unique()) df['year_encoded'] = year_le.transform(df['year']) # Генерация порядкого номера дня для каждой даты df['day_block_num'] = df.apply(lambda x: int(x['date'].strftime('%j')), axis=1) df['day_block_num'] = df['day_block_num'] + 365 * df['year_encoded'] # Генерация порядкого номера месяца для каждой даты df['month_block_num'] = df['month'] + 12 * df['year_encoded'] - 1 # Генерация нормализованного порядкого номера дня для каждой даты day_block_num_le = preprocessing.LabelEncoder() day_block_num_le.fit(df['day_block_num'].unique()) df['day_block_num_encoded'] = day_block_num_le.transform(df['day_block_num']) # Сортировка данных по нормализованному порядковому номеру дня df = df.sort_values(by='day_block_num_encoded', ascending=True) df.head() Группировка
Группировка продаж по уникальной группе витрина-категория-товар на каждый день. Данные были сгенерированы в момент проведение наблюдения, то есть с точностью до секунды. Значит, в день могло произойти несколько наблюдений по одному продукту конкретной категории и конкретной витрины. Так как нас интересует дневной прогноз, то можно сгруппировать по дням.
Стоимость товара может изменится за день, поэтому следует выбрать среднее значение за весь день в процессе группировки и проинициализировать значения стоимостей товаров.
# Группировка данных по столбцам 'day_block_num_encoded', 'dayofweek', 'shelf_id_encoded', 'cat_id', 'product_id_encoded' суммирую 'count' grouped_count = df.groupby(['day_block_num_encoded', 'dayofweek', 'shelf_id_encoded', 'cat_id', 'product_id_encoded'])['count'].sum() # Группировка данных по столбцам 'day_block_num_encoded', 'dayofweek', 'shelf_id_encoded', 'cat_id', 'product_id_encoded' извлекаю среднее значение 'price' grouped_price = df.groupby(['day_block_num_encoded', 'dayofweek', 'shelf_id_encoded', 'cat_id', 'product_id_encoded'])['price'].mean() # Преобразование полученных группировок в формат DataFrame multiindex_count = grouped_count.index.to_frame() multiindex_price = grouped_price.index.to_frame() temp_df = pd.DataFrame(multiindex_count[['day_block_num_encoded', 'dayofweek', 'shelf_id_encoded', 'cat_id', 'product_id_encoded']].values, columns=['day_block_num_encoded', 'dayofweek', 'shelf_id_encoded', 'cat_id', 'product_id_encoded']) temp_df['count'] = grouped_count.values temp_df['price'] = grouped_price.values df = temp_df.copy(True) df Добавление продаж за последний день на каждую группу витрина-категория-товар
tdf = df.copy(True) tdf.sort_values(by='day_block_num_encoded', ascending=False) tdf.reset_index(drop=True, inplace=True) tdf['lag_count_1'] = [0] * len(tdf) size = len(tdf.index) for ind in tdf.index: shelf_id = tdf.iloc[ind]['shelf_id_encoded'] cat_id = tdf.iloc[ind]['cat_id'] product_id = tdf.iloc[ind]['product_id_encoded'] day_block_num_encoded = tdf.iloc[ind]['day_block_num_encoded'] _temp_df = tdf[(tdf['shelf_id_encoded'] == shelf_id) & (tdf['cat_id'] == cat_id) & (tdf['product_id_encoded'] == product_id) & (tdf['day_block_num_encoded'] < day_block_num_encoded)] _temp_df.sort_values(by='day_block_num_encoded', ascending=False) if len(_temp_df) != 0: tdf.at[ind, 'lag_count_1'] = _temp_df.iloc[0]['count'] df = tdf.copy(True) df Создание словаря витрина-категория-товар-стоимость_товара
shelves_unique = df['shelf_id_encoded'].unique().tolist() shelves_unique.sort() shelf_dict = dict() for shelf in shelves_unique: shelf_df = df[df['shelf_id_encoded'] == shelf] categories = shelf_df['cat_id'].unique().tolist() cat_product_dict = dict() for category in categories: product_price = dict() products = shelf_df['product_id_encoded'].unique().tolist() products.sort() product_grouped = shelf_df.groupby(['product_id_encoded'])['price'].max() multiindex_price = product_grouped.index.to_frame() temp_df = pd.DataFrame(multiindex_price[['product_id_encoded']].values, columns=['product_id_encoded']) temp_df['price'] = product_grouped.values temp_df['product_id_encoded'] = [int(x) for x in temp_df['product_id_encoded']] temp_df.sort_values(by='price', ascending=True) for ind in temp_df.index: product_price[temp_df.iloc[ind]['product_id_encoded']] = temp_df.iloc[ind]['price'] cat_product_dict[category] = product_price shelf_dict[shelf] = cat_product_dict **Генерация данных для прогноза для каждого уникального набора витрина-категория-товар-цена ** # столбцы которые будут вносится в модель test_columns = ['day_block_num_encoded', 'dayofweek', 'shelf_id_encoded', 'cat_id', 'product_id_encoded', 'price', 'lag_count_1', 'lag_count_2'] test_df = pd.DataFrame(columns=test_columns) dayofweek = 0 last_day = df['day_block_num_encoded'].max() # Генерация пар магазин-категория-товар-стоимость_товара со случайной продажой за последний день/2дня for day in range(last_day + 1, last_day + 1 + DAYS_TO_PREDICT): for shelf in shelf_dict.keys(): categories_as_keys = shelf_dict[shelf].keys() for category in categories_as_keys: products = shelf_dict[shelf][category].keys() prices = shelf_dict[shelf][category].values() array_size = len(products) lag_count_1 = [random.randint(0,1)] * array_size lag_count_2 = [random.randint(0,1)] * array_size temp_df = pd.DataFrame(list(zip([day] * array_size, [dayofweek] * array_size, [shelf] * array_size, [category] * array_size, products, prices, lag_count_1, lag_count_2)),columns=test_columns) test_df = pd.concat([test_df, temp_df]) dayofweek += 1 if dayofweek == 7: dayofweek = 0 test_df **Преобразование данных в соответствующие тип данных для обучение** # Так как в ходе обработок, данные или массивы типов меняются на объекты, их стоит преобразовать в правильные форматы # Тренировочные данные df['day_block_num_encoded'] = df['day_block_num_encoded'].astype(np.int64) df['dayofweek'] = df['dayofweek'].astype(np.int64) df['shelf_id_encoded'] = df['shelf_id_encoded'].astype(np.int64) df['cat_id'] = df['cat_id'].astype(np.int64) df['product_id_encoded'] = df['product_id_encoded'].astype(np.int64) df['lag_count_1'] = df['lag_count_1'].astype(np.int64) df['lag_count_2'] = df['lag_count_2'].astype(np.int64) # Данные для прогноза test_df['day_block_num_encoded'] = test_df['day_block_num_encoded'].astype(np.int64) test_df['dayofweek'] = test_df['dayofweek'].astype(np.int64) test_df['shelf_id_encoded'] = test_df['shelf_id_encoded'].astype(np.int64) test_df['cat_id'] = test_df['cat_id'].astype(np.int64) test_df['product_id_encoded'] = test_df['product_id_encoded'].astype(np.int64) test_df['lag_count_1'] = test_df['lag_count_1'].astype(np.int64) test_df['lag_count_2'] = test_df['lag_count_2'].astype(np.int64) df.info() test_df.info()
Разделение данных для тренировки и валидации модели
# Оставляем последние 30 дней данных для валидации модели, остальные вносятся как тренировочные # Последние день 'date_block_num_encoded' = 539 X_train = df[df['day_block_num_encoded'] < 509].drop(['count'], axis=1) Y_train = df[df['day_block_num_encoded'] < 509]['count'] # Последние 30 дней ->509-539 # Валидационые данные X_valid = df[(df['day_block_num_encoded'] >= 509) & (df['day_block_num_encoded'] = 509) & (df['day_block_num_encoded'] Внесение данных в модель и обучение
model = XGBRegressor( max_depth=8, n_estimators=1000, min_child_weight=300, colsample_bytree=0.8, subsample=0.8, eta=0.3, seed=42) model.fit( X_train, Y_train, eval_metric="rmse", eval_set=[(X_train, Y_train), (X_valid, Y_valid)], verbose=True, early_stopping_rounds = 50) **Прогноз и проверка валидации** # Прогноз для валидации модели Y_valid_predicted = model.predict(X_valid) # Прогноз на DAYS_TO_PREDICT дней Y_predict = model.predict(X_predict) predicted_N_days_df = X_predict.copy(True) predicted_N_days_df['predicted'] = pd.Series(Y_predict) predicted_N_days_df
Сравнение прошлых данных с прогнозом на малом объеме данных и влияние факторов
Работа с временными рядами в Python. Часть 1

Аналитика данных стала неотъемлемой частью современного бизнеса и научных исследований. И одним из ключевых аспектов анализа данных являются временные ряды. Эффективная работа с временными рядами играет критическую роль в прогнозировании, стратегическом планировании и принятии решений в различных отраслях.
Временные ряды — это наборы данных, где каждая точка данных связана с определенным моментом времени. Это может быть что угодно, от ежедневных финансовых показателей до ежечасных кликов на веб-сайте или даже месячных показателей погоды. Зачем нам это нужно? Потому что временные ряды предоставляют нам ценную информацию о том, как меняются данные со временем.
Области, где временные ряды играют решающую роль:
1. Финансовая аналитика: Прогнозирование цен акций, анализ рыночных тенденций и определение оптимального времени для инвестиций.
2. Маркетинг и анализ пользовательской активности: Отслеживание изменений в поведении пользователей на веб-сайте, прогнозирование спроса на товары и услуги.
3. Прогнозирование спроса: Определение оптимального уровня запасов, чтобы избежать дефицита или избытка товаров.
4. Анализ временных данных о заболеваниях: Оценка распространения эпидемий, прогнозирование заболеваемости и смертности.
5. Климатические исследования: Изучение изменений в климатических параметрах, таких как температура и осадки, для анализа климатических тенденций.
6. Прогнозирование трафика: Анализ и прогнозирование трафика на веб-сайтах и в сетях.
7. Промышленное оборудование и обслуживание: Предсказание времени отказа оборудования и оптимизация производственных процессов.
Временные ряды также присутствуют в повседневной жизни: температурные измерения, динамика финансовых индексов или даже ежедневные показатели физической активности с помощью носимых устройств — все это временные ряды.
Временные ряды могут быть стационарными (когда статистические характеристики, такие как среднее и дисперсия, остаются постоянными во времени) или нестационарными (когда эти характеристики изменяются с течением времени). Понимание природы временного ряда важно для выбора подходящих методов анализа.
Основные характеристики временных рядов
Тренд: Тренд представляет собой долгосрочное изменение в данных. Это может быть рост или спад. Например, если продажи вашей компании растут каждый месяц в течение года, это будет проявление тренда.
Сезонность: Сезонность — это циклические изменения данных, которые повторяются с постоянным интервалом времени. Например, продажи игрушек могут расти перед праздниками и падать после них.
Шум: Шум представляет собой случайные колебания данных, которые не подчиняются определенным закономерностям. Это может быть вызвано различными факторами, такими как случайные события или ошибки измерения.
Циклы: Циклы — это долгосрочные колебания данных, которые не связаны с сезонностью. Например, экономические циклы могут вызывать волны роста и спада в продажах.
Стационарность: Стационарный временной ряд — это ряд, в котором статистические характеристики, такие как среднее и дисперсия, остаются постоянными с течением времени. Многие методы анализа временных рядов предполагают стационарность данных.
Автокорреляция: Автокорреляция — это корреляция между значениями ряда в разные моменты времени. Она может помочь выявить закономерности в данных.
Пропущенные значения: Временные ряды могут содержать пропущенные значения, которые требуется обработать перед анализом.
Подготовка к анализу
Прежде чем мы начнем работу, нам нужно убедиться, что у нас есть все необходимые библиотеки для анализа временных рядов:
1. pandas: Pandas — это библиотека для работы с данными, которая предоставляет удобные структуры данных, такие как DataFrame, и множество функций для анализа и манипуляции данными. Она идеально подходит для работы с временными рядами, так как позволяет легко хранить и анализировать временные данные.
2. numpy: NumPy — это библиотека для работы с массивами и матрицами чисел. Она полезна при выполнении вычислений над данными временных рядов.
3. matplotlib и seaborn: Эти библиотеки позволяют создавать графики и визуализации данных, что особенно важно при анализе временных рядов.
4. statsmodels: Statsmodels — это библиотека для статистического анализа данных. Она содержит множество методов для анализа временных рядов, включая модели ARIMA и SARIMA.
5. scikit-learn: Scikit-learn предоставляет множество инструментов для машинного обучения, включая модели регрессии и классификации, которые можно использовать для анализа временных рядов.
!pip install pandas numpy matplotlib seaborn statsmodels scikit-learnТеперь, когда у нас есть необходимые библиотеки, давайте перейдем к работе с датами и временем.
Одной из ключевых характеристик временных рядов является наличие временных меток, которые позволяют нам связывать данные с конкретными моментами времени. При работе с временными рядами необходимо уметь обращаться с датами и временем.
Для начала давайте создадим небольшой dataset с данными о продажах электроники за несколько месяцев. Для примера давайте представим, что у нас есть следующие данные:
import pandas as pd data = df = pd.DataFrame(data) # Преобразуем столбец 'Дата' в формат даты df['Дата'] = pd.to_datetime(df['Дата']) print(df)Результат будет следующим:
Дата Продажи 0 2023-01-01 1000 1 2023-02-01 1200 2 2023-03-01 1300 3 2023-04-01 1100 4 2023-05-01 1400
Теперь у нас есть DataFrame с данными о продажах и столбцом 'Дата', который имеет тип datetime64 . Это позволяет нам выполнять различные операции, такие как выбор данных по дате или вычисление временных интервалов.
# Выбор данных по диапазону дат subset = df[(df['Дата'] >= '2023-03-01') & (df['Дата'] Дата Продажи 2 2023-03-01 1300 3 2023-04-01 1100
Таким образом, работа с датами и временем в pandas позволяет нам легко фильтровать и анализировать данные временных рядов.
Обработка пропущенных значений
Пропущенные значения — это обычное явление при работе с данными временных рядов. Они могут возникать по разным причинам, например, из-за ошибок при сборе данных или временных перерывов в измерениях. Поэтому важно знать, как обрабатывать пропущенные значения.
Давайте рассмотрим, как можно обработать пропущенные значения в DataFrame с помощью pandas. Для примера допустим, что у нас есть следующий dataset:
import pandas as pd data = df = pd.DataFrame(data) # Преобразуем столбец 'Дата' в формат даты df['Дата'] = pd.to_datetime(df['Дата']) print(df) Дата Продажи 0 2023-01-01 1000.0 1 2023-02-01 NaN 2 2023-03-01 1300.0 3 2023-04-01 1100.0 4 2023-05-01 1400.0
Как видите, у нас есть пропущенное значение (NaN) в столбце 'Продажи'. Существует несколько способов обработки таких значений:
1. Удаление строк с пропущенными значениями:
df.dropna(inplace=True)Этот метод удаляет строки, содержащие пропущенные значения. Важно помнить, что это может привести к потере данных.
2. Замена пропущенных значений:
df.fillna(0, inplace=True)Здесь мы заменяем все пропущенные значения на 0. Вы можете выбрать другое значение для замены вместо 0 в зависимости от контекста.
3. Интерполяция:
df.interpolate(inplace=True)Интерполяция позволяет заполнить пропущенные значения на основе соседних значений. Это может быть полезно, если данные имеют некоторую структуру.
Обработка пропущенных значений зависит от конкретной задачи и данных временных рядов. Важно выбирать подходящий метод в каждом случае.
Анализ временных рядов
Мы переходим к разделу анализа временных рядов, который поможет нам раскрывать информацию и закономерности, скрытые в данных. Этот этап позволяет нам понять структуру временных рядов, определить их стационарность и выделить основные компоненты, такие как тренд, сезонность и шум.
Стационарность временных рядов
Стационарность — одно из важнейших свойств временных рядов. Стационарный ряд — это ряд, в котором статистические характеристики, такие как среднее и дисперсия, остаются постоянными во времени. Это свойство позволяет нам строить надежные модели и прогнозировать будущие значения.
1. Тесты на стационарность:
Первый шаг в анализе временных рядов — проверка стационарности. Для этого существует несколько статистических тестов. Один из них — тест Дики-Фуллера. Давайте применим его к нашему небольшому dataset с данными о продажах в условном филиале МВидео:
import pandas as pd import matplotlib.pyplot as plt from statsmodels.tsa.stattools import adfuller # Создаем dataset с данными о продажах data = df = pd.DataFrame(data) # Преобразуем столбец 'Дата' в формат даты df['Дата'] = pd.to_datetime(df['Дата']) # Построим график продаж plt.plot(df['Дата'], df['Продажи']) plt.title('Продажи в магазине МВидео') plt.xlabel('Дата') plt.ylabel('Продажи') plt.show() # Проведем тест Дики-Фуллера на стационарность result = adfuller(df['Продажи']) print('ADF Statistic: %f' % result[0]) print('p-value: %f' % result[1]) print('Critical Values:') for key, value in result[4].items(): print('\t%s: %.3f' % (key, value))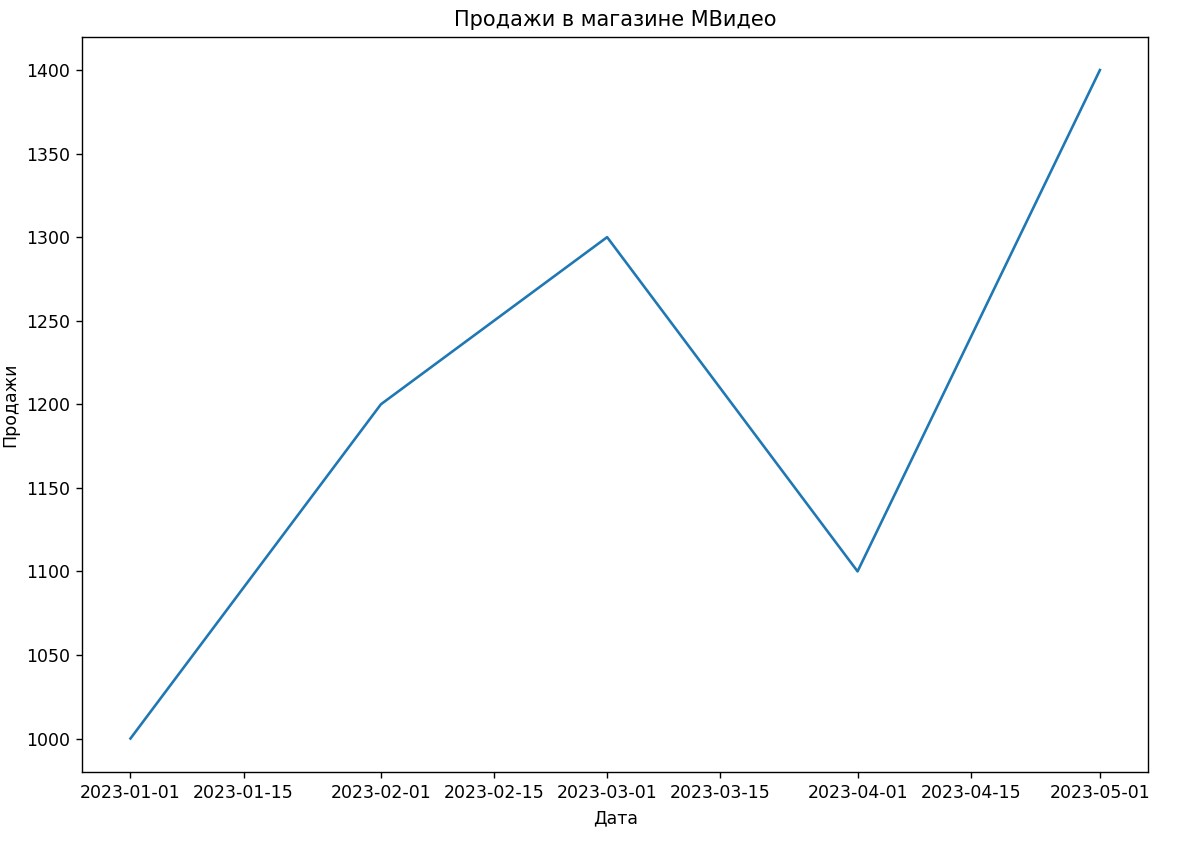
На выходе мы получим статистику теста Дики-Фуллера и p-значение. Если p-значение меньше уровня значимости (обычно 0.05), то мы можем отклонить нулевую гипотезу о нестационарности ряда и считать его стационарным.
2. Преобразование ряда для достижения стационарности:
Если начальный ряд не является стационарным, то его можно преобразовать. Например, можно вычесть тренд и сезонные компоненты, чтобы получить стационарный остаток.
# Преобразование для удаления тренда df['Продажи_без_тренда'] = df['Продажи'] - df['Продажи'].rolling(window=2).mean() # Преобразование для удаления сезонности (в данном случае просто разница между текущим и предыдущим значением) df['Продажи_стационарные'] = df['Продажи_без_тренда'].diff() # Удалим первые строки с пропущенными значениями df.dropna(inplace=True) # Построим графики plt.plot(df['Дата'], df['Продажи_без_тренда'], label='Без тренда') plt.plot(df['Дата'], df['Продажи_стационарные'], label='Стационарные') plt.legend() plt.title('Преобразованные продажи') plt.xlabel('Дата') plt.ylabel('Продажи') plt.show()
Теперь у нас есть стационарный ряд Продажи_стационарные , который мы можем анализировать и моделировать.
Компоненты временных рядов
Временные ряды обычно состоят из трех основных компонентов: тренда, сезонности и шума (остатка). Понимание этих компонентов помогает нам лучше понимать структуру ряда и выбирать подходящие методы анализа.
Тренд — это долгосрочное изменение в данных, которое может быть восходящим (рост), нисходящим (падение) или горизонтальным (без изменений). Он представляет собой общее направление движения данных.
Посмотрим на примере:
# Создаем dataset с данными о продажах с трендом data_trend = df_trend = pd.DataFrame(data_trend) # Преобразуем столбец 'Дата' в формат даты df_trend['Дата'] = pd.to_datetime(df_trend['Дата']) # Построим график продаж с трендом plt.plot(df_trend['Дата'], df_trend['Продажи']) plt.title('Продажи с трендом (рост)') plt.xlabel('Дата') plt.ylabel('Продажи') plt.show()
На графике видно, что продажи увеличиваются со временем. Это пример тренда восходящего направления.
2. Сезонность:
Сезонность — это периодические колебания в данных, которые повторяются через равные временные интервалы. Сезонность может быть годовой, месячной, недельной и т. д. Она связана с событиями, которые регулярно влияют на данные.
# Создаем dataset с данными о продажах с сезонностью data_seasonal = df_seasonal = pd.DataFrame(data_seasonal) # Преобразуем столбец 'Дата' в формат даты df_seasonal['Дата'] = pd.to_datetime(df_seasonal['Дата']) # Построим график продаж с сезонностью plt.plot(df_seasonal['Дата'], df_seasonal['Продажи']) plt.title('Продажи с сезонностью') plt.xlabel('Дата') plt.ylabel('Продажи') plt.show()
На графике видно, что продажи имеют периодические колебания, которые повторяются примерно каждый месяц.
Шум (остаток) — это случайные изменения в данных, которые не могут быть объяснены трендом или сезонностью. Он представляет собой нерегулярные колебания и вариации в данных.
# Создаем dataset с данными о продажах с шумом data_noise = df_noise = pd.DataFrame(data_noise) # Преобразуем столбец 'Дата' в формат даты df_noise['Дата'] = pd.to_datetime(df_noise['Дата']) # Построим график продаж с шумом plt.plot(df_noise['Дата'], df_noise['Продажи']) plt.title('Продажи с шумом') plt.xlabel('Дата') plt.ylabel('Продажи') plt.show()
На графике видно, что продажи имеют случайные колебания, которые не имеют явного тренда или сезонности. Это пример шума.
Автокорреляция и частичная автокорреляция
Автокорреляция — это мера корреляции между временным рядом и его лагированными (отстающими) значениями. Это позволяет нам определить зависимость текущих значений от предыдущих.
Частичная автокорреляция — это мера корреляции между временным рядом и его лагированными значениями с учетом корреляции в промежуточных лагах. Она помогает выявить «чистую» зависимость от определенных отстающих значений, исключая влияние промежуточных лагов.
Представим, что у нас есть временной ряд данных о температуре каждый час:
import pandas as pd import numpy as np import matplotlib.pyplot as plt from statsmodels.graphics.tsaplots import plot_acf, plot_pacf # Создаем небольшой временной ряд температуры np.random.seed(0) dates = pd.date_range(start='2023-01-01', end='2023-01-07', freq='H') temperature = np.random.normal(loc=25, scale=5, size=len(dates)) df_temperature = pd.DataFrame() # Устанавливаем 'Дата' в качестве индекса df_temperature.set_index('Дата', inplace=True) # Построим график временного ряда plt.figure(figsize=(12, 4)) plt.plot(df_temperature.index, df_temperature['Температура']) plt.title('Временной ряд температуры') plt.xlabel('Дата и время') plt.ylabel('Температура (°C)') plt.grid(True) plt.show() # Рассчитываем автокорреляцию и частичную автокорреляцию plt.figure(figsize=(12, 6)) plt.subplot(211) plot_acf(df_temperature['Температура'], lags=50, ax=plt.gca()) plt.title('Автокорреляция') plt.subplot(212) plot_pacf(df_temperature['Температура'], lags=50, ax=plt.gca()) plt.title('Частичная автокорреляция') plt.tight_layout() plt.show()
На графиках автокорреляции и частичной автокорреляции вы можете увидеть значимые лаги, которые могут помочь в выборе параметров модели для анализа и прогнозирования временного ряда температуры. Эти графики помогают определить структуру и зависимости в данных.
Примеры на практике
В этом разделе мы рассмотрим несколько практических примеров использования анализа временных рядов для решения разнообразных задач.
Прогнозирование продаж на основе временных рядов продаж электроники
В этом примере мы будем использовать данные о ежемесячных продажах электроники в магазине МВидео для прогнозирования будущих продаж.
Cоздадим небольшой dataset с данными о продажах. В качестве исходных данных предположим следующие продажи за последние два года:
import pandas as pd import numpy as np # Создаем даты с января 2022 года по декабрь 2023 года dates = pd.date_range(start='2022-01-01', end='2023-12-31', freq='M') # Генерируем случайные продажи в интервале от 1000 до 5000 sales = np.random.randint(1000, 5000, size=len(dates)) # Создаем DataFrame sales_df = pd.DataFrame() # Устанавливаем 'Дата' в качестве индекса sales_df.set_index('Дата', inplace=True) # Выводим первые несколько строк print(sales_df.head()) Продажи Дата 2022-01-31 1355 2022-02-28 4665 2022-03-31 3154 2022-04-30 3490 2022-05-31 3569
Визуализация данных
Перед тем как перейти к прогнозированию, давайте визуализируем данные о продажах, чтобы понять их структуру и особенности.
import matplotlib.pyplot as plt # Построим график продаж plt.figure(figsize=(12, 6)) plt.plot(sales_df.index, sales_df['Продажи'], marker='o', linestyle='-') plt.title('Продажи в магазине МВидео') plt.xlabel('Дата') plt.ylabel('Продажи') plt.grid(True) plt.show()
На графике видно, что у нас есть временной ряд продаж с некоторыми трендами и колебаниями.
Подготовка данных
Прежде чем перейти к прогнозированию, нам нужно подготовить данные. Это включает в себя обработку пропущенных значений и проверку стационарности ряда.
# Обработка пропущенных значений (если они есть) sales_df.dropna(inplace=True) # Проверка стационарности ряда from statsmodels.tsa.stattools import adfuller result = adfuller(sales_df['Продажи']) print('ADF статистика:', result[0]) print('p-значение:', result[1]) print('Критические значения:') for key, value in result[4].items(): print(f' : ')ADF статистика: -3.336001912478917 p-значение: 0.013343910713214318 Критические значения: 1%: -3.859073285322359 5%: -3.0420456927297668 10%: -2.6609064197530863Если p-значение ниже некоторого порогового значения (обычно 0.05), то мы можем считать ряд стационарным.
Выбор и обучение модели
После подготовки данных мы можем выбрать и обучить модель для прогнозирования. Для этого примера мы будем использовать модель ARIMA.
from statsmodels.tsa.arima.model import ARIMA # Обучение модели ARIMA model = ARIMA(sales_df['Продажи'], order=(1, 1, 1)) model_fit = model.fit() # Вывод статистики модели print(model_fit.summary()) SARIMAX Results ============================================================================== Dep. Variable: Продажи No. Observations: 24 Model: ARIMA(1, 1, 1) Log Likelihood -197.611 Date: Mon, 18 Sep 2023 AIC 401.222 Time: 12:03:31 BIC 404.628 Sample: 01-31-2022 HQIC 402.078 - 12-31-2023 Covariance Type: opg ============================================================================== coef std err z P>|z| [0.025 0.975] ------------------------------------------------------------------------------ ar.L1 0.1787 0.252 0.709 0.478 -0.315 0.673 ma.L1 -1.0000 0.349 -2.868 0.004 -1.683 -0.316 sigma2 1.469e+06 2.37e-07 6.19e+12 0.000 1.47e+06 1.47e+06 =================================================================================== Ljung-Box (L1) (Q): 0.05 Jarque-Bera (JB): 0.87 Prob(Q): 0.82 Prob(JB): 0.65 Heteroskedasticity (H): 0.70 Skew: 0.34 Prob(H) (two-sided): 0.63 Kurtosis: 2.33 ===================================================================================
Оценка качества прогноза
После обучения модели мы можем оценить ее качество на основе имеющихся данных.
from sklearn.metrics import mean_squared_error, mean_absolute_error # Прогноз на основе обученной модели forecast = model_fit.forecast(steps=12) # Рассчитываем MSE и MAE mse = mean_squared_error(sales_df['Продажи'][-12:], forecast) mae = mean_absolute_error(sales_df['Продажи'][-12:], forecast) print(f'MSE: ') print(f'MAE: ')MSE: 1178795.2830408707 MAE: 906.8571433244668Прогноз на будущее
Теперь, когда модель обучена и ее качество оценено, мы можем использовать ее для прогнозирования будущих значений.
# Прогноз на будущее (следующие 12 месяцев) forecast_future = model_fit.forecast(steps=12) # Создаем новый DataFrame для будущих значений future_dates = pd.date_range(start='2024-01-01', periods=12, freq='M') forecast_df = pd.DataFrame() # Присоединяем прогноз к исходному DataFrame sales_df = sales_df.append(forecast_df, ignore_index=True) # Визуализация исходных данных и прогноза plt.figure(figsize=(12, 6)) plt.plot(sales_df.index[:-12], sales_df['Продажи'][:-12], label='Исходные данные') plt.plot(sales_df.index[-12:], sales_df['Прогноз продаж'][-12:], label='Прогноз') plt.title('Прогноз продаж в магазине МВидео') plt.xlabel('Дата') plt.ylabel('Продажи') plt.legend() plt.grid(True) plt.show()
На графике показаны исходные данные о продажах и прогноз продаж на следующие 12 месяцев. Этот пример демонстрирует, как использовать анализ временных рядов для прогнозирования будущих продаж в магазине электроники.
Заключение
В данной статье мы рассмотрели основные концепции и методы работы с временными рядами в Python. Мы изучили, как импортировать данные временных рядов, визуализировать их, а также провели анализ стационарности и сезонности.
В следующей части нашей серии статей, мы погрузимся в более продвинутые аспекты работы с временными рядами. Мы рассмотрим, как использовать модели прогнозирования временных рядов, чтобы, например, прогнозировать погоду с учетом исторических данных. Мы также углубимся в анализ временных рядов с переменными интервалами, что может быть полезно в различных прикладных областях. Кроме того, мы уделим внимание совместным временным рядам, где мы сможем исследовать взаимосвязи между разными временными рядами и принимать более информированные решения.
- Блог компании М.Видео-Эльдорадо
- Python