Atomic c что это
Определяет классы и шаблоны классов для создания типов, поддерживающих атомарные операции.
Синтаксис
#include
Замечания
В коде, скомпилированном с помощью /clr:pure этого заголовка, блокируется. Обе /clr:pure версии не /clr:safe рекомендуется использовать в Visual Studio 2017 и более поздних версиях.
Атомарная операция имеет два ключевых свойства, которые помогают использовать несколько потоков для правильного управления объектом без использования mutex блокировок.
- Так как атомарная операция неразличима, вторая атомарная операция с тем же объектом из другого потока может получить состояние объекта только до или после первой атомарной операции.
- На основе его memory_order аргумента атомарная операция устанавливает требования к упорядочению для видимости эффектов других атомарных операций в том же потоке. Следовательно, она подавляет оптимизации компилятора, которые нарушают требования к упорядоченности.
На некоторых платформах бывает невозможно эффективно реализовать атомарные операции для некоторых типов без использования блокировок mutex . Атомарный тип не является lock-free , если атомарные операции с этим типом не используют блокировки.
C++11 : в обработчиках сигналов можно выполнять атомарные операции с объектом obj , если obj.is_lock_free() или atomic_is_lock_free(x) есть true .
atomic_flag Класс предоставляет минимальный атомарный тип, содержащий bool флаг. Его операции всегда являются неблокирующими.
Шаблон atomic класса хранит объект своего типа T аргумента и предоставляет атомарный доступ к такому сохраненном значению. Его можно создать с помощью любого типа, который можно скопировать с помощью и memcpy проверить для равенства. memcmp В частности, его можно использовать с пользовательскими типами, которые соответствуют этим требованиям, и во многих случаях с типами с плавающей запятой.
Шаблон также имеет ряд специализаций для целочисленных типов и частичную специализацию для указателей. Эти специализации предоставляют дополнительные операции, недоступные в основном шаблоне.
Специализации для указателей
Частичные специализации atomic применяются для всех типов указателей. Они предоставляют методы для расчетов с указателями.
Специализации для целочисленных типов
Специализации atomic применяются для всех целочисленных типов. Они предоставляют дополнительные операции, недоступные через первичный шаблон.
Каждый тип atomic имеет соответствующий макрос, который можно использовать в if directive для определения во время компиляции, являются ли операции этого типа неблокирующими. Если значение макроса равно нулю, операции с типом не блокируются без блокировки. Если значение равно 1, операции могут быть неблокирующими, и требуется проверка времени выполнения. Если значение равно 2, операции являются неблокирующими. Вы можете использовать функцию atomic_is_lock_free для определения во время выполнения, являются ли операции с типом неблокирующими.
Для каждого целочисленного типа существует соответствующий именованный атомарный тип, который управляет объектом этого целочисленного типа. Каждый тип atomic_integral имеет тот же набор функций-членов, что и соответствующий экземпляр atomic , и может быть передан в любую из атомарных функций, не являющихся членами.
| Тип atomic_integral | Целочисленный тип | Макрос atomic_is_lock_free |
|---|---|---|
| atomic_char | char | ATOMIC_CHAR_LOCK_FREE |
| atomic_schar | signed char | ATOMIC_CHAR_LOCK_FREE |
| atomic_uchar | unsigned char | ATOMIC_CHAR_LOCK_FREE |
| atomic_char16_t | char16_t | ATOMIC_CHAR16_T_LOCK_FREE |
| atomic_char32_t | char32_t | ATOMIC_CHAR32_T_LOCK_FREE |
| atomic_wchar_t | wchar_t | ATOMIC_WCHAR_T_LOCK_FREE |
| atomic_short | short | ATOMIC_SHORT_LOCK_FREE |
| atomic_ushort | unsigned short | ATOMIC_SHORT_LOCK_FREE |
| atomic_int | int | ATOMIC_INT_LOCK_FREE |
| atomic_uint | unsigned int | ATOMIC_INT_LOCK_FREE |
| atomic_long | long | ATOMIC_LONG_LOCK_FREE |
| atomic_ulong | unsigned long | ATOMIC_LONG_LOCK_FREE |
| atomic_llong | long long | ATOMIC_LLONG_LOCK_FREE |
| atomic_ullong | unsigned long long | ATOMIC_LLONG_LOCK_FREE |
Typedef имена существуют для специализаций атомарного шаблона для некоторых типов, определенных в заголовке .
| Атомарный тип | Typedef Name |
|---|---|
| atomic_int8_t | atomic |
| atomic_uint8_t | atomic |
| atomic_int16_t | atomic |
| atomic_uint16_t | atomic |
| atomic_int32_t | atomic |
| atomic_uint32_t | atomic |
| atomic_int64_t | atomic |
| atomic_uint64_t | atomic |
| atomic_int_least8_t | atomic |
| atomic_uint_least8_t | atomic |
| atomic_int_least16_t | atomic |
| atomic_uint_least16_t | atomic |
| atomic_int_least32_t | atomic |
| atomic_uint_least32_t | atomic |
| atomic_int_least64_t | atomic |
| atomic_uint_least64_t | atomic |
| atomic_int_fast8_t | atomic |
| atomic_uint_fast8_t | atomic |
| atomic_int_fast16_t | atomic |
| atomic_uint_fast16_ | atomic |
| atomic_int_fast32_t | atomic |
| atomic_uint_fast32_t | atomic |
| atomic_int_fast64_t | atomic |
| atomic_uint_fast64_t | atomic |
| atomic_intptr_t | atomic |
| atomic_uintptr_t | atomic |
| atomic_size_t | atomic |
| atomic_ptrdiff_t | atomic |
| atomic_intmax_t | atomic |
| atomic_uintmax_t | atomic |
Структуры
| Имя | Описание |
|---|---|
| atomic Структура | Описывает объект, выполняющий atomic операции с хранимым значением. |
| atomic_flag Структура | Описывает объект, который автоматически устанавливает и очищает флаг bool . |
Перечисления
| Имя | Описание |
|---|---|
| memory_order Перечисления | Предоставляет символьные имена для операций синхронизации в областях памяти. Эти операции влияют на то, как присвоения в одном потоке становятся видимыми в другом. |
Функции
В следующем списке функции, которые не заканчиваются _explicit семантикой соответствующего _explicit , за исключением того, что они имеют неявные memory_order аргументы memory_order_seq_cst .
| Имя | Описание |
|---|---|
| atomic_compare_exchange_strong | atomic compare and exchange Выполняет операцию. |
| atomic_compare_exchange_strong_explicit | atomic compare and exchange Выполняет операцию. |
| atomic_compare_exchange_weak | weak atomic compare and exchange Выполняет операцию. |
| atomic_compare_exchange_weak_explicit | weak atomic compare and exchange Выполняет операцию. |
| atomic_exchange | Заменяет сохраненное значение. |
| atomic_exchange_explicit | Заменяет сохраненное значение. |
| atomic_fetch_add | Добавляет указанное значение к существующему хранимому значению. |
| atomic_fetch_add_explicit | Добавляет указанное значение к существующему хранимому значению. |
| atomic_fetch_and | Выполняет битовое значение «and» ( & ) для указанного значения и существующего сохраненного значения. |
| atomic_fetch_and_explicit | Выполняет битовое значение «and» ( & ) для указанного значения и существующего сохраненного значения. |
| atomic_fetch_or | Выполняет битовое значение «или» ( | ) для указанного значения и существующего сохраненного значения. |
| atomic_fetch_or_explicit | Выполняет битовое значение «или» ( | ) для указанного значения и существующего сохраненного значения. |
| atomic_fetch_sub | Вычитает указанное значение из существующего хранимого значения. |
| atomic_fetch_sub_explicit | Вычитает указанное значение из существующего хранимого значения. |
| atomic_fetch_xor | Выполняет побитовое «эксклюзивное или» ( ^ ) значение указанного значения и существующее хранимое значение. |
| atomic_fetch_xor_explicit | Выполняет побитовое «эксклюзивное или» ( ^ ) значение указанного значения и существующее хранимое значение. |
| atomic_flag_clear | Устанавливает флаг в объекте atomic_flag в значение false . |
| atomic_flag_clear_explicit | Устанавливает флаг в объекте atomic_flag в значение false . |
| atomic_flag_test_and_set | Устанавливает флаг в объекте atomic_flag в значение true . |
| atomic_flag_test_and_set_explicit | Устанавливает флаг в объекте atomic_flag в значение true . |
| atomic_init | Задает сохраненное значение в объекте atomic . |
| atomic_is_lock_free | Указывает, являются ли атомарные операции с указанным объектом неблокирующими. |
| atomic_load | Атомарным образом получает значение. |
| atomic_load_explicit | Атомарным образом получает значение. |
| atomic_signal_fence | Действует как правило fence , которое устанавливает требования к упорядочению памяти между заборами в вызывающем потоке с обработчиками сигналов, выполняемыми в одном потоке. |
| atomic_store | Атомарным образом сохраняет значение. |
| atomic_store_explicit | Атомарным образом сохраняет значение. |
| atomic_thread_fence | Действует в качестве fence того, что устанавливает требования к упорядочению памяти в отношении других заборов. |
| kill_dependency | Разрывает возможную цепочку зависимостей. |
Горные лыжи ATOMIC

Юным гонщикам FIS GS, стремящимся занять первое место в списке очков, нужны лыжи, обладающие функциями профессиональный моделей. Это Redster G9 FIS Revoshock S. Они оснащены Revoshock от Atomic, выигравшим чемпионат мира, — серией пластин из пружинной стали, встроенных в интегрированную эластомерную конструкцию, которая поглощает неровности на трассе, обеспечивая стабильную езду с резкими ускорениями на выходе из поворотов. Полноразмерные боковые стенки и ламинат Atomic Ultra Titanium Powered обеспечивают высочайший уровень цепкости кантов и жесткость на скручивание. Ultra Power Woodcore работает вместе с платформой Active Race Interface, чтобы передавать все ваши движения сразу в лыжи, которые реагируют со скоростью мысли. Redster G9 FIS Revoshock S пролетают сквозь ворота, стабильны на скорости и наверняка поднимут вас на подиум.
Размеры: 173
Юным гонщикам FIS GS, стремящимся занять первое место в списке очков, нужны лыжи, обладающие функциями профессиональный моделей. Это Redster G9 FIS Revoshock S. Они оснащены Revoshock от Atomic, выигравшим чемпионат мира, — серией пластин из пружинной стали, встроенных в интегрированную эластомерную конструкцию, которая поглощает неровности на трассе, обеспечивая стабильную езду с резкими ускорениями на выходе из поворотов. Полноразмерные боковые стенки и ламинат Atomic Ultra Titanium Powered обеспечивают высочайший уровень цепкости кантов и жесткость на скручивание. Ultra Power Woodcore работает вместе с платформой Active Race Interface, чтобы передавать все ваши движения сразу в лыжи, которые реагируют со скоростью мысли. Redster G9 FIS Revoshock S пролетают сквозь ворота, стабильны на скорости и наверняка поднимут вас на подиум.
Размеры: 180
Функции
Atom
Указатель на объект atomic , который хранит значение типа Ty .
Exp
Указатель на значение типа Ty .
Value
Значение типа Ty .
Возвращаемое значение
true Значение , если значения равны, в противном случае false .
Замечания
Этот метод выполняет атомарную операцию сравнения и обмена с помощью неявных memory_order.memory_order_seq_cst аргументов. Дополнительные сведения см. в разделе atomic_compare_exchange_strong_explicit .
atomic_compare_exchange_strong_explicit
atomic compare and exchange Выполняет операцию.
template inline bool atomic_compare_exchange_strong_explicit( volatile atomic* Atom, Ty* Exp, Ty Value, memory_order Order1, memory_order Order2) noexcept; template inline bool atomic_compare_exchange_strong_explicit( atomic* Atom, Ty* Exp, Ty Value, memory_order Order1, memory_order Order2) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит значение типа Ty .
Exp
Указатель на значение типа Ty .
Value
Значение типа Ty .
Order2
Второй аргумент memory_order . Значение Order2 не может быть memory_order_release или memory_order_acq_rel , и оно не может быть надежнее, чем значение Order1 .
Возвращаемое значение
true Значение , если значения равны, в противном случае false .
Замечания
Объект atomic compare and exchange operation сравнивает значение, хранящееся в объекте, на которое указывает Atom значение, на которое указывает Exp значение. Если значения равны, то значение, хранящееся в объекте, на которое указывает Atom , заменяется Value с помощью операции чтения и изменения записи и применения ограничений порядка памяти, указанных в Order1 них. Если значения не равны, операция заменяет значение, указываемое Exp на значение, хранящееся в объекте, на которое указывает Atom и применяет ограничения порядка памяти, указанные в Order2 них.
atomic_compare_exchange_weak
Выполняет слабую атомарную операцию сравнения и обмена.
template inline bool atomic_compare_exchange_strong( volatile atomic* Atom, Ty* Exp, Ty Value) noexcept; template inline bool atomic_compare_exchange_strong( atomic* Atom, Ty* Exp, Ty Value) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит значение типа Ty .
Exp
Указатель на значение типа Ty .
Value
Значение типа Ty .
Возвращаемое значение
true Значение , если значения равны, в противном случае false .
Замечания
Этот метод выполняет слабую атомарную операцию сравнения и обмена, которая имеет неявные memory_order.memory_order_seq_cst аргументы. Дополнительные сведения см. в разделе atomic_compare_exchange_weak_explicit .
atomic_compare_exchange_weak_explicit
Выполняет слабую атомарную операцию сравнения и обмена.
template inline bool atomic_compare_exchange_weak_explicit( volatile atomic* Atom, Ty* Exp, Ty Value, memory_order Order1, memory_order Order2) noexcept; template inline bool atomic_compare_exchange_weak_explicit( atomic* Atom, Ty* Exp, Ty Value, memory_order Order1, memory_order Order2) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит значение типа Ty .
Exp
Указатель на значение типа Ty .
Value
Значение типа Ty .
Order2
Второй аргумент memory_order . Значение Order2 не может быть memory_order_release или memory_order_acq_rel , и оно не может быть надежнее, чем значение Order1 .
Возвращаемое значение
true Значение , если значения равны, в противном случае false .
Замечания
Сильные и слабые вкусы atomic compare and exchange operation гарантии, что они не сохраняют новое значение, если ожидаемые и текущие значения не равны. Сильный вкус гарантирует, что он будет хранить новое значение, если ожидаемые и текущие значения равны. Слабый вкус иногда может возвращать false и не хранить новое значение, даже если текущие и ожидаемые значения равны. Другими словами, функция вернет false , но более поздний анализ ожидаемого значения может показать, что он не изменился, и поэтому должен был сравниться как равный.
atomic_exchange
Использует Value для замены сохраненного значения Atom .
template inline Ty atomic_exchange(volatile atomic* _Atom, Ty Value) noexcept; template inline T atomic_exchange(atomic* Atom, Ty Value) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит значение типа Ty .
Value
Значение типа Ty .
Возвращаемое значение
Сохраненное значение Atom до обмена.
Замечания
Функция atomic_exchange выполняет операцию чтения и изменения записи для обмена значением, хранящимся в Atom Value , с помощью memory_order.memory_order_seq_cst .
atomic_exchange_explicit
Заменяет значение, хранящееся в Atom , на Value .
template inline Ty atomic_exchange_explicit( volatile atomic* Atom, Ty Value, memory_order Order) noexcept; template inline Ty atomic_exchange_explicit( atomic* Atom, Ty Value, memory_order Order) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит значение типа Ty .
Value
Значение типа Ty .
Возвращаемое значение
Сохраненное значение Atom до обмена.
Замечания
Функция atomic_exchange_explicit выполняет операцию чтения и изменения записи для обмена значением, хранящимся в Atom Value пределах ограничений памяти, заданных Order .
atomic_fetch_add
Добавляет значение к существующему значению, хранящемуся в объекте atomic .
template T* atomic_fetch_add(volatile atomic* Atom, ptrdiff_t Value) noexcept; template T* atomic_fetch_add(atomic* Atom, ptrdiff_t Value) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит указатель на тип T .
Value
Значение типа ptrdiff_t .
Возвращаемое значение
Значение указателя, содержащегося atomic объектом непосредственно перед выполнением операции.
Замечания
Функция atomic_fetch_add выполняет операцию чтения и изменения записи для атомарного добавления Value в хранимое значение Atom с помощью memory_order.memory_order_seq_cst ограничения.
Когда атомарным типом является atomic_address , Value имеет тип ptrdiff_t , и операция считает, что тип сохраненного указателя — char * .
Эта операция также перегружается для целочисленных типов:
integral atomic_fetch_add(volatile atomic-integral* Atom, integral Value) noexcept; integral atomic_fetch_add(atomic-integral* Atom, integral Value) noexcept; atomic_fetch_add_explicit
Добавляет значение к существующему значению, хранящемуся в объекте atomic .
template T* atomic_fetch_add_explicit( volatile atomic* Atom, ptrdiff_t Value, memory_order Order) noexcept; template T* atomic_fetch_add_explicit( atomic* Atom, ptrdiff_t Value, memory_order Order) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит указатель на тип T .
Value
Значение типа ptrdiff_t .
Возвращаемое значение
Значение указателя, содержащегося atomic объектом непосредственно перед выполнением операции.
Замечания
Функция atomic_fetch_add_explicit выполняет операцию чтения и изменения записи для атомарного добавления Value в хранимое значение в Atom memory_order пределах ограничений, указанных в Order .
Когда атомарным типом является atomic_address , Value имеет тип ptrdiff_t , и операция считает, что тип сохраненного указателя — char * .
Эта операция также перегружается для целочисленных типов:
integral atomic_fetch_add_explicit( volatile atomic-integral* Atom, integral Value, memory_order Order) noexcept; integral atomic_fetch_add_explicit( atomic-integral* Atom, integral Value, memory_order Order) noexcept; atomic_fetch_and
Выполняет побитовую операцию & со значением и существующим значением, хранящимся в объекте atomic .
template inline T atomic_fetch_and(volatile atomic* Atom, T Value) noexcept; template inline T atomic_fetch_and(volatile atomic* Atom, T Value) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит значение типа T .
Value
Значение типа T .
Возвращаемое значение
Значение, содержащееся atomic объектом непосредственно перед выполнением операции.
Замечания
Функция atomic_fetch_and выполняет операцию чтения и изменения записи для замены хранимого значения Atom битовой & Value и текущего значения, хранящегося в Atom , с помощью memory_order.memory_order_seq_cst ограничения.
atomic_fetch_and_explicit
Выполняет побитовую операцию & со значением и существующим значением, хранящимся в объекте atomic .
template inline T atomic_fetch_and_explicit( volatile atomic* Atom, T Value, memory_order Order) noexcept; template inline T atomic_fetch_and_explicit( volatile atomic* Atom, T Value, memory_order Order) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит значение типа T .
Value
Значение типа T .
Возвращаемое значение
Значение, содержащееся atomic объектом непосредственно перед выполнением операции.
Замечания
Функция atomic_fetch_and_explicit выполняет операцию чтения и изменения записи, чтобы заменить хранимое значение Atom побитовой & Value и текущее значение, хранящееся в Atom пределах ограничений памяти, указанных в Order .
atomic_fetch_or
Выполняет побитовую операцию or со значением и существующим значением, хранящимся в объекте atomic .
template inline T atomic_fetch_or (volatile atomic* Atom, T Value) noexcept; template inline T atomic_fetch_or (volatile atomic* Atom, T Value) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит значение типа T .
Value
Значение типа T .
Возвращаемое значение
Значение, содержащееся atomic объектом непосредственно перед выполнением операции.
Замечания
Функция atomic_fetch_or выполняет операцию чтения и изменения записи, чтобы заменить хранимое значение Atom побитовой or Value и текущее значение, хранящееся в Atom , с помощью memory_order.memory_order_seq_cst .
atomic_fetch_or_explicit
Выполняет побитовую операцию or со значением и существующим значением, хранящимся в объекте atomic .
template inline T atomic_fetch_or_explicit( volatile atomic* Atom, T Value, memory_order Order) noexcept; template inline T atomic_fetch_or_explicit( volatile atomic* Atom, T Value, memory_order Order) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит значение типа T .
Value
Значение типа T .
Возвращаемое значение
Значение, содержащееся atomic объектом непосредственно перед выполнением операции.
Замечания
Функция atomic_fetch_or_explicit выполняет операцию чтения и изменения записи, чтобы заменить хранимое значение Atom побитовой or Value и текущее значение, хранящееся в Atom пределах ограничений, memory_order указанных в Order .
atomic_fetch_sub
Вычитает значение из существующего значения, хранящегося в объекте atomic .
template T* atomic_fetch_sub( volatile atomic* Atom, ptrdiff_t Value) noexcept; template T* atomic_fetch_sub( atomic* Atom, ptrdiff_t Value) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит указатель на тип T .
Value
Значение типа ptrdiff_t .
Возвращаемое значение
Значение указателя, содержащегося atomic объектом непосредственно перед выполнением операции.
Замечания
Функция atomic_fetch_sub выполняет операцию чтения и изменения записи для атомарного вычитания Value из сохраненного memory_order.memory_order_seq_cst значения Atom с помощью ограничения.
Когда атомарным типом является atomic_address , Value имеет тип ptrdiff_t , и операция считает, что тип сохраненного указателя — char * .
Эта операция также перегружается для целочисленных типов:
integral atomic_fetch_sub(volatile atomic-integral* Atom, integral Value) noexcept; integral atomic_fetch_sub(atomic-integral* Atom, integral Value) noexcept; atomic_fetch_sub_explicit
Вычитает значение из существующего значения, хранящегося в объекте atomic .
template T* atomic_fetch_sub_explicit( volatile atomic* Atom, ptrdiff_t Value, memory_order Order) noexcept; template T* atomic_fetch_sub_explicit( atomic* Atom, ptrdiff_t Value, memory_order Order) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит указатель на тип T .
Value
Значение типа ptrdiff_t .
Возвращаемое значение
Значение указателя, содержащегося atomic объектом непосредственно перед выполнением операции.
Замечания
Функция atomic_fetch_sub_explicit выполняет операцию чтения и изменения записи для атомарного вычитания Value из сохраненного значения в Atom memory_order пределах ограничений, указанных в Order .
Когда атомарным типом является atomic_address , Value имеет тип ptrdiff_t , и операция считает, что тип сохраненного указателя — char * .
Эта операция также перегружается для целочисленных типов:
integral atomic_fetch_sub_explicit( volatile atomic-integral* Atom, integral Value, memory_order Order) noexcept; integral atomic_fetch_sub_explicit( atomic-integral* Atom, integral Value, memory_order Order) noexcept; atomic_fetch_xor
Выполняет побитовую операцию exclusive or со значением и существующим значением, хранящимся в объекте atomic .
template inline T atomic_fetch_xor(volatile atomic* Atom, T Value) noexcept; template inline T atomic_fetch_xor(volatile atomic* Atom, T Value) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит значение типа T .
Value
Значение типа T .
Возвращаемое значение
Значение, содержащееся atomic объектом непосредственно перед выполнением операции.
Замечания
Функция atomic_fetch_xor выполняет операцию чтения и изменения записи, чтобы заменить хранимое значение Atom побитовой exclusive or Value и текущее значение, хранящееся в Atom , с помощью memory_order.memory_order_seq_cst .
atomic_fetch_xor_explicit
Выполняет побитовое exclusive or значение и существующее значение, хранящееся в объекте atomic .
template inline T atomic_fetch_xor_explicit( volatile atomic* Atom, T Value, memory_order Order) noexcept; template inline T atomic_fetch_xor_explicit( volatile atomic* Atom, T Value, memory_order Order) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит значение типа T .
Value
Значение типа T .
Возвращаемое значение
Значение, содержащееся atomic объектом непосредственно перед выполнением операции.
Замечания
Функция atomic_fetch_xor_explicit выполняет операцию чтения и изменения записи для замены хранимого значения Atom побитовой exclusive or Value и текущего значения, memory_order хранящегося в Atom ограничениях, указанных в Order .
atomic_flag_clear
bool Задает флаг в объекте atomic_flag false в пределах объекта memory_order.memory_order_seq_cst .
inline void atomic_flag_clear(volatile atomic_flag* Flag) noexcept; inline void atomic_flag_clear(atomic_flag* Flag) noexcept; Параметры
Flag
Указатель на объект atomic_flag .
atomic_flag_clear_explicit
bool Задает флаг в объекте atomic_flag false в пределах указанных memory_order ограничений.
inline void atomic_flag_clear_explicit(volatile atomic_flag* Flag, memory_order Order) noexcept; inline void atomic_flag_clear_explicit(atomic_flag* Flag, memory_order Order) noexcept; Параметры
Flag
Указатель на объект atomic_flag .
atomic_flag_test_and_set
bool Задает флаг в atomic_flag объекте true в пределах ограничений объекта memory_order.memory_order_seq_cst .
inline bool atomic_flag_test_and_set(volatile atomic_flag* Flag,) noexcept; inline bool atomic_flag_test_and_set(atomic_flag* Flag,) noexcept; Параметры
Flag
Указатель на объект atomic_flag .
Возвращаемое значение
Начальное значение Flag .
atomic_flag_test_and_set_explicit
bool Задает флаг в объекте atomic_flag true в пределах указанных memory_order ограничений.
inline bool atomic_flag_test_and_set_explicit(volatile atomic_flag* Flag, memory_order Order) noexcept; inline bool atomic_flag_test_and_set_explicit(atomic_flag* Flag, memory_order Order) noexcept; Параметры
Flag
Указатель на объект atomic_flag .
Возвращаемое значение
Начальное значение Flag .
atomic_init
Задает сохраненное значение в объекте atomic .
template inline void atomic_init(volatile atomic* Atom, Ty Value) noexcept; template inline void atomic_init(atomic* Atom, Ty Value) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит значение типа Ty .
Value
Значение типа Ty .
Замечания
atomic_init не является атомарной операцией. Это не является потокобезопасной.
atomic_is_lock_free
Указывает, являются ли операции с объектом atomic неблокирующими.
template inline bool atomic_is_lock_free(const volatile atomic* Atom) noexcept; template inline bool atomic_is_lock_free(const atomic* Atom) noexcept; Параметры
Atom
Указатель на объект atomic , который хранит значение типа T .
Возвращаемое значение
Значение true , если атомарные операции с Atom являются неблокирующими; в противном случае — значение false .
Замечания
Атомарный тип является неблокирующим, если никакие атомарные операции с этим типом не используют блокировки. Если эта функция возвращается true , тип безопасно используется в обработчиках сигналов.
atomic_load
Извлекает сохраненное значение в объект atomic .
template inline Ty atomic_load(const volatile atomic* Atom) noexcept; template inline Ty atomic_load(const atomic* Atom) noexcept; Параметры
Atom
Указатель на объект atomic , который содержит значение типа Ty .
Возвращаемое значение
Извлеченное значение, которое хранится в Atom .
Замечания
atomic_load_explicit
Извлекает хранимое значение в объекте в atomic пределах указанного memory_order объекта.
template inline Ty atomic_load_explicit(const volatile atomic* Atom, memory_order Order) noexcept; template inline Ty atomic_load_explicit(const atomic* Atom, memory_order Order) noexcept; Параметры
Atom
Указатель на объект atomic , который содержит значение типа Ty .
Order
memory_order . Не используйте memory_order_release memory_order_acq_rel .
Возвращаемое значение
Извлеченное значение, которое хранится в Atom .
atomic_signal_fence
Выступает в качестве забора — примитив синхронизации памяти, который применяет порядок между операциями загрузки и хранения — между другими заборами в вызывающем потоке с обработчиками сигналов, выполняемыми в одном потоке.
inline void atomic_signal_fence(memory_order Order) noexcept; Параметры
Order
Ограничение порядка памяти, которое определяет тип границы.
Замечания
Аргумент Order определяет тип границы.
| значение | Description |
|---|---|
| memory_order_relaxed | Граница не действует. |
| memory_order_consume | Граница является границей получения. |
| memory_order_acquire | Граница является границей получения. |
| memory_order_release | Граница является границей выпуска. |
| memory_order_acq_rel | Граница является и границей получения, и границей выпуска. |
| memory_order_seq_cst | Граница является и границей получения, и границей выпуска, и она также последовательно согласованная. |
atomic_store
Атомарно сохраняет значение в объекте atomic .
template inline Ty atomic_store_explicit(const volatile atomic* Atom, Ty Value) noexcept; template inline Ty atomic_store_explicit(const atomic* Atom, T Value) noexcept; Параметры
Atom
Указатель на объект atomic , который содержит значение типа Ty .
Value
Значение типа Ty .
Замечания
atomic_store хранится Value в объекте, на который указывает Atom memory_order.memory_order_seq_cst ограничение.
atomic_store_explicit
Атомарно сохраняет значение в объекте atomic .
template inline Ty atomic_store_explicit( const volatile atomic* Atom, Ty Value, memory_order Order) noexcept; template inline Ty atomic_store_explicit( const atomic* Atom, T Value, memory_order Order) noexcept; Параметры
Atom
Указатель на объект atomic , который содержит значение типа Ty .
Value
Значение типа Ty .
Order
memory_order . Не используйте memory_order_consume , memory_order_acquire или memory_order_acq_rel .
Замечания
atomic_store хранит Value в объекте, указанном Atom , с соблюдением ограничений memory_order , заданных с помощью Order .
atomic_thread_fence
Выступает в качестве забора — примитив синхронизации памяти, который обеспечивает упорядочение между операциями загрузки и хранения без связанной атомарной операции.
inline void atomic_thread_fence(memory_order Order) noexcept; Параметры
Order
Ограничение порядка памяти, которое определяет тип границы.
Замечания
Аргумент Order определяет тип границы.
| значение | Description |
|---|---|
| memory_order_relaxed | Граница не действует. |
| memory_order_consume | Граница является границей получения. |
| memory_order_acquire | Граница является границей получения. |
| memory_order_release | Граница является границей выпуска. |
| memory_order_acq_rel | Граница является и границей получения, и границей выпуска. |
| memory_order_seq_cst | Граница является и границей получения, и границей выпуска, и она также последовательно согласованная. |
kill_dependency
template Ty kill_dependency(Ty Arg) noexcept; Параметры
Arg
Значение типа Ty .
Возвращаемое значение
Возвращается значение Arg . Вычисление Arg не содержит зависимость для вызова функции. Разбивая возможную цепочку зависимостей, функция позволяет компилятору создавать более эффективный код.
std::atomic. Модель памяти C++ в примерах
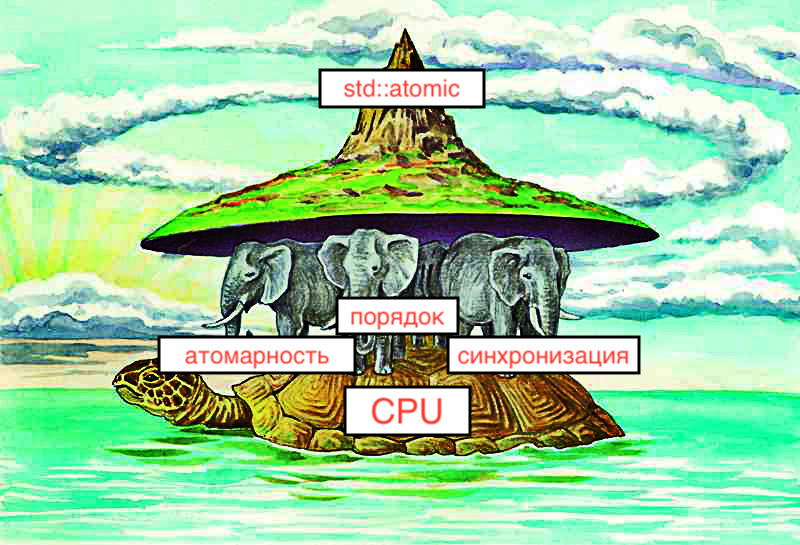
Для написания эффективных и корректных многопоточных приложений очень важно знать какие существуют механизмы синхронизации памяти между потоками исполнения, какие гарантии предоставляют элементы многопоточного программирования, такие как мьютекс, join потока и другие. Особенно это касается модели памяти C++, которая была создана сложной таковой, чтобы обеспечивать оптимальный многопоточный код под множество архитектур процессоров. Кстати, язык программирования Rust, будучи построенным на LLVM, использует модель памяти такую же, как в C++. Поэтому материал в этой статье будет полезен программистам на обоих языках. Но все примеры будут на языке C++. Я буду рассказывать про std::atomic , std::memory_order и на каких трех слонах стоят атомики.
В стандарте C++11 появилась возможность писать многопоточные программы на C++, используя только стандартные средства языка. В то время многоядерные процессоры уже завоевали рынок. Особенность выполнения программы на многоядерном процессоре в том, что инструкции программы из разных потоков физически могут исполняться одновременно. Ранее многопоточность на одном ядре эмулировалась частым переключением контекста исполнения с одного потока на последующие. Для оптимизации работы с памятью у каждого ядра имеется его личный кэш памяти, над ним стоит общий кэш памяти процессора, далее оперативная память. Задача синхронизации памяти между ядрами — поддержка консистентного представления данных на каждом ядре (читай в каждом потоке). Очевидно, что если применить строгую упорядоченность изменений памяти, то операции на разных ядрах уже не будут выполнятся параллельно: остальные ядра будут ожидать, когда одно ядро выполнит инструкции изменения данных. Поэтому процессоры поддерживают работу с памятью с менее строгими гарантиями консистентности памяти. Более того, разработчику программы предоставляется выбор, какие гарантии по доступу к памяти из разных потоков требуются для достижения максимальной корректности и производительности многопоточной программы. Задача предоставить разные гарантии по памяти решалась по-разному для разных архитектур процессоров. Наиболее популярные архитектуры x86-64 и ARM имеют разные представления о том, как синхронизировать память.
Язык C++ компилируется под множество архитектур, поэтому в вопросе синхронизации данных между потоками в С++11 была добавлена модель памяти, которая обобщает механизмы синхронизации различных архитектур, позволяя генерировать для каждого процессора оптимальный код с необходимой степенью синхронизации.
Отсюда следует несколько важных выводов: модель синхронизации памяти C++ — это «искусственные» правила, которые учитывают особенности различных архитектур процессоров. В модели C++ некоторые конструкции, описанные стандартом как undefined behavior (UB), могут корректно работать на одной архитектуре, но приводить к ошибкам работы с памятью на других архитектурах.
Наша задача, как разработчиков на языке C++, состоит в том, чтобы писать корректный с точки зрения стандарта языка код. В этом случае мы можем быть уверены, что для каждой платформы будет сгенерирован корректный машинный код.
Код каждого потока компилируется и выполняется так, как будто он один в программе. Вся синхронизация данных между потоками возложена на плечи атомиков ( std::atomic ), т.к. именно они предоставляют возможность форсировать «передачу» изменений данных в другой поток. Далее я покажу, что мьютексы ( std::mutex ) и другие многопоточные примитивы либо реализованы на атомиках, либо предоставляют гарантии, семантически похожие на атомарные операции. Поэтому ключом к написанию корректных многопоточных программ является понимание того, как конкретно работают атомики.
Три слона
На мой взгляд, основная проблема с атомиками в C++ состоит в том, что они несут сразу три функции. Так на каких же трех слонах держатся атомики?
- Атомики позволяют реализовать… атомарные операции.
- Атомики накладывают ограничения на порядок выполнения операций с памятью в одном потоке.
- Синхронизируют память в двух и более потоках выполнения.
Атомарная операция — это операция, которую невозможно наблюдать в промежуточном состоянии, она либо выполнена либо нет. Атомарные операции могут состоять из нескольких операций. Если говорить про тип std::atomic, то он предоставляет ряд примитивных операций: load , store , fetch_add , compare_exchange_* и другие. Последние две операции — это read-modify-write операции, атомарность которых обеспечивается специальными инструкциями процессора.
Рассмотрим простой пример read-modify-write операции, а именно прибавление к числу единицы. Пример 0, link:
static int v1 = 0; static std::atomic v2< 0 >; int add_v1() < return ++v1; /* Generated x86-64 assembly: mov eax, DWORD PTR v1[rip] add eax, 1 mov DWORD PTR v1[rip], eax */ >int add_v2() < return v2.fetch_add(1); /* Generated x86-64 assembly: mov eax, 1 lock xadd DWORD PTR _ZL2v2[rip], eax */ >В случае с обычной переменной v1 типа int имеем три отдельных операций: read-modify-write. Нет гарантий, что другое ядро процессора не выполняет другой операции над v1 . Операция над v2 в машинных кодах представлена как одна операция с lock сигналом на уровне процессора, гарантирующим, что к кэш линии, в которой лежит v2 , эксклюзивно имеет доступ только ядро, выполняющее эту инструкцию.
Про ограничения на порядок выполнения операций. Когда мы пишем код программы, то предполагаем, что операторы языка будут выполнены последовательно. В реальности же компилятор и в особенности процессор могут переупорядочить команды программы с целью оптимизации. Они это делают с учетом ограничений на порядок записи и чтения в локацию памяти. Например, чтение из локации памяти должно происходить после записи, эти операции нельзя переупорядочить. Применение атомарных операций может накладывать дополнительные ограничения на возможные переупорядочивания операций с памятью.
Про синхронизацию данных между потоками. Если мы хотим изменить данные в одном потоке и сделать так, чтобы эти изменения были видны в другом потоке, то нам необходимы примитивы многопоточного программирования. Фундаментальным таким примитивом являются атомики, остальные, например мьютексы, либо реализованы на основе атомиков, либо повторяют семантику атомиков. Все попытки записывать и читать одни и те же данные из разных потоков без примитивов синхронизации могут приводить к UB.
Случаи, когда синхронизация памяти не требуется:
- Если все потоки, работающие с одним участком памяти, используют ее только на чтение
- Если разные потоки используют эксклюзивно разные участки памяти
Далее будет рассмотрены более сложные случаи, когда требуется чтение и запись одного участка памяти из разных потоков. Язык C++ предоставляет три способа синхронизации памяти. По мере возрастания строгости: relaxed , release/acquire и sequential consistency . Рассмотрим их.
Неделимый, но расслабленный
Самый простой для понимания флаг синхронизации памяти — relaxed . Он гарантирует только свойство атомарности операций, при этом не может участвовать в процессе синхронизации данных между потоками. Свойства:
- модификация переменной «появится» в другом потоке не сразу
- поток thread2 «увидит» значения одной и той же переменной в том же порядке, в котором происходили её модификации в потоке thread1
- порядок модификаций разных переменных в потоке thread1 не сохранится в потоке thread2
Можно использовать relaxed модификатор в качестве счетчика. Пример 1, link:
std::atomic counter< 0 >; // process can be called from different threads void process(Request req) < counter.fetch_add(1, std::memory_order_relaxed); // . >void print_metrics() < std::cout Использование в качестве флага остановки. Пример 2, link:
std::atomic stopped< false >; void thread1() < while (!stopped.load(std::memory_order_relaxed)) < // . >> void stop_thread1()
В данном примере не важен порядок в котором thread1 увидит изменения из потока, вызывающего stop_thread1 . Также не важно то, чтобы thread1 мгновенно (синхронно) увидел выставление флага stopped в true .
Пример неверного использования relaxed в качестве флага готовности данных. Пример 3, link:
std::string data; std::atomic ready< false >; void thread1() < data = "very important bytes"; ready.store(true, std::memory_order_relaxed); >void thread2() < while (!ready.load(std::memory_order_relaxed)); std::cout Тут нет гарантий, что поток thread2 увидит изменения data ранее, чем изменение флага ready , т.к. синхронизацию памяти флаг relaxed не обеспечивает.
Полный порядок
Флаг синхронизации памяти "единая последовательность" (sequential consistency, seq_cst ) дает самые строгие. Его свойства:
- порядок модификаций разных атомарных переменных в потоке thread1 сохранится в потоке thread2
- все потоки будут видеть один и тот же порядок модификации всех атомарных переменных. Сами модификации могут происходить в разных потоках
- все модификации памяти (не только модификации над атомиками) в потоке thread1 , выполняющей store на атомарной переменной, будут видны после выполнения load этой же переменной в потоке thread2
Таким образом можно представить seq_cst операции, как барьеры памяти, в которых состояние памяти синхронизируется между всеми потоками программы.
Этот флаг синхронизации памяти в C++ используется по умолчанию, т.к. с ним меньше всего проблем с точки зрения корректности выполнения программы. Но seq_cst является дорогой операцией для процессоров, в которых вычислительные ядра слабо связаны между собой в плане механизмов обеспечения консистентности памяти. Например, для x86-64 seq_cst дешевле, чем для ARM архитектур.
Продемонстрируем второе свойство. Пример 4, из книги [1], link:
std::atomic x, y; std::atomic z; void thread_write_x() < x.store(true, std::memory_order_seq_cst); >void thread_write_y() < y.store(true, std::memory_order_seq_cst); >void thread_read_x_then_y() < while (!x.load(std::memory_order_seq_cst)); if (y.load(std::memory_order_seq_cst)) < ++z; >> void thread_read_y_then_x() < while (!y.load(std::memory_order_seq_cst)); if (x.load(std::memory_order_seq_cst)) < ++z; >>После того, как все четыре потока отработают, значение переменной z будет равно 1 или 2 , потому что потоки thread_read_x_then_y и thread_read_y_then_x "увидят" изменения x и y в одном и том же порядке. От запуска к запуску это могут быть: сначала x = true , потом y = true , или сначала y = true , потом x = true .
Модификатор seq_cst всегда может быть использован вместо relaxed и acquire/release , еще и поэтому он является модификатором по умолчанию. Удобно использовать seq_cst для отладки проблем, связанных с гонкой данных в многопоточной программе: добиваемся корректной работы программы и далее заменяем seq_cst на менее строгие флаги синхронизации памяти. Примеры 1 и 2 также будут корректно работать, если заменить relaxed на seq_cst , а пример 3 начнет работать корректно после такой замены.
Синхронизация пары. Acquire/Release
Флаг синхронизации памяти acquire/release является более тонким способом синхронизировать данные между парой потоков. Два ключевых слова: memory_order_acquire и memory_order_release работают только в паре над одним атомарным объектом. Рассмотрим их свойства:
- модификация атомарной переменной с release будет видна видна в другом потоке, выполняющем чтение этой же атомарной переменной с acquire
- все модификации памяти в потоке thread1 , выполняющей запись атомарной переменной с release , будут видны после выполнения чтения той же переменной с acquire в потоке thread2
- процессор и компилятор не могут перенести операции записи в память раньше release операции в потоке thread1 , и нельзя перемещать выше операции чтения из памяти позже acquire операции в потоке thread2
Важно понимать, что нет полного порядка между операциями над разными атомиками, происходящих в разных потоках. Например, в примере 4 если все операции store заменить на memory_order_release , а операции load заменить на memory_order_acquire , то значение z после выполнения программы может быть равно 0, 1 или 2. Это связано с тем, что, независимо от того в каком порядке по времени выполнения выполнены store для x и y , потоки thread_read_x_then_y и thread_read_y_then_x могут увидеть эти изменения в разных порядках. Кстати, такими же изменениями для load и store можно исправить пример 3. Такое изменение будет корректным и производительными, т.к. тут нам не требуется единый порядок изменений между всеми потоками (как в случае с seq_cst ), а требуется синхронизировать память между двумя потоками.
Используя release , мы даем инструкцию, что данные в этом потоке готовы для чтения из другого потока. Используя acquire , мы даем инструкцию "подгрузить" все данные, которые подготовил для нас первый поток. Но если мы делаем release и acquire на разных атомарных переменных, то получим UB вместо синхронизации памяти.
Рассмотрим реализацию простейшего мьютекса, который ожидает в цикле сброса флага для того, чтобы получить lock . Такой мьютекс называют spinlock . Это не самый эффективный способ реализации мьютекса, но он обладает всеми нужными свойствами, на которые я хочу обратить внимание. Пример 5, link:
class mutex < public: void lock() < bool expected = false; while(!_locked.compare_exchange_weak(expected, true, std::memory_order_acquire)) < expected = false; >> void unlock() < _locked.store(false, std::memory_order_release); >private: std::atomic _locked; >;Функция lock() непрерывно пробует сменить значение с false на true с модификатором синхронизации памяти acquire . Разница между compare_exchage_weak и strong незначительна, про нее можно почитать на cppreference. Функция unlock() выставляет значение в false с синхронизацией release . Обратите внимание, что мьютекс не только обеспечивает эксклюзивным доступ к блоку кода, который он защищает. Он также делает доступным те изменения памяти, которые были сделаны до вызова unlock() в коде, который будет работать после вызова lock() . Это важное свойство. Иногда может сложиться ошибочное мнение, что мьютекс в конкретном месте не нужен.
Рассмотрим такой пример, называемый Double Checked Locking Anti-Pattern из [2]. Пример 6, link:
struct Singleton < // . >; static Singleton* singleton = nullptr; static std::mutex mtx; static bool initialized = false; void lazy_init() < if (initialized) // early return to avoid touching mutex every call return; std::unique_lock l(mtx); // `mutex` locks here (acquire memory) if (!initialized) < singleton = new Singleton(); initialized = true; >// `mutex` unlocks here (release memory) >Идея проста: хотим единожды в рантайме инициализировать объект Singleton . Это нужно сделать потокобезопасно, поэтому имеем мьютекс и флаг инициализации. Т.к. создается объект единожды, а используется singleton указатель в read-only режиме всю оставшуюся жизнь программы, то кажется разумным добавить предварительную проверку if (initialized) return . Данный код будет корректно работать на архитектурах процессора с более строгими гарантиями консистентности памяти, например в x86-64. Но данный код неверный с точки зрения стандарта C++. Давайте рассмотрим такой сценарий использования:
void thread1() < lazy_init(); singleton->do_job(); > void thread2() < lazy_init(); singleton->do_job(); >Рассмотрим следующую последовательность действий во времени:
1. сначала отрабатывает thread1 -> выполняет инициализацию под мьютексом:
- lock мьютекса ( acquire )
- singleton = ..
- initialized = true
- unlock мьютекса ( release )
2. далее в игру вступает thread2 :
- if(initalized) возвращает true (память, где содержится initialized могла быть неявно синхронизирована между ядрами процессора)
- singleton->do_job() приводит к segmentation fault (указатель singleton не обязан был быть синхронизирован с потоком thread1 )
Этот случай интересен тем, что наглядно показывает роль мьютекса не только как примитива синхронизации потока выполнения, но и синхронизации памяти.
Семантика acquire/release классов стандартной библиотеки
Механизм acquire/release поможет понять гарантии синхронизации памяти, которые предоставляют классы стандартной библиотеки для работы с потоками. Ниже приведу список наиболее часто используемых операций.
std::thread::(constructor) vs функция потока
Вызов конструктора объекта std::thread ( release ) синхронизирован со стартом работы функции нового потока ( acquire ). Таким образом функция потока будет видеть все изменения памяти, которые произошли до вызова конструктора в исходном потоке.
std::thread::join vs владеющий поток
После успешного вызова join поток, в котором был вызван join, "увидит" все изменения памяти, которые были выполнены завершившимся потоком.
std::mutex::lock vs std::mutex::unlock
успешный lock синхронизирует память, которая была изменена до вызова предыдущего unlock.
std::promise::set_value vs std::future::wait
set_value синхронизирует память с успешным wait .
И так далее. Полный список можно найти в книге [1].
Что это все значит? Повторю эту важную мысль еще раз: это значит, на примере std::promise::set_value и std::future::wait , что тут мы не только получили данные, которые содержатся в примитиве синхронизации, но и нам доступны все изменения памяти, которые были в потоке до того, как он выполнил set_value . Это маленькое чудо нам кажется само собой разумеющееся с нашим бытовым, последовательным причинно-следственным, взглядом на мир. Но в мире многоядерного процессора, законы которого больше похожи на квантовую физику, которую никто до конца не понимает, нет единого последовательно порядка изменения памяти в разных ядрах процессора, если это не затребовано разработчиком явно, или неявно через многопоточные примитивы.
Заключение
Сложно представить современную C++ программу, которая была бы однопоточной. Опасно писать многопоточные программы, не имея представления о правилах синхронизации памяти. Я считаю, что нужно знать, как работают атомики в C++. Чтобы не совершать ошибок типа volatile bool , чтобы понимать, какие изменения в каких потоках будут видны после использования того или иного многопоточного примитива, чтобы использовать read-modify-write атомарные операции вместо мьютекса, там где это возможно. Данная статья помогла мне систематизировать материал, который я находил в разных источниках и освежить знания в памяти. Надеюсь, она поможет и вам!