Методы HTTP запроса
HTTP определяет множество методов запроса, которые указывают, какое желаемое действие выполнится для данного ресурса. Несмотря на то, что их названия могут быть существительными, эти методы запроса иногда называются HTTP глаголами. Каждый реализует свою семантику, но каждая группа команд разделяет общие свойства: так, методы могут быть безопасными, идемпотентными или кешируемыми.
Метод GET запрашивает представление ресурса. Запросы с использованием этого метода могут только извлекать данные.
HEAD запрашивает ресурс так же, как и метод GET, но без тела ответа.
POST используется для отправки сущностей к определённому ресурсу. Часто вызывает изменение состояния или какие-то побочные эффекты на сервере.
PUT заменяет все текущие представления ресурса данными запроса.
DELETE удаляет указанный ресурс.
CONNECT устанавливает «туннель» к серверу, определённому по ресурсу.
OPTIONS используется для описания параметров соединения с ресурсом.
TRACE выполняет вызов возвращаемого тестового сообщения с ресурса.
PATCH используется для частичного изменения ресурса.
Спецификации
| Спецификация | Название | Комментарий |
|---|---|---|
| RFC 7231, раздел 4: Request methods | Hypertext Transfer Protocol (HTTP/1.1): Semantics and Content | Определение GET, HEAD, POST, PUT, DELETE, CONNECT, OPTIONS, TRACE. |
| RFC 5789, раздел 2: Patch method | PATCH метод для HTTP | Определение PATCH. |
Совместимость с браузерами
BCD tables only load in the browser
Смотрите также
Found a content problem with this page?
- Edit the page on GitHub.
- Report the content issue.
- View the source on GitHub.
This page was last modified on 7 авг. 2023 г. by MDN contributors.
Your blueprint for a better internet.
MDN
Support
- Product help
- Report an issue
Our communities
Developers
- Web Technologies
- Learn Web Development
- MDN Plus
- Hacks Blog
- Website Privacy Notice
- Cookies
- Legal
- Community Participation Guidelines
Visit Mozilla Corporation’s not-for-profit parent, the Mozilla Foundation.
Portions of this content are ©1998– 2024 by individual mozilla.org contributors. Content available under a Creative Commons license.
Ультимативный гайд по HTTP. Структура запроса и ответа
Привет! Меня зовут Ивасюта Алексей, я техлид команды Bricks в Авито в кластере Architecture. Я решил написать цикл статей об истории и развитии HTTP, рассмотреть каждую из его версий и проблемы, которые они решали и решают сейчас.
Весь современный веб построен на протоколе HTTP. Каждый сайт использует его для общения клиента с сервером. Между собой сервера тоже часто общаются по этому протоколу. На данный момент существует четыре его версии и все они до сих пор используются. Поэтому статьи будут полезны инженерам любых уровней и специализаций, и помогут систематизировать знания об этой важной технологии.
Что такое HTTP
HTTP — это гипертекстовый протокол передачи данных прикладного уровня в сетевой модели OSI. Его представил миру Тим Бернерс-Ли в марте 1991 года. Главная особенность HTTP — представление всех данных в нём в виде простого текста. Через HTTP разные узлы в сети общаются между собой. Модель клиент-серверного взаимодействия классическая: клиент посылает запрос серверу, сервер обрабатывает запрос и возвращает ответ клиенту. Полученный ответ клиент обрабатывает и решает: прекратить взаимодействие или продолжить отправлять запросы.
Ещё одна особенность: протокол не сохраняет состояние между запросами. Каждый запрос от клиента для сервера — отдельная транзакция. Когда поступают два соседних запроса, сервер не понимает, от одного и того же клиента они поступили, или от разных. Такой подход значительно упрощает построение архитектуры веб-серверов.
Как правило, передача данных по HTTP осуществляется через открытое TCP/IP-соединение 1 . Серверное программное обеспечение по умолчанию обычно использует TCP-порт 80 для работы веб-сервера, а порт 443 — для HTTPS-соединений.
HTTPS (HTTP Secure) — это надстройка над протоколом HTTP, которая поддерживает шифрование посредством криптографических протоколов SSL и TLS. Они шифруют отправляемые данные на клиенте и дешифруют их на сервере. Это защищает данные от чтения злоумышленниками, даже если им удастся их перехватить.
HTTP/0.9
В 1991 году была опубликована первая версия протокола с названием HTTP/0.9. Эта реализация была проста, как топор. От интернет-ресурса того времени требовалось только загружать запрашиваемую HTML-страницу и HTTP/0.9 справлялся с этой задачей. Обычный запрос к серверу выглядел так:
GET /http-spec.htmlВ протоколе был определен единственный метод GET и и указывался путь к ресурсу. Так пользователи получали страничку. После этого открытое соединение сразу закрывалось.
HTTP/1.0
Годы шли и интернет менялся. Стало понятно, что нужно не только получать странички от сервера, но и отправлять ему данные. В 1996 году вышла версия протокола 1.0.
Что изменилось:
- В запросе теперь надо было указывать версию протокола. Так сервер мог понимать, как обрабатывать полученные данные.
- В ответе от сервера появился статус завершения обработки запроса.
- К запросу и ответу добавился новый блок с заголовками.
- Добавили поддержку новых методов:
- HEAD запрашивает ресурс так же, как и метод GET, но без тела ответа. Так можно получить только заголовки, без самого ресурса.
- POST добавляет сущность к определённому ресурсу. Часто вызывает изменение состояния или побочные эффекты на сервере. Например, так можно отправить запрос на добавление нового поста в блог.
Структура запроса
Простой пример запроса:
GET /path HTTP/1.0 Content-Type: text/html; charset=utf-8 Content-Length: 4 X-Custom-Header: value testВ первой строчке указаны метод запроса — GET , путь к ресурсу — /path и версия протокола — HTTP/1.0 .
Далее идёт блок заголовков. Заголовки — это пары ключ: значение , каждая из которых записывается с новой строки и разделяется двоеточием. Они передают дополнительные данные и настройки от клиента к серверу и обратно.
HTTP — это текстовый протокол, поэтому и все данные передаются в виде текста. Заголовки можно отделить друг от друга только переносом строки. Нельзя использовать запятые, точку с запятой, или другие разделители. Всё, что идет после имени заголовка с двоеточием и до переноса строки, будет считаться значением заголовка 2 .
В примере серверу передали три заголовка:
- Content-Type — стандартный заголовок. Показывает, в каком формате будут передаваться данные в теле запроса или ответа.
- Content-Length — сообщает длину контента в теле запроса в байтах.
- X-Custom-Header — пользовательские заголовки, начинающиеся с X- с произвольными именем. Через них реализуется специфическая логика обработки для конкретного сервера. Если веб-сервер не поддерживает такие заголовки, то он проигнорирует их.
После блока заголовков идёт тело запроса, в котором передается текст test .
А так может выглядеть ответ от сервера:
HTTP/1.1 200 OK Date: Thu, 29 Jul 2021 19:20:01 GMT Content-Type: text/html; charset=utf-8 Content-Length: 2 Connection: close Server: gunicorn/19.9.0 Access-Control-Allow-Origin: * Access-Control-Allow-Credentials: true OKВ первой строке — версия протокола и статус ответа, например, 200 ОК . Далее идут заголовки ответа. После блока заголовков — тело ответа, в котором записан текст OK .
Статусы ответов
Клиенту зачастую недостаточно просто отправить запрос на сервер. Во многих случаях надо дождаться ответа и понять, как сервер обработал запрос. Для этого были придуманы статусы ответов. Это трёхзначные числовые коды с небольшими текстовыми обозначениями. Их можно увидеть в терминале или браузере. Сами коды делятся на 5 классов:
- Информационные ответы: коды 100–199
- Успешные ответы: коды 200–299
- Редиректы: коды 300–399
- Клиентские ошибки: коды 400–499
- Серверные ошибки: коды 500–599
Мы рассмотрим основные коды, которые чаще всего встречаются в реальных задачах. С остальными более подробно можно ознакомиться в реестре кодов состояния HTTP.
Информационные ответы
100 Continue — промежуточный ответ. Он указывает, что запрос успешно принят. Клиент может продолжать присылать запросы или проигнорировать этот ответ, если запрос был завершён.
Этот код ответа доступен с версии HTTP/1.1.
101 Switching Protocol присылается в ответ на запрос, в котором есть заголовок Upgrade. Это означает, что сервер переключился на протокол, который был указан в заголовке. Такая методика используется, например, для переключения на протокол Websocket.
102 Processing — запрос получен сервером, но его обработка ещё не завершена.
Успешные ответы
200 OK — запрос принят и корректно обработан веб-сервером.
201 Created — запрос корректно обработан и в результате был создан новый ресурс. Обычно он присылается в ответ на POST запрос.
Редиректы
301 Moved Permanently — запрашиваемый ресурс на постоянной основе переехал на новый адрес. Тогда новый путь к ресурсу указывается сервером в заголовке Location ответа.
Клиент может изменить метод последующего запроса с POST на GET.
302 Found — указывает, что целевой ресурс временно доступен по другому URl. Адрес перенаправления может быть изменен в любое время, а клиент должен продолжать использовать действующий URI для будущих запросов. Тогда временный путь к ресурсу указывается сервером в заголовке Location ответа.
Клиент может изменить метод последующего запроса с POST на GET.
307 Temporary Redirect — имеет то же значение, что и код 302, за исключением того, что клиент не может менять метод последующего запроса.
308 Permanent Redirect — имеет то же значение, что и код 301, за исключением того, что клиент не может менять метод последующего запроса.
Клиентские ошибки
400 Bad Request — запрос от клиента к веб-серверу составлен некорректно. Обычно это происходит, если клиент не передаёт необходимые заголовки или параметры.
401 Unauthorized — получение запрашиваемого ресурса доступно только аутентифицированным пользователям.
403 Forbidden — у клиента не хватает прав для получения запрашиваемого ресурса. Например, когда обычный пользователь сайта пытается получить доступ к панели администратора.
404 Not Found — сервер не смог найти запрашиваемый ресурс.
405 Method Not Allowed — сервер знает о существовании HTTP-метода, который был указан в запросе, но не поддерживает его. В таком случае сервер должен вернуть список поддерживаемых методов в заголовке Allow ответа.
Серверные ошибки
500 Internal Server Error — на сервере произошла непредвиденная ошибка.
501 Not Implemented — метод запроса не поддерживается сервером и не может быть обработан.
502 Bad Gateway — сервер, действуя как шлюз или прокси, получил недопустимый ответ от входящего сервера, к которому он обращался при попытке выполнить запрос.
503 Service Unavailable — сервер не готов обработать запрос (например, из-за технического обслуживания или перегрузки). Обратите внимание, что вместе с этим ответом должна быть отправлена удобная страница с объяснением проблемы. Этот ответ следует использовать для временных условий, а HTTP-заголовок Retry-After по возможности должен содержать расчётное время до восстановления службы.
504 Gateway Timeout — этот ответ об ошибке выдается, когда сервер действует как шлюз и не может получить ответ за отведенное время.
505 HTTP Version Not Supported — версия HTTP, используемая в запросе, не поддерживается сервером.
В HTTP из всего диапазона кодов используется совсем немного. Те коды, которые не используются для задания определенной логики в спецификации, являются неназначенными и могут использоваться веб-серверами для определения своей специфической логики. Это значит, что вы можете, например, придать коду 513 значение «Произошла ошибка обработки видео», или любое другое. Неназначенные коды вы можете посмотреть в реестре кодов состояния HTTP. 3
Тело запроса и ответа
Тело запроса опционально и всегда отделяется от заголовков пустой строкой. А как понять, где оно заканчивается? Всё кажется очевидным: где кончается строка, там и заканчивается тело. Однако, два символа переноса строки в HTTP означают конец запроса и отправляют его на сервер. Как быть, если мы хотим передать в теле текст, в котором есть несколько абзацев с разрывами в две строки?
POST /path HTTP/1.1 Host: localhost Первая строка Вторая строка после разрываПо логике работы HTTP соединение отправится сразу после второй пустой строки и сервер получит в качестве данных только строку Первая строка . Описанную проблему решает специальный заголовок Content-Length . Он указывает на длину контента в байтах. Обычно клиенты (например, браузеры) автоматически считают длину передаваемых данных и добавляют к запросу заголовок с этим значением. Когда сервер получит запрос, он будет ожидать в качестве контента ровно столько байт, сколько указано в заголовке.
Однако, этого недостаточно для того, чтобы передать данные на сервер. Поведение зависит от реализации сервера, но для большинства из них необходимо также передать заголовок Content-Type. Он указывает на тип передаваемых данных. В качестве значения для этого заголовка используют MIME-типы. 4
MIME (Multipurpose Internet Mail Extensions, многоцелевые расширения интернет-почты) — стандарт, который является частью протокола HTTP. Задача MIME — идентифицировать тип содержимого документа по его заголовку. К примеру, текстовый файл имеет тип text/plain , а HTML-файл — text/html .
Для передачи данных в формате обычного текста надо указать заголовок Content-Type: text/plain , а для JSON — Content-Type: application/json .
Можно ли передать тело с GET-запросом?
Популярный вопрос на некоторых собеседованиях: «Можно ли передать тело с GET-запросом?». Правильный ответ — да. Тело запроса не зависит от метода. В стандарте не описана возможность принимать тело запроса у GET-метода, но это и не запрещено. Технически вы можете отправить данные в теле, но скорее всего веб-сервер будет их игнорировать.
Представим, что на абстрактном сайте есть форма аутентификации пользователя, в которой есть всего два поля: email и пароль.
Если пользователь ввёл данные и нажал на кнопку «Войти», то данные из полей формы должны попасть на сервер. Самым простым и распространенным форматом передачи таких данных будет MIME application/x-www-form-urlencoded . В нем все поля передаются в одной строке в формате ключ=значение и разделяются знаком & .
Запрос на отправку данных будет выглядеть так:
POST /login HTTP/1.0 Host: example.com Content-Type: application/x-www-form-urlencoded; charset=utf-8 Content-Length: 26 login=user&password=qwertyТут есть небольшая особенность. Как понять, где заканчивается ключ и начинается его значение, если в пароле будет присутствовать знак «=» ?
POST /login HTTP/1.0 Host: example.com Content-Type: application/x-www-form-urlencoded; charset=utf-8 Content-Length: 26 login=user&password=123=45В этом случае сервер не сможет понять, как разбить строку на параметры и их значения. На самом деле значения кодируются при помощи механизма url encoding. 5 При использовании этого механизма знак «=» будет преобразован в код %3D .
Тогда наш запрос приобретёт такой вид:
POST /login HTTP/1.1 Host: example.com Content-Type: application/x-www-form-urlencoded; charset=utf-8 Content-Length: 28 login=user&password=123%3D45Query string
Данные на сервер можно передавать через тело запроса и через так называемую строку запроса Query String. Это параметры формата ключ=значение, которые располагаются в пути к ресурсу:
GET /files?key=value&key2=value2 HTTP/1.0При этом параметры можно передавать прямо от корня домена:
GET /?key=value&key2=value2 HTTP/1.0Query String имеет такой же формат, как и тело запроса с MIME application/x-www-form-urlencoded , только первая пара значений отделяется от адреса вопросительным знаком.
Некоторые инженеры ошибочно полагают, что Query String являются параметрами GET-запроса и даже называют их GET-параметрами, но на самом деле это не так. Как и тело запроса, Query String не имеет привязки к HTTP-методам и может передаваться с любым типом запросов.
Обычно параметры Query String используются в GET-запросах, чтобы конкретизировать получаемый ресурс. Например, можно получить на сервере список файлов, имена которых будут начинаться с переданного значения.
GET-запросы по своей идеологии должны быть идемпотентными. Это значит, что множественный вызов метода с одними и теми же параметрами должен приводить к одному и тому же результату. Например, поисковые боты перемещаются по сайту только по ссылкам и делают только GET-запросы, потому что исходя из семантики они не смогут таким образом изменить данные на сайте и повлиять на его работу.
На этом я закончу говорить про версию протокола 1.0, структуру ответов и запросов. В следующей статье я расскажу, что такое Cookies, для чего нужен CORS и как это всё работает. А пока напоследок оставлю полезные ссылки, которые упомянул в тексте:
- Основы TCP/IP
- Заголовки HTTP
- Реестр кодов состояния HTTP
- MIME типы
- Алгоритм кодирования URL encoding
HTTP-запросы: структура, методы, строка статуса и коды состояния
Рассказываем, как веб- и мобильные приложения взаимодействуют с глобальной сетью через HTTP-протокол.
Большинство используемых нами веб- и мобильных приложений постоянно взаимодействуют с глобальной сетью. Почти все подобные коммуникации совершаются с помощью запросов по протоколу HTTP. Рассказываем о них подробнее.
Базово о протоколе HTTP
HTTP (HyperText Transfer Protocol, дословно — «протокол передачи гипертекста») представляет собой протокол прикладного уровня, используемый для доступа к ресурсам Всемирной Паутины. Под термином гипертекст следует понимать текст, в понятном для человека представлении, при этом содержащий ссылки на другие ресурсы.
Данный протокол описывается спецификацией RFC 2616. На сегодняшний день наиболее распространенной версией протокола является версия HTTP/2, однако нередко все еще можно встретить более раннюю версию HTTP/1.1.
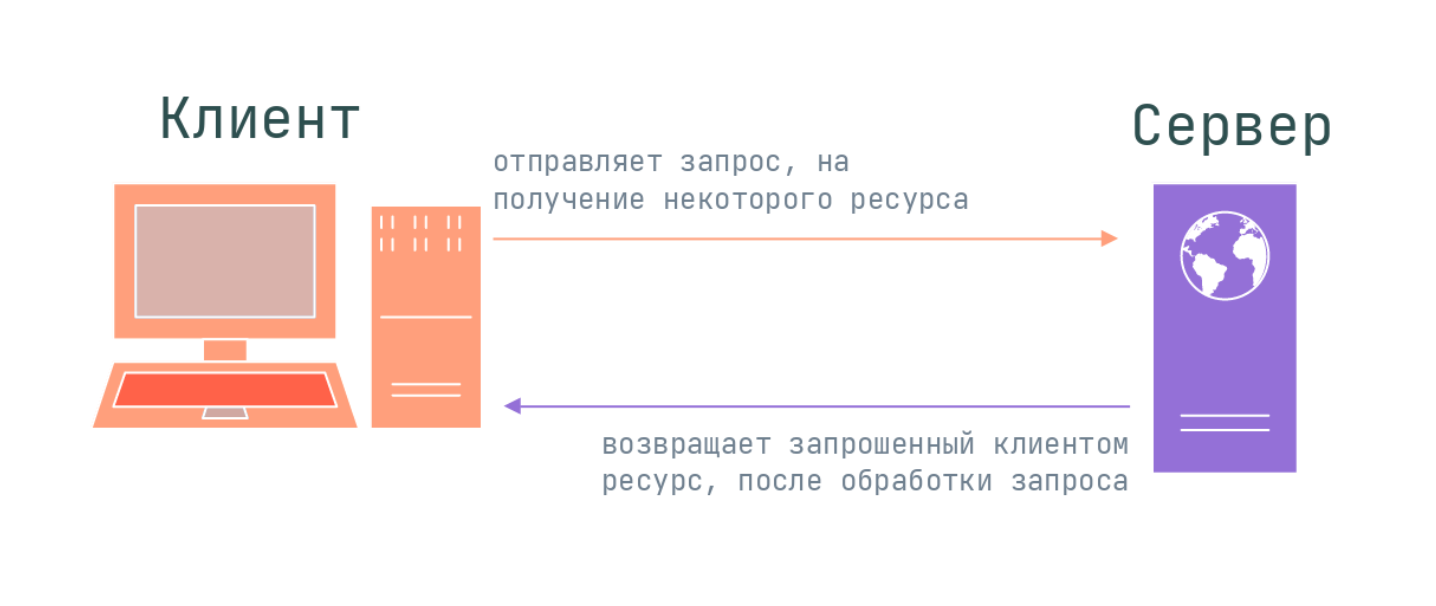
В обмене информацией по HTTP-протоколу принимают участие клиент и сервер. Происходит это по следующей схеме:
- Клиент запрашивает у сервера некоторый ресурс.
- Сервер обрабатывает запрос и возвращает клиенту ресурс, который был запрошен.
По умолчанию для коммуникации по HTTP используется порт 80, хотя вместо него может быть выбран и любой другой порт. Многое зависит от конфигурации конкретного веб-сервера.
HTTP-сообщения: запросы и ответы
Данные между клиентом и сервером в рамках работы протокола передаются с помощью HTTP-сообщений. Они бывают двух видов:
- Запросы (HTTP Requests) — сообщения, которые отправляются клиентом на сервер, чтобы вызвать выполнение некоторых действий. Зачастую для получения доступа к определенному ресурсу. Основой запроса является HTTP-заголовок.
- Ответы (HTTP Responses) — сообщения, которые сервер отправляет в ответ на клиентский запрос.
Само по себе сообщение представляет собой информацию в текстовом виде, записанную в несколько строчек.
В целом, как запросы HTTP, так и ответы имеют следующую структуру:
- Стартовая строка (start line) — используется для описания версии используемого протокола и другой информации — вроде запрашиваемого ресурса или кода ответа. Как можно понять из названия, ее содержимое занимает ровно одну строчку.
- HTTP-заголовки (HTTP Headers) — несколько строчек текста в определенном формате, которые либо уточняют запрос, либо описывают содержимое тела сообщения.
- Пустая строка, которая сообщает, что все метаданные для конкретного запроса или ответа были отправлены.
- Опциональное тело сообщения, которое содержит данные, связанные с запросом, либо документ (например HTML-страницу), передаваемый в ответе.
Рассмотрим атрибуты HTTP-запроса подробнее.
Стартовая строка
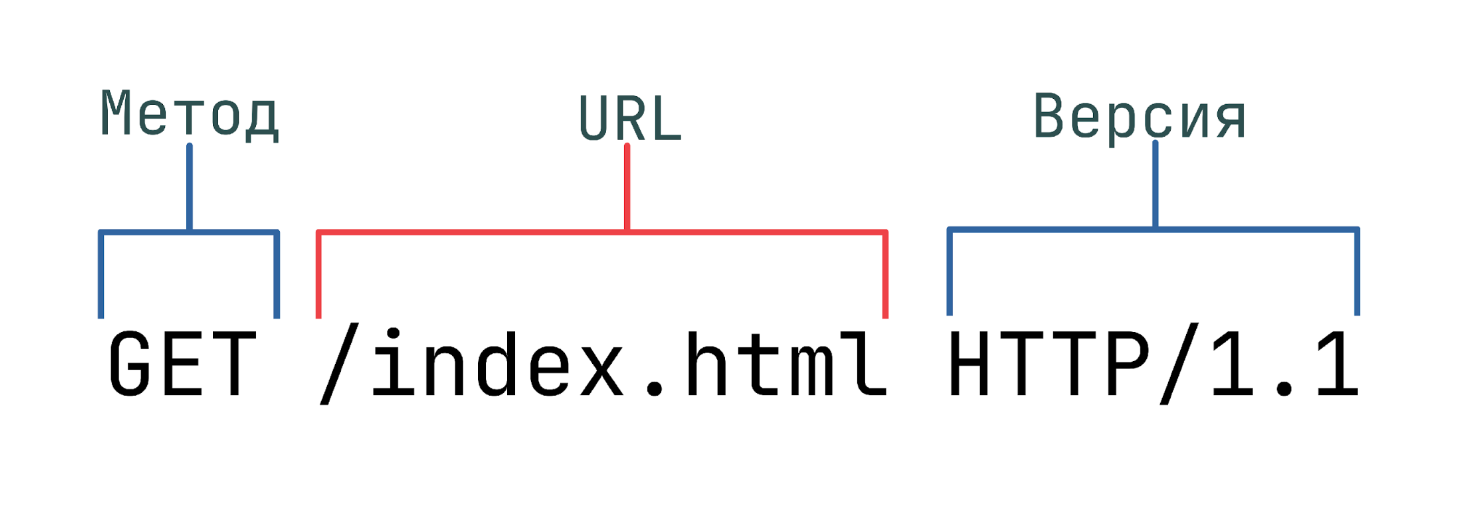
Стартовая строка HTTP-запроса состоит из трех элементов:
- Метод HTTP-запроса (method, реже используется термин verb). Обычно это короткое слово на английском, которое указывает, что конкретно нужно сделать с запрашиваемым ресурсом. Например, метод GET сообщает серверу, что пользователь хочет получить некоторые данные, а POST — что некоторые данные должны быть помещены на сервер.
- Цель запроса. Представлена указателем ресурса URL, который состоит из протокола, доменного имени (или IP-адреса), пути к конкретному ресурсу на сервере. Дополнительно может содержать указание порта, несколько параметров HTTP-запроса и еще ряд опциональных элементов.
- Версия используемого протокола (либо HTTP/1.1, либо HTTP/2), которая определяет структуру следующих за стартовой строкой данных.
В примере ниже стартовая строка указывает, что в качестве метода используется GET, обращение будет произведено к ресурсу /index.html, по версии протокола HTTP/1.1:
Разберемся с каждым из названных элементов подробнее.
Методы
Методы позволяют указать конкретное действие, которое мы хотим, чтобы сервер выполнил, получив наш запрос. Так, некоторые методы позволяют браузеру (который в большинстве случаев является источником запросов от клиента) отправлять дополнительную информацию в теле запроса — например, заполненную форму или документ.
Ниже приведены наиболее используемые методы и их описание:
Разберемся с каждым из названных элементов подробнее.
| Метод | Описание |
| GET | Позволяет запросить некоторый конкретный ресурс. Дополнительные данные могут быть переданы через строку запроса (Query String) в составе URL (например ?param=value).О составляющих URL мы поговорим чуть позже. |
| POST | Позволяет отправить данные на сервер. Поддерживает отправку различных типов файлов, среди которых текст, PDF-документы и другие типы данных в двоичном виде. Обычно метод POST используется при отправке информации (например, заполненной формы логина) и загрузке данных на веб-сайт, таких как изображения и документы. |
| HEAD | Здесь придется забежать немного вперед и сказать, что обычно сервер в ответ на запрос возвращает заголовок и тело, в котором содержится запрашиваемый ресурс. Данный метод при использовании его в запросе позволит получить только заголовки, которые сервер бы вернул при получении GET-запроса к тому же ресурсу. Запрос с использованием данного метода обычно производится для того, чтобы узнать размер запрашиваемого ресурса перед его загрузкой. |
| PUT | Используется для создания (размещения) новых ресурсов на сервере. Если на сервере данный метод разрешен без надлежащего контроля, то это может привести к серьезным проблемам безопасности. |
| DELETE | Позволяет удалить существующие ресурсы на сервере. Если использование данного метода настроено некорректно, то это может привести к атаке типа «Отказ в обслуживании» (Denial of Service, DoS) из-за удаления критически важных файлов сервера. |
| OPTIONS | Позволяет запросить информацию о сервере, в том числе информацию о допускаемых к использованию на сервере HTTP-методов. |
| PATCH | Позволяет внести частичные изменения в указанный ресурс по указанному расположению. |
URL
Получение доступа к ресурсам по HTTP-протоколу осуществляется с помощью указателя URL (Uniform Resource Locator). URL представляет собой строку, которая позволяет указать запрашиваемый ресурс и еще ряд параметров.
Использование URL неразрывно связано с другими элементами протокола, поэтому далее мы рассмотрим его основные компоненты и строение:
Поле Scheme используется для указания используемого протокола, всегда сопровождается двоеточием и двумя косыми чертами (://).
Host указывает местоположение ресурса, в нем может быть как доменное имя, так и IP-адрес.
Port, как можно догадаться, позволяет указать номер порта, по которому следует обратиться к серверу. Оно начинается с двоеточия (:), за которым следует номер порта. При отсутствии данного элемента номер порта будет выбран по умолчанию в соответствии с указанным значением Scheme (например, для http:// это будет порт 80).
Далее следует поле Path. Оно указывает на ресурс, к которому производится обращение. Если данное поле не указано, то сервер в большинстве случаев вернет указатель по умолчанию (например index.html).
Поле Query String начинается со знака вопроса (?), за которым следует пара «параметр-значение», между которыми расположен символ равно (=). В поле Query String могут быть переданы несколько параметров с помощью символа амперсанд (&) в качестве разделителя.
Не все компоненты необходимы для доступа к ресурсу. Обязательно следует указать только поля Scheme и Host.
Версии HTTP
Раз уж мы упомянули версию протокола как элемента стартовой строки, то стоит сказать об основных отличиях версий HTTP/1.X от HTTP/2.X.
Последняя стабильная, наиболее стандартизированная версия протокола первого поколения (версия HTTP/1.1) вышла в далеком 1997 году. Годы шли, веб-страницы становились сложнее, некоторые из них даже стали приложениями в том виде, в котором мы понимаем их сейчас. Кроме того, объем медиафайлов и скриптов, которые добавляли интерактивность страницам, рос. Это, в свою очередь, создавало перегрузки в работе протокола версии HTTP/1.1.
Стало очевидно, что у HTTP/1.1 есть ряд значительных недостатков:
- Заголовки, в отличие от тела сообщения, передавались в несжатом виде.
- Часто большая часть заголовков в сообщениях совпадала, но они продолжали передаваться по сети.
- Отсутствовала возможность так называемого мультиплексирования — механизма, позволяющего объединить несколько соединений в один поток данных. Приходилось открывать несколько соединений на сервере для обработки входящих запросов.
С выходом HTTP/2 было предложено следующее решение: HTTP/1.X-сообщения разбивались на так называемые фреймы, которые встраивались в поток данных.
Фреймы данных (тела сообщения) отделялись от фреймов заголовка, что позволило применять сжатие. Вместе с появлением потоков появился и ранее описанный механизм мультиплексирования — теперь можно было обойтись одним соединением для нескольких потоков.
Единственное о чем стоит сказать в завершение темы: HTTP/2 перестал быть текстовым протоколом, а стал работать с «сырой» двоичной формой данных. Это ограничивает чтение и создание HTTP-сообщений «вручную». Однако такова цена за возможность реализации более совершенной оптимизации и повышения производительности.
Заголовки
HTTP-заголовок представляет собой строку формата «Имя-Заголовок:Значение», с двоеточием(:) в качестве разделителя. Название заголовка не учитывает регистр, то есть между Host и host, с точки зрения HTTP, нет никакой разницы. Однако в названиях заголовков принято начинать каждое новое слово с заглавной буквы. Структура значения зависит от конкретного заголовка. Несмотря на то, что заголовок вместе со значениями может быть достаточно длинным, занимает он всего одну строчку.
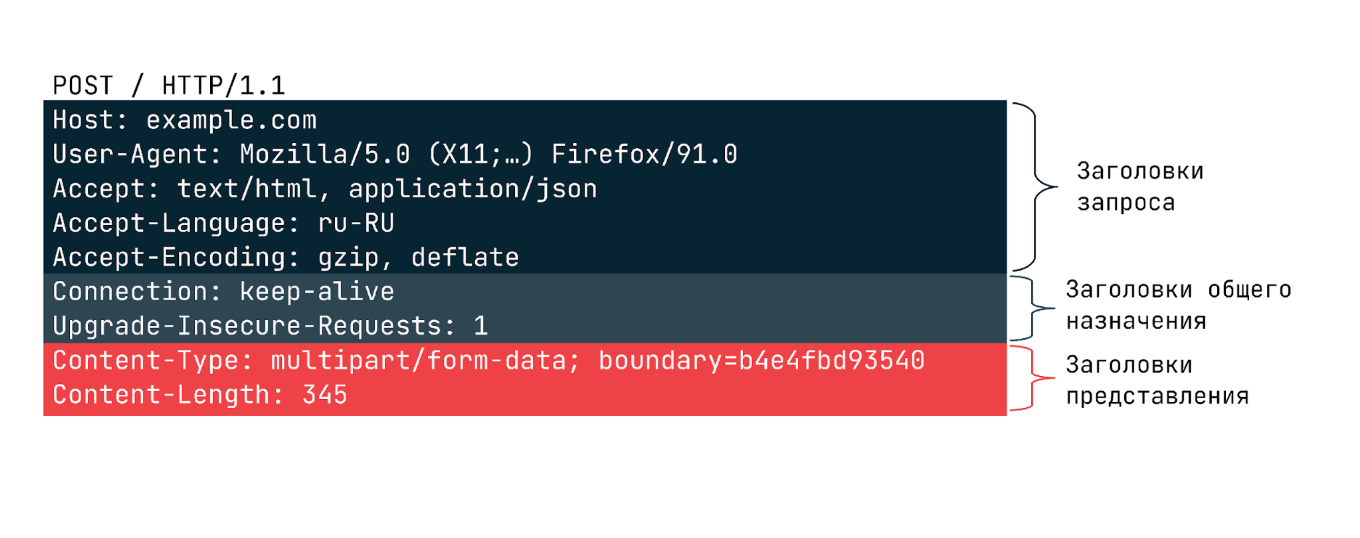
В запросах может передаваться большое число различных заголовков, но все их можно разделить на три категории:
- Общего назначения, которые применяются ко всему сообщению целиком.
- Заголовки запроса уточняют некоторую информацию о запросе, сообщая дополнительный контекст или ограничивая его некоторыми логическими условиями.
- Заголовки представления, которые описывают формат данных сообщения и используемую кодировку. Добавляются к запросу только в тех случаях, когда с ним передается некоторое тело.
Ниже можно видеть пример заголовков в запросе:
Самые частые заголовки запроса
| Заголовок | Описание |
| Host | Используется для указания того, с какого конкретно хоста запрашивается ресурс. В качестве возможных значений могут использоваться как доменные имена, так и IP-адреса. На одном HTTP-сервере может быть размещено несколько различных веб-сайтов. Для обращения к какому-то конкретному требуется данный заголовок. |
| User-Agent | Заголовок используется для описания клиента, который запрашивает ресурс. Он содержит достаточно много информации о пользовательском окружении. Например, может указать, какой браузер используется в качестве клиента, его версию, а также операционную систему, на которой этот клиент работает. |
| Refer | Используется для указания того, откуда поступил текущий запрос. Например, если вы решите перейти по какой-нибудь ссылке в этой статье, то вероятнее всего к запросу будет добавлен заголовок Refer: https://selectel.ru |
| Accept | Позволяет указать, какой тип медиафайлов принимает клиент. В данном заголовке могут быть указаны несколько типов, перечисленные через запятую (‘ , ‘). А для указания того, что клиент принимает любые типы, используется следующая последовательность — */*. |
| Cookie | Данный заголовок может содержать в себе одну или несколько пар «Куки-Значение» в формате cookie=value. Куки представляют собой небольшие фрагменты данных, которые хранятся как на стороне клиента, так и на сервере, и выступают в качестве идентификатора. Куки передаются вместе с запросом для поддержания доступа клиента к ресурсу. Помимо этого, куки могут использоваться и для других целей, таких как хранение пользовательских предпочтений на сайте и отслеживание клиентской сессии. Несколько кук в одном заголовке могут быть перечислены с помощью символа точка с запятой (‘ ; ‘), который используется как разделитель. |
| Authorization | Используется в качестве еще одного метода идентификации клиента на сервере. После успешной идентификации сервер возвращает токен, уникальный для каждого конкретного клиента. В отличие от куки, данный токен хранится исключительно на стороне клиента и отправляется клиентом только по запросу сервера. Существует несколько типов аутентификации, конкретный метод определяется тем веб-сервером или веб-приложением, к которому клиент обращается за ресурсом. |
Тело запроса
Завершающая часть HTTP-запроса — это его тело. Не у каждого HTTP-метода предполагается наличие тела. Так, например, методам вроде GET, HEAD, DELETE, OPTIONS обычно не требуется тело. Некоторые виды запросов могут отправлять данные на сервер в теле запроса: самый распространенный из таких методов — POST.
Ответы HTTP
HTTP-ответ является сообщением, которое сервер отправляет клиенту в ответ на его запрос. Его структура равна структуре HTTP-запроса: стартовая строка, заголовки и тело.
Строка статуса (Status line)
Стартовая строка HTTP-ответа называется строкой статуса (status line). На ней располагаются следующие элементы:
- Уже известная нам по стартовой строке запроса версия протокола (HTTP/2 или HTTP/1.1).
- Код состояния, который указывает, насколько успешно завершилась обработка запроса.
- Пояснение — короткое текстовое описание к коду состояния. Используется исключительно для того, чтобы упростить понимание и восприятие человека при просмотре ответа.
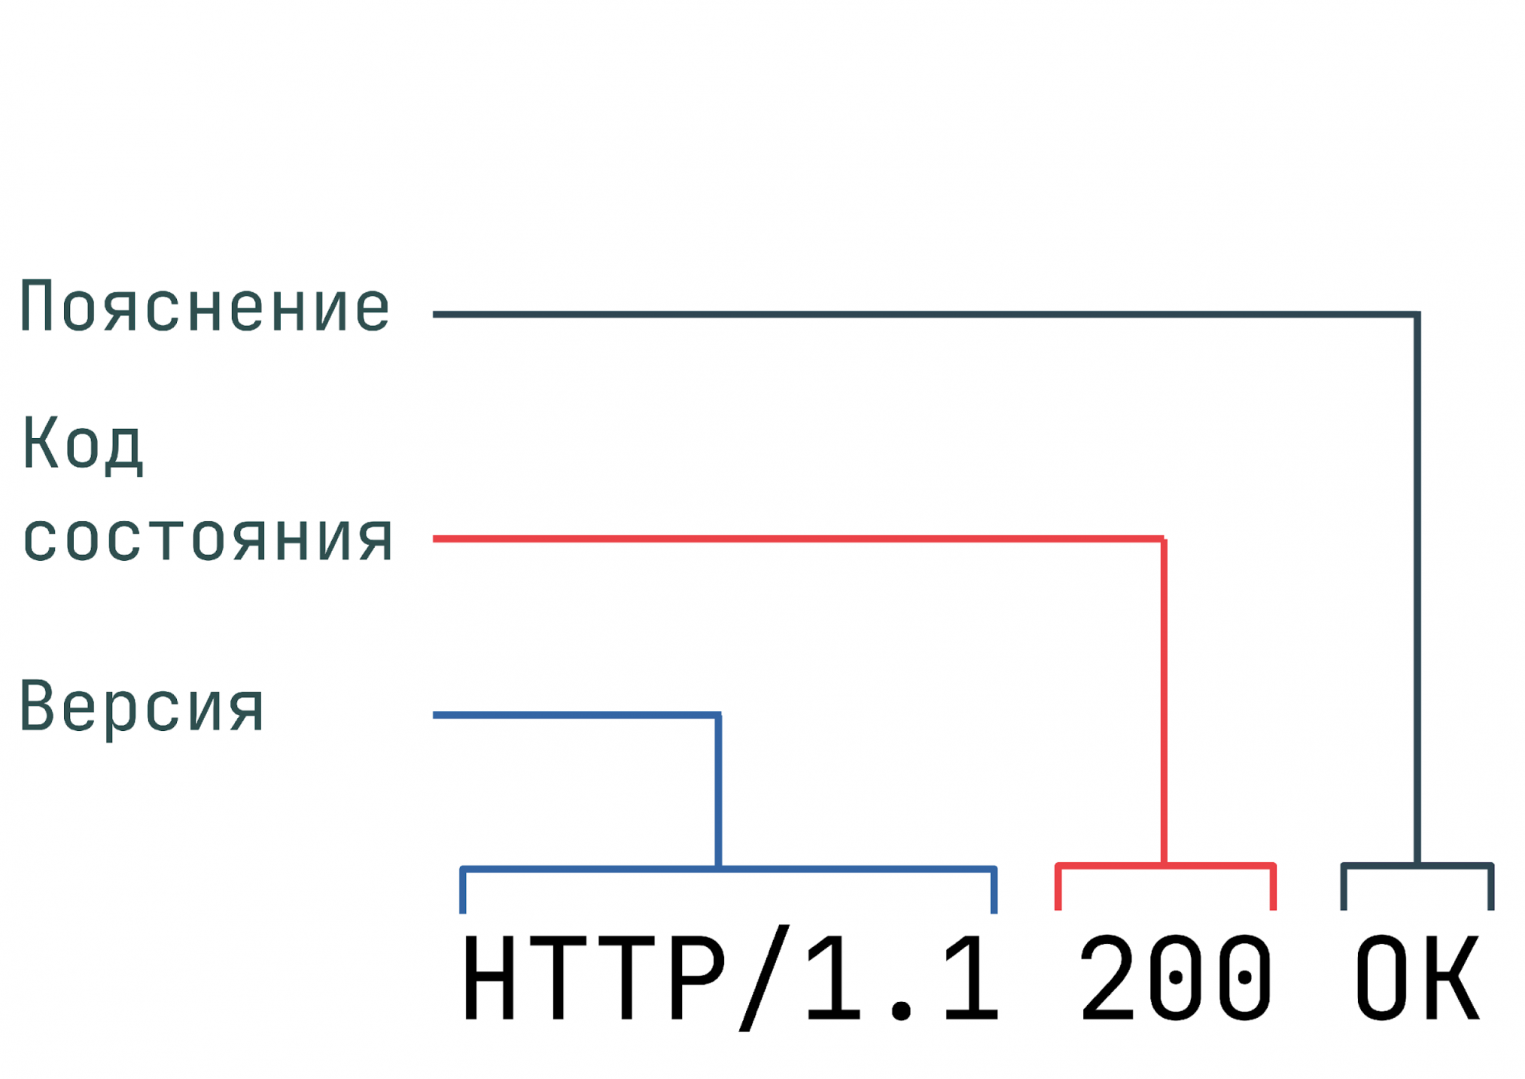
Коды состояния и текст статуса
Коды состояния HTTP используются для того, чтобы сообщить клиенту статус их запроса. HTTP-сервер может вернуть код, принадлежащий одной из пяти категорий кодов состояния:
| Категория | Описание |
| 1xx | Коды из данной категории носят исключительно информативный характер и никак не влияют на обработку запроса. |
| 2xx | Коды состояния из этой категории возвращаются в случае успешной обработки клиентского запроса. |
| 3xx | Эта категория содержит коды, которые возвращаются, если серверу нужно перенаправить клиента. |
| 4xx | Коды данной категории означают, что на стороне клиента был отправлен некорректный запрос. Например, клиент в запросе указал не поддерживаемый метод или обратился к ресурсу, к которому у него нет доступа. |
| 5xx | Ответ с кодами из этой категории приходит, если на стороне сервера возникла ошибка. |
Полный список кодов состояния доступен в спецификации к протоколу, ниже приведены только самые распространенные коды ответов:
| Категория | Описание |
| 200 OK | Возвращается в случае успешной обработки запроса, при этом тело ответа обычно содержит запрошенный ресурс. |
| 302 Found | Перенаправляет клиента на другой URL. Например, данный код может прийти, если клиент успешно прошел процедуру аутентификации и теперь может перейти на страницу своей учетной записи. |
| 400 Bad Request | Данный код можно увидеть, если запрос был сформирован с ошибками. Например, в нем отсутствовали символы завершения строки. |
| 403 Forbidden | Означает, что клиент не обладает достаточными правами доступа к запрошенному ресурсу. Также данный код можно встретить, если сервер обнаружил вредоносные данные, отправленные клиентом в запросе. |
| 404 Not Found | Каждый из нас, так или иначе, сталкивался с этим кодом ошибки. Данный код можно увидеть, если запросить у сервера ресурс, которого не существует на сервере. |
| 500 Internal Error | Данный код возвращается сервером, когда он не может по определенным причинам обработать запрос. |
Помимо основных кодов состояния, описанных в стандарте, существуют и коды состояния, которые объявляются крупными сетевыми провайдерами и серверными платформами. Так, коды состояния, используемые Selectel, можно посмотреть здесь.
Заголовки ответа
Response Headers, или заголовки ответа, используются для того, чтобы уточнить ответ, и никак не влияют на содержимое тела. Они существуют в том же формате, что и остальные заголовки, а именно «Имя-Значение» с двоеточием (:) в качестве разделителя.
Ниже приведены наиболее часто встречаемые в ответах заголовки:
| Категория | Пример | Описание |
| Server | Server: ngnix | Содержит информацию о сервере, который обработал запрос. |
| Set-Cookie | Set-Cookie:PHPSSID=bf42938f | Содержит куки, требуемые для идентификации клиента. Браузер парсит куки и сохраняет их в своем хранилище для дальнейших запросов. |
| WWW-Authenticate | WWW-Authenticate: BASIC realm=»localhost» | Уведомляет клиента о типе аутентификации, который необходим для доступа к запрашиваемому ресурсу. |
Тело ответа
Последней частью ответа является его тело. Несмотря на то, что у большинства ответов тело присутствует, оно не является обязательным. Например, у кодов «201 Created» или «204 No Content» тело отсутствует, так как достаточную информацию для ответа на запрос они передают в заголовке.
Безопасность HTTP-запросов, или что такое HTTPs
HTTP является расширяемым протоколом, который предоставляет огромное количество возможностей, а также поддерживает передачу всевозможных типов файлов. Однако, вне зависимости от версии, у него есть один существенный недостаток, который можно заметить если перехватить отправленный HTTP-запрос:
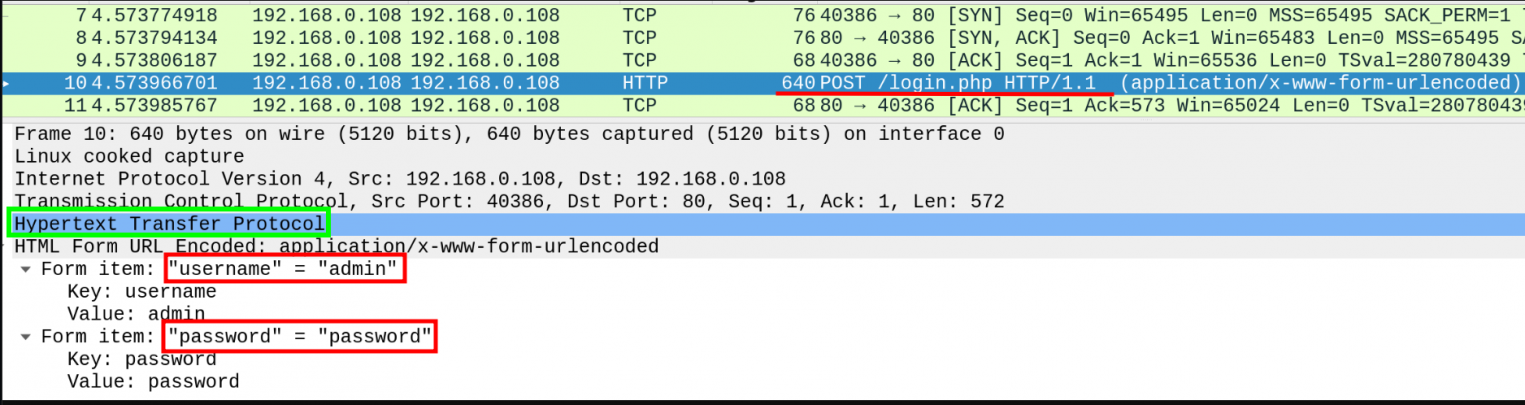
Да, все верно: данные передаются в открытом виде. HTTP сам по себе не предоставляет никаких средств шифрования.
Но как же тогда работают различные банковские приложения, интернет-магазины, сервисы оплаты услуг и прочие приложения, в которых циркулирует чувствительная информация пользователей?
Время рассказать про HTTPs!
HTTPs (HyperText Transfer Protocol, secure) является расширением HTTP-протокола, который позволяет шифровать отправляемые данные, перед тем как они попадут на транспортный уровень. Данный протокол по умолчанию использует порт 443.
Теперь если мы перехватим не HTTP , а HTTPs-запрос, то не увидим здесь ничего интересного:
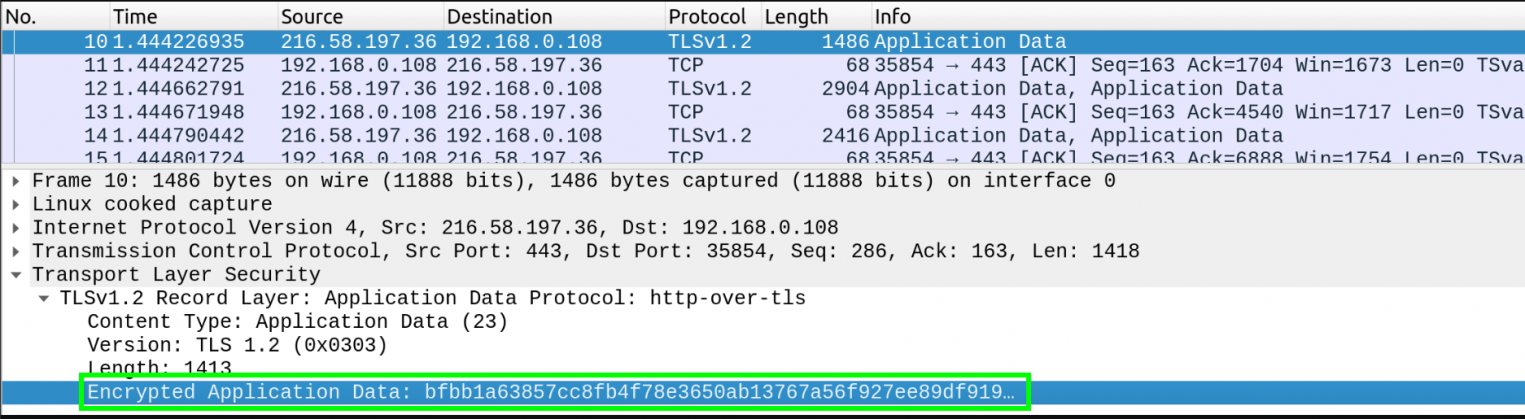
Данные передаются в едином зашифрованном потоке, что делает невозможным получение учетных данных пользователей и прочей критической информации средствами обычного перехвата.
Если хотите подробнее узнать о деталях работы протокола, читайте статью в нашем блоге →
Как отправить HTTP-запрос и прочитать его ответ
Теория это, конечно, отлично, но ничего так хорошо не закрепляет материал, как практика
Мы рассмотрим несколько способов, как написать HTTP-запрос в браузер, послать HTTP-запрос на сервер и получить ответ:
- Инструменты разработчика в браузере.
- Утилита cURL.
Инструменты разработчика
Основной программой на наших устройствах, которая работает с HTTP-протоколом, в большинстве случаев является браузер. Помимо обычных пользователей, с браузерами часто работают и разработчики веб-приложений. Именно их инструментами мы воспользуемся для работы с запросами и ответами.
По нажатию комбинации клавиш [Ctrl+Shift+I] или просто [F12] в подавляющем большинстве современных браузеров у нас откроется окно инструментов разработчика, которая представляет собой панель с несколькими вкладками. Нужная нам вкладка обычно называется Network. Перейдем в нее, а в адресной строке введем URL того сайта, на который хотим попасть. В качестве примера воспользуемся сайтом блога Selectel — https://selectel.ru/blog/.
После нажатия Enter сайт начнет загружаться, а открытая вкладка Network — заполняться различными элементами, начиная все больше напоминать приборную панель самолета.
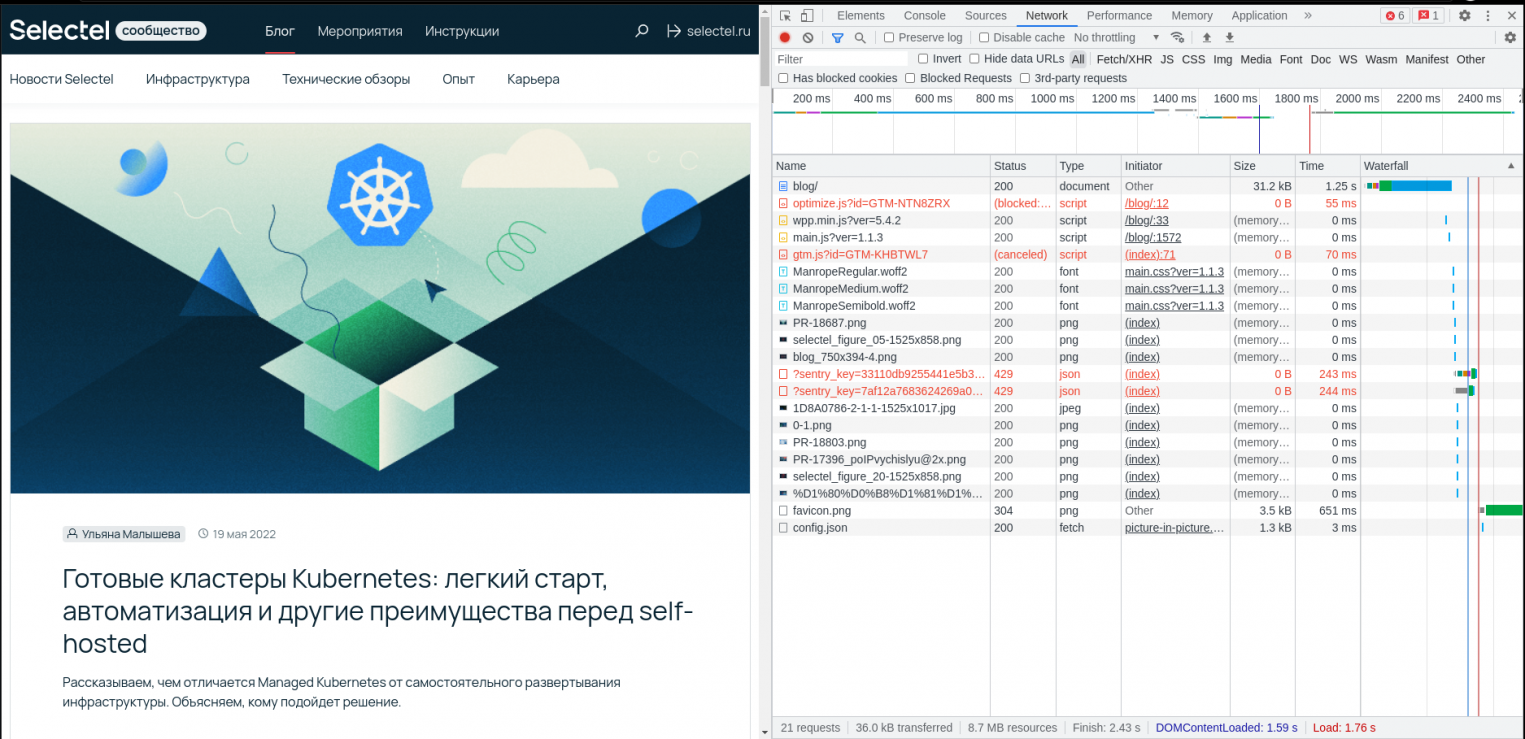
Не спешите пугаться. Это всего лишь список ресурсов, которые нужны для правильного отображения и работы сайта.
Нажав на любой из них, мы можем увидеть детали обработки отправленного запроса:
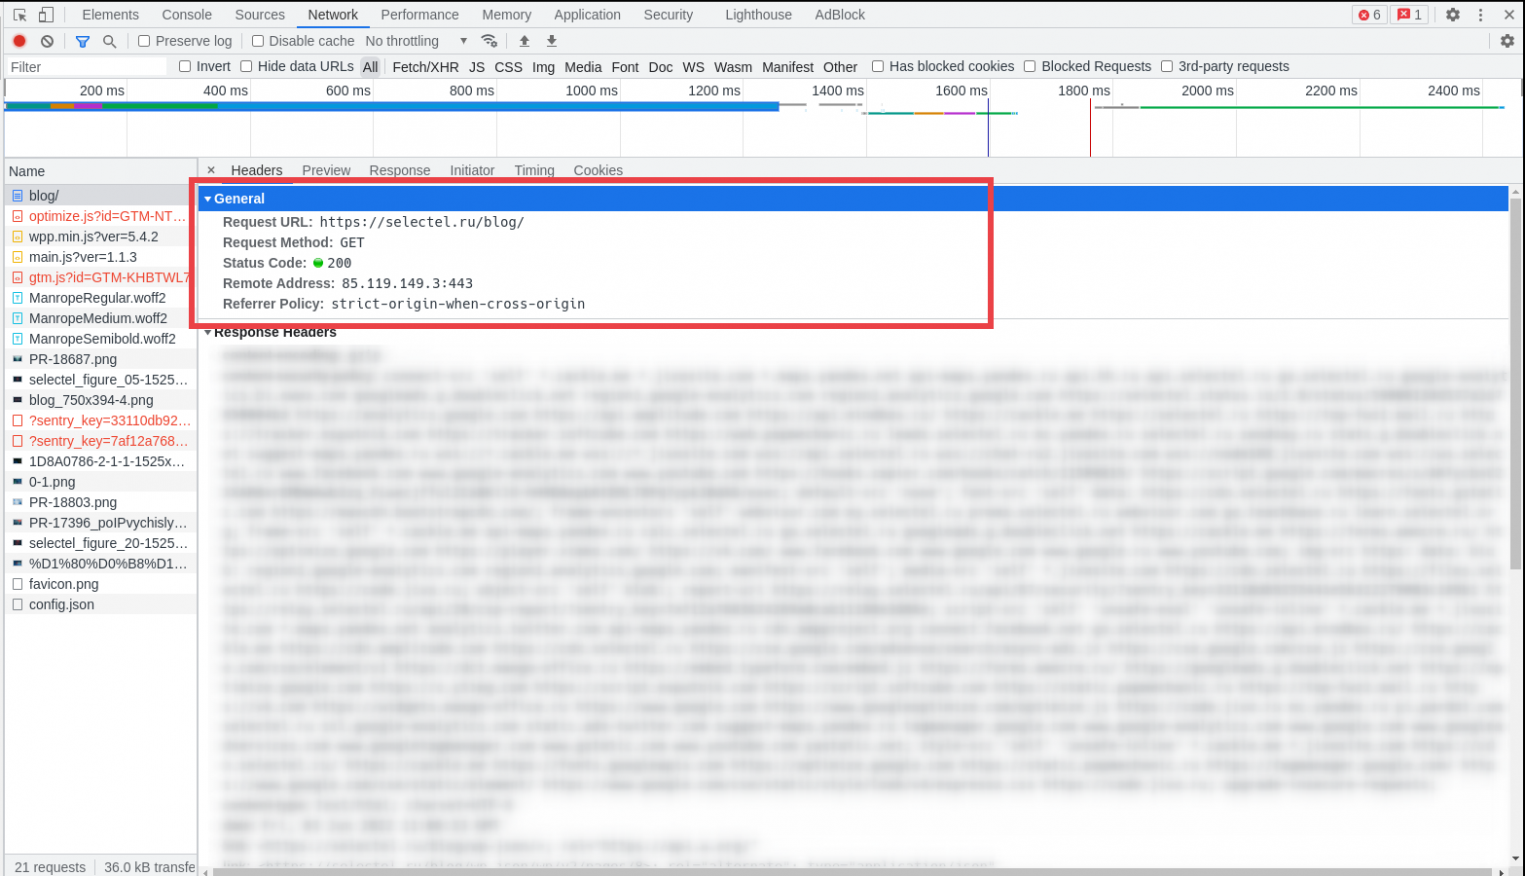
В данном запросе, например:
- URL, к которому было совершено обращение — https://selectel.ru/blog,
- Метод, который был использован в запросе — GET,
- И в качестве кода возврата сервер вернул нам страницу с кодом статуса — 200 OK
Утилита cURL
Следующий инструмент, с помощью которого мы сможем послать запрос на тот или иной сервер, это утилита cURL.
cURL (client URL) является небольшой утилитой командной строки, которая позволяет работать с HTTP и рядом других протоколов.
Для отправки запроса и получения ответа мы можем воспользоваться флагом -v и указанием URL того ресурса, который мы хотим получить. «Схему» HTTP-запроса можно увидеть на скрине ниже:
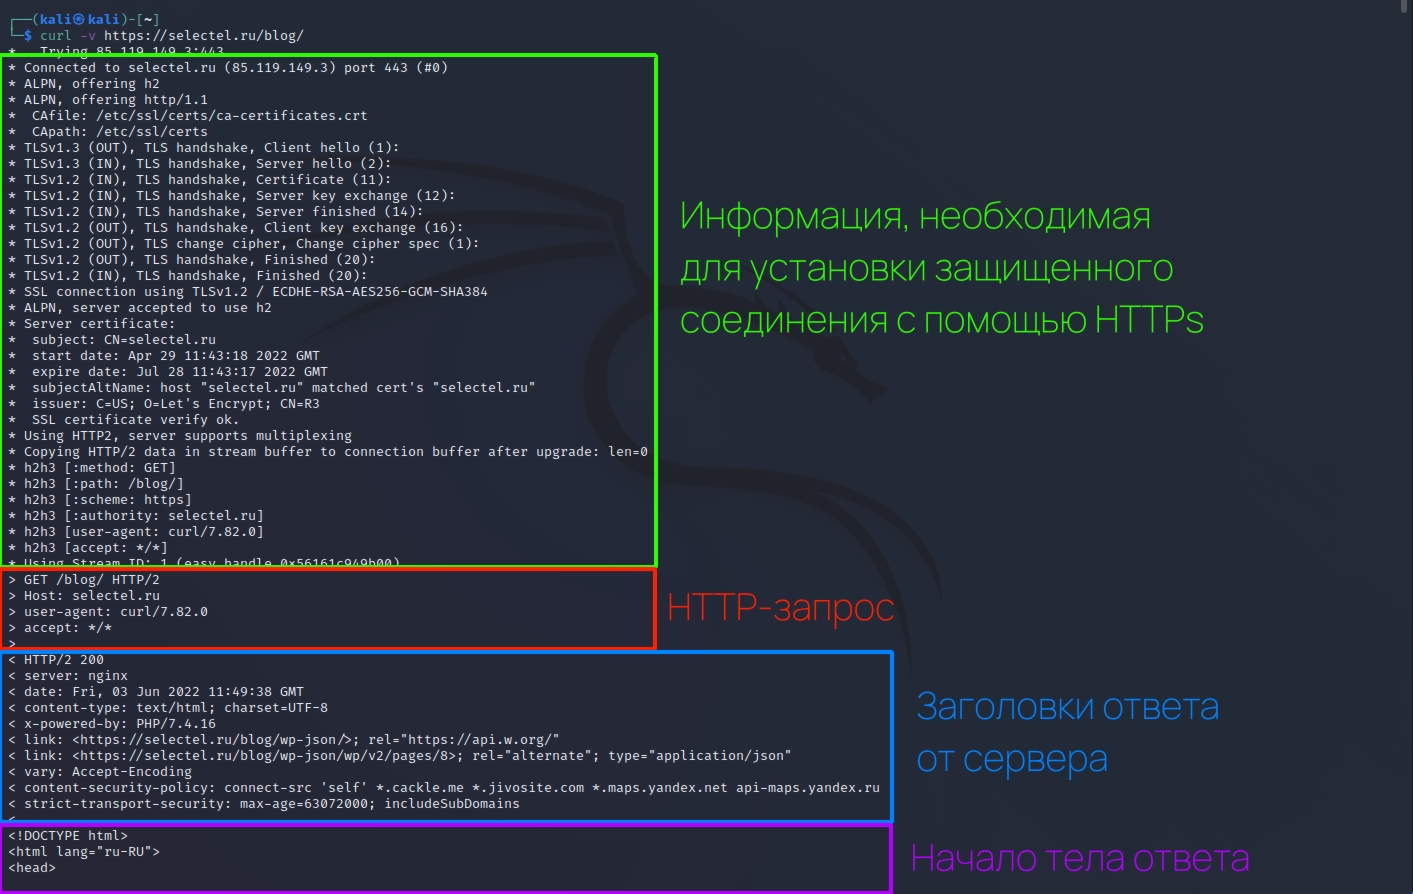
После запуска утилита выполняет:
- подключение к серверу,
- самостоятельно разрешает все вопросы, необходимые для отправки запроса по HTTPs,
- отправляет запрос, содержимое которого мы можем видеть благодаря флагу -v,
- принимая ответ от сервера, отображает его в командной строке «как-есть».
Помимо этого, у данной утилиты есть огромное количество опций, которые предоставляют возможности по детальной настройке отправляемых запросов. Все эти возможности и делают ее такой популярной у веб-разработчиков и других специалистов, которым приходится работать с протоколом HTTP.
Заключение
HTTP представляет собой расширяемый протокол прикладного уровня, на котором работает весь веб-сегмент интернета. В данной статье мы рассмотрели принцип его работы, структуру, «компоненты» HTTP-запросов. Коснулись вопросов отличия версий протокола, HTTPs — его расширения, добавляющего шифрование. Разобрали устройство запроса, поняли, как можно отправить HTTP-запрос и получить ответ от сервера.
Чем отличаются HTTP-методы GET и POST
HTTP-методы GET и POST — самые распространённые способы отправить или получить данные с сервера. Но в разных случаях оба метода могут быть небезопасными или неудобными в использовании. В этой заметке рассмотрим, какой метод когда использовать.
GET — метод для чтения данных с сайта. Например, для доступа к указанной странице. Он говорит серверу, что клиент хочет прочитать указанный документ. На практике этот метод используется чаще всего, например, в интернет-магазинах на странице каталога. Фильтры, которые выбирает пользователь, передаются через метод GET .
:authority: htmlacademy.ru :method: GET :path: /tutorial/php/http-header POST — метод для отправки данных на сайт. Чаще всего с помощью метода POST передаются формы.
URL-адрес запроса: https://htmlacademy.ru/ Метод запроса: POST Код состояния: 200 Формат запроса
Протокол HTTP очень прост и состоит, по сути, из двух частей — заголовков и тела запроса или ответа.
Тело запроса — это информация, которую передал браузер при запросе страницы. Но тело запроса присутствует только если браузер запросил страницу методом POST . Например, если отправлена форма, то телом запроса будет содержание формы.

Пример GET-запроса. Информация передаётся прямо в заголовке.
GET /blog/?name1=value1&name2=value2 HTTP/1.1 Host: htmlacademy.ru Пример POST-запроса. Информация передаётся в теле запроса:
POST /blog/ HTTP/1.1 Host: htmlacademy.ru name1=value1&name2=value2 GET для безопасных действий, POST для опасных
Говоря совсем просто, GET-запросы лучше не использовать с приватной информацией. Вот почему:
- Они кешируются. Это значит, что логин и пароль, переданные через GET-запрос, могут остаться в интернете навсегда, например, в веб-архиве или кеше Гугла.
- Остаются в истории браузера. Чтобы узнать, какие данные отправлялись, достаточно нажать Ctrl+H.
- Сохраняются в закладках и пересылаются. Можно не обратить внимания и опубликовать в соцсетях или отправить ссылку с приватной информацией в GET-запросе.
- Сохраняются в логах сервера. Например, нельзя отправлять данные банковских карт через GET-запрос, так как это создаёт риски для пользователей.
Таким образом, любые важные данные — логины, пароли, данные карты, персональные данные — лучше передавать с помощью метода POST . Также метод POST поддерживает тип кодирования данных multipart/form-data , что позволяет передавать файлы.
Ещё раз коротко
GET
- Фильтры в интернет-магазинах
- Передача параметров через ссылку
- Другие безопасные запросы
POST
- Любые формы с паролями или банковскими картами
- Формы заявок с персональными данными
- Отправка файлов
Полезные материалы
- Тренажёр по работе с методом GET
- Протокол HTTP
- Где смотреть запросы. Вкладка Network в Chrome DevTools
- Механизм безопасной переадресации после POST-запроса (англ.)
«Доктайп» — журнал о фронтенде. Читайте, слушайте и учитесь с нами.
Читать дальше

Как работает протокол HTTP
HTTP был разработан в 1990-х годах для создания первого интерактивного текстового веб-браузера. За эти годы протокол менялся и совершенствовался, становился более гибким и постепенно превратился в современный интернет. В статье рассмотрим принцип работы протокола и что важно знать о нём разработчику.
- 8 февраля 2023

10 популярных функций в MYSQL, которые вам нужно знать
Без лишних слов принесли вам некоторые популярные функции MySQL, без которых вы точно не обойдётесь в работе.
- 17 января 2023

Подключение файлов в PHP. Метод require()
Способность вызывать сценарий из отдельного файла по его имени называется в PHP подключением файлов. Подключают PHP-сценарии, любые текстовые файлы или HTML-страницы.
- 21 ноября 2022

Массивы в PHP
Массив — это ещё один тип данных, вроде числа или строки. Главное отличие массива от остальных типов данных заключается в его способности хранить в переменной больше одного значения. В предыдущих примерах имя переменной всегда ассоциировалось только с одним значением:
- $name = «Иннокентий»
- $age = 42
А если мы хотим узнать не только пол, имя и возраст пользователя, но и, допустим, любимые сериалы? Очень непросто назвать один самый любимый сериал, а вот вспомнить несколько — намного легче. Сохранение в переменную-массив нескольких значений выглядит так:
$fav_shows = ["game of thrones", "american horror story", "walking dead"];
В этом примере мы сохранили в переменной $fav_shows сразу три значения. Но сохранить эти данные — это только половина дела. Как с ними потом работать? Уже знакомый вам способ вывода переменной на экран не будет работать с массивами:
Так увидеть список любимых сериалов не получится. Дело в том, что массив — это не обычная переменная. Массив хранит не простые типы, вроде текста или чисел (их ещё называют «скалярными типами»), а более сложную структуру данных, поэтому здесь нужен особый подход.
Внутри массива у каждого значения есть адрес, по которому к нему можно обратиться. Такой адрес называется индексом. Индекс — это просто порядковый номер значения внутри массива. Индексация начинается с нуля, так что первый элемент получает индекс — 0 , второй — 1 , и так далее.
Чтобы получить определенный элемент массива, необходимо знать его индекс (ключ). Напечатаем названия всех сериалов из массива через запятую:
Теперь можно дать определение массива: Массив — это совокупность множества элементов вида «ключ: значение».
Массивы позволяют перезаписывать существующие значения и добавлять новые. Добавить новое значение в массив можно так:
$fav_shows[] = "the big bang theory"; Новый элемент автоматически получит индекс равный максимальному индексу из существующих + 1. «Теория большого взрыва» сохранится в массиве под индексом 3 .
Если нам перестал нравиться один из сериалов, так как новый сезон оказался очень плох или появился новый фаворит, значения в массиве можно заменить. Чтобы вычеркнуть старое значение и заменить его новым, нужно присвоить новое значение любому из существующих в массиве индексов:
$fav_shows[4] = "fargo"; Для полного удаления (без замены на другое) значения по его индексу существует функция unset :
unset($fav_shows[4]); - 10 ноября 2022

Синтаксис PHP
Разберёмся, из чего состоит любой язык программирования.
У каждого языка есть правила и конструкции, следуя которым мы выражаем мысли и делаем их понятными для другого человека. В программировании всё точно так же. Но вместо человеческого языка мы используем язык программирования PHP, а в роли нашего собеседника выступает PHP-интерпретатор. Поэтому, чтобы выразить свою мысль, мы должны сделать её понятной для интерпретатора.
- 27 октября 2022
Массивы $_POST и $_GET в PHP. Обработка форм
Формы — это часть языка HTML. Формы нужны для передачи данных от клиента на сервер. Чаще всего формы используются для регистрации пользователей, заполнения анкет, оформления заказа в интернет магазине, и так далее.
Через формы можно отправлять как простую текстовую информацию, так и файлы.
Большую часть времени программирования на PHP вы будете так или иначе работать с формами и данными из них.
HTML описывает то, из каких элементов состоит форма, и как она выглядит. Но без принимающей стороны, то есть сервера, который принимает эти данные и обрабатывает их нужным образом, создавать формы нет никакого смысла.
PHP содержит множество средств для работы с формами. Это позволяет очень просто решать типичные задачи, которые часто возникают в веб-программировании:
- Регистрация и аутентификация пользователя;
- Отправка комментариев на форумах и социальных сетях;
- Оформление заказов.
Практически любой современный сайт содержит как минимум несколько разных HTML-форм.
- 20 октября 2022
Учебник по PHP
- Знакомство с языком
- Что такое PHP
- Синтаксис PHP
- Массивы
- Циклы
- Функции
- Шаблонизация и подключение файлов
- Подключение файлов
- Шаблонизация
- Протокол HTTP и формы
- Протокол HTTP
- Формы
- Уязвимости
- Идентификация пользователя на сайте
- Аутентификация пользователя
- Базы данных
- База данных
- SQL
- MySQL в PHP
- Безопасность в MySQL
- Объекты и использование библиотек
- Объекты
- Библиотеки
- Composer
- 10 сентября 2022

Протокол HTTP и работа с заголовками
Весь современный веб построен на модели взаимодействия клиента и сервера. Как она работает:
- браузер пользователя (клиент) отправляет на сервер запрос с адресом сайта (URL);
- сервер получает запрос и отдаёт клиенту запрошенный контент.
Для реализации процесса используется универсальный протокол HTTP.
- 10 сентября 2022

Защита от SQL-инъекций
Внедрение SQL-кода (SQL инъекция) — один из распространённых способов взлома сайтов, работающих с базами данных. Способ основан на внедрении в запрос произвольного SQL-кода. Внедрение SQL позволяет хакеру выполнить произвольный запрос к базе данных (прочитать содержимое любых таблиц, удалить, изменить или добавить данные).
Атака этого типа возможна, когда недостаточно фильтруются входные данные при использовании в SQL-запросах.
- 10 сентября 2022

Объекты и классы в PHP
Объекты в PHP — это просто ещё один тип данных. Объект позволяет хранить в переменной набор из свойств и их значений, а также встроенные функции. Это делает объекты похожими по своей структуре на ассоциативные массивы. Но отличие от массивов всё-таки есть, и при этом достаточно важное — объекты могут иметь внутреннее состояние.
- 10 сентября 2022