Зачем нужна линейная алгебра?
http://perevodika.ru/forum/index.php?showtopic=4139 У меня возник вопрос как у автора. Кто нибудь может ответить? Как мотивировать себя учить линейную алгебру?
Лучший ответ
Разумеется, в повседневной жизни она не пригодится. Только в науке. Например, в квантовой механике без нее делать нечего.
Проблема в том, что вначале изучают сюжеты скучные: тупые операции с векторами, матрицами, вычисление определителей.. . До по-настоящему захватывающих и фундаментальных вещей (инвариантов) многие вообще не доходят (это тензорное исчисление, линейные операторы, спектральная теория) . Именно они — мощные средства познания природы, так как природа инвариантна к координатным системам.
Остальные ответы
в жизни все средства хороши на всякий случай
Если рассуждать так, как рассуждает ваш автор, вам ваще ничего и не потребуется в этой жизни!
Математика нужна только для того, чтобы считать деньги. 4 действия арифметики, никаких корней, степеней и логарифмов.
Разве Фонвизин не ответил на этот вопрос, что его тут так часто задают?
Линейная алгебра для Data Science
Можно заниматься машинным обучением без владения математическим аппаратом — используйте готовые библиотеки, находите в интернете нужные алгоритмы под каждую задачу, применяйте их к данным. Однако, чтобы стать профессионалом, нужно понимать принципы, которые стоят за этими инструментами. Рассказываем о необходимой базе владения линейной алгеброй. Линейная алгебра применяется для решения всех основных задач Data Science: создания и настройки моделей, тренировки нейросетей и применения аналитических систем к информации. Программы машинного обучения фактически и представляют собой линейные функции, которым вы «скармливаете» данные, чтобы получить результат. Этот процесс работает в обе стороны — вы можете по результату восстановить исходный материал, как в обучении без учителя, или формировать прогнозы на будущее.
Освойте профессию «Data Scientist»
Data Scientist
Дата-сайентисты решают поистине амбициозные задачи. Научитесь создавать искусственный интеллект, обучать нейронные сети, менять мир и при этом хорошо зарабатывать. Программа рассчитана на новичков и плавно введет вас в Data Science.
Профессия / 24 месяца
Data Scientist
Решайте амбициозные задачи с помощью нейросетей
5 491 ₽/мес 9 983 ₽/мес
Если у вас стоит задача определить взаимосвязь двух явлений, вы применяете линейную регрессию. Когда некие данные нужно распределить по классам, вам помогает регрессия логистическая. Методы главных компонент (Principal Component Analysis) и опорных векторов (Support-Vector Machine), функции регуляризации, градиентный спуск — все эти инструменты помогают дата-сайентистам в их ежедневной работе. Рассмотрим десять методов линейной алгебры, которые чаще всего применяют специалисты по машинному обучению и нейросетям. Всех желающих лучше разобраться в этой теме, повысить свои компетенции и привлекательность для работодателей приглашаем на наш курс по математике для Data Science.
Функции потерь (Loss Functions)
Для большинства именно с этого начинается знакомство с Data Science — функции потерь помогают создавать рекомендательные и прогнозные системы, определять тенденции в массивах данных. Допустим, у вас есть модель линейной регрессии, которой вы предлагаете исходные данные. Полученный результат вы сравниваете с образцом, чтобы определить, как далеко от реальности он лежит. Эта информация помогает вам оптимизировать функцию прогнозирования. Как же подсчитать эту разницу? Для этого вы представляете эти данные в виде двух векторов и применяете к ним функцию потерь. Например, пусть ожидаемый прогноз — это вектор P, а ваши результаты — вектор E. Тогда P-E — это разница между данными, а длина этого третьего вектора и представляет собой величину ошибки.
Станьте дата-сайентистом и решайте амбициозные задачи с помощью нейросетей
Регуляризация (Regularization)
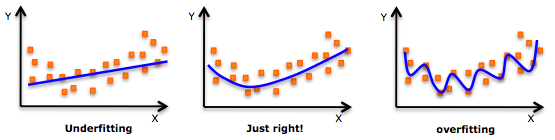
При создании аналитических моделей следует избегать двух крайностей — недообучения (underfitting) и переобучения (overfitting), В первом случае алгоритм делает поспешные выводы, во втором строит функцию слишком близко к исходным данным. Истина лежит посередине, и достичь ее помогает регуляризация. Для этого к целевой функции добавляются весовые коэффициенты. Они не позволяют функции «отвлекаться» на избыточные данные, обеспечивая нужный результат.
Ковариантная матрица (Covariance Matrix)
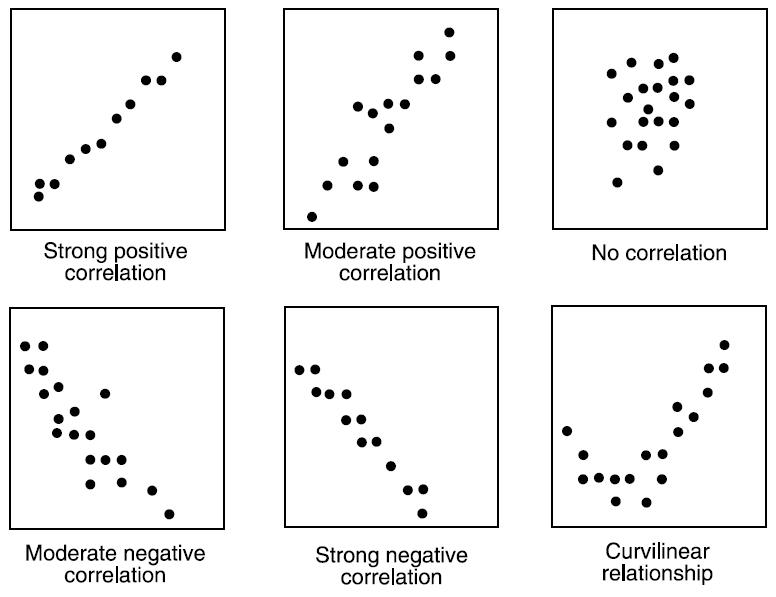
Бивариантный анализ позволяет изучать взаимосвязи между парами переменных. Ковариантность, которая применяется в такой работе, помогает определить линейное направление изменений в таких моделях. Позитивная ковариантность означает, что увеличение или уменьшение одной переменной приводит к симметричному изменению другой. Отрицательная ковариантность свидетельствует об обратном изменении — увеличение одного параметра уменьшает второй, и наоборот. Определяя значение ковариантности, мы получаем показатель корреляции, который лежит в пределах от -1 до 1. Он объединяет в себе величину и направление линейной взаимосвязи двух переменных.
Метод опорных векторов (Support-Vector Machine)
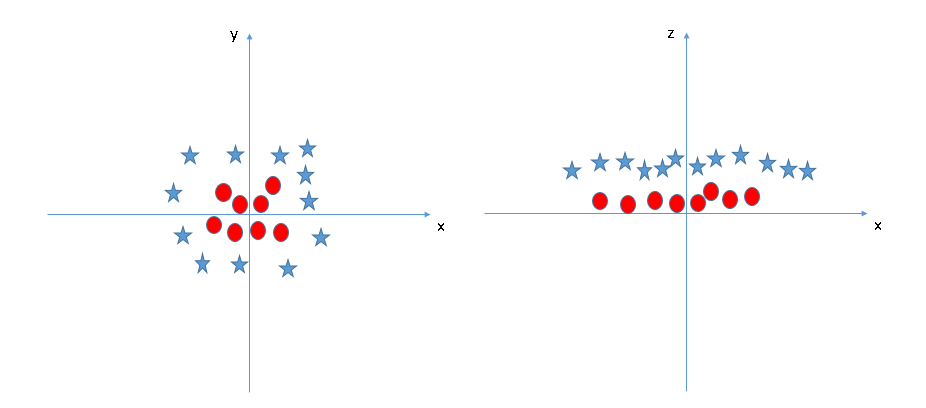
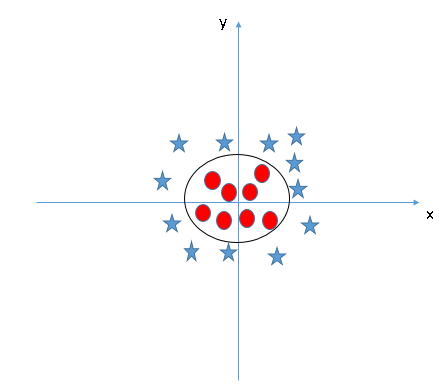
Как говорилось выше, техника SVM применяется для классификации объектов. Для этого используется концепция векторных пространств — математических структур, объединяющих множество векторов, с которым можно проводить операции сложения, вычитания и умножения. Для решения этой задачи каждая переменная (фактически, каждый объект, который нужно отнести к тому или иному классу) выражается в виде точки в n-мерном пространстве, где n — это количество характеристик, которыми вы располагаете. Координаты каждой точки обозначают соответствующие характеристики. Далее алгоритм с помощью метода опорных векторов находит гиперплоскость, которая пролегает точно между группами наших объектов. Поскольку таких гиперплоскостей может быть больше одной, необходимо определить такую, которая пролегает на максимально далеком расстоянии от каждого объекта. Очевидно, это обеспечивает наилучшую классификацию. 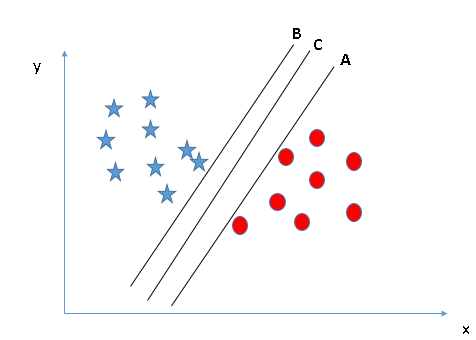 Метод работает и в том случае, если объекты распределяются иным образом, например, одна группа кольцом окружает другую. Дата-сайентист преобразует одно пространство в другое, с которым далее можно проводить операции.
Метод главных компонент (Principal Component Analysis, PCA)
Очень часто эксперту по Data Science приходится работать с наборами данных, которые включают сотни и тысячи переменных. Большинство из них не представляют практического смысла, но даже если отсеять 99 мусорных процентов, на анализ оставшихся данных может потребоваться слишком много времени и ресурсов. В таких случаях используются техники уменьшения размерности (dimensionality reduction), которые определяют переменные, сильнее всего влияющие на результат. Один из наиболее применимых методов для решения таких задач — метод главных компонент. Если не углубляться в математику, достаточно сказать, что таким образом можно найти основные векторы и спроецировать остальные данные согласно им. Если хотите узнать подробнее, почитайте о вычислении собственных векторов и собственных значений ковариационной матрицы.
Сингулярное разложение (Singular Value Decomposition)
Еще один способ понизить размерность без потери значительной доли ценной информации. Если у вас есть исходная матрица с большим объемом данных, вы можете разложить ее на меньшие матрицы, которые будут обладать теми же свойствами. Это отличный способ получить полезный результат в шумных условиях или в тех случаях, когда информации, напротив, не хватает. Например, Netflix применяет SVD в своих рекомендательных системах, где объем исходной информации (количество фильмов в базе) несравнимо превышает объем информации рабочей (количество фильмов, которые посмотрел пользователь). Кроме того, таким образом оказывается удобно обрабатывать изображения и музыку, сжимая их с минимальным ущербом качеству.
Станьте дата-сайентистом и решайте амбициозные задачи с помощью нейросетей
Векторное представление слов (Word Embeddings)
Как нетрудно догадаться, этот метод используется для работы с текстом в NLP-системах (Natural Language Processing). Компьютеры не понимают человеческий язык, хотя в последнее время им и удается более-менее успешно производить обратное впечатление. Это становится возможным благодаря техникам «цифровизации» слов, которые переводят их семантическое значение в векторы. Для этого используются самые разные атрибуты — количество букв в слове, теги обозначения частей речи и грамматических отношений между ними, векторные нотации и многое другое. Эти данные помещаются в n-мерное пространство, где аналитическая модель определяет между ними взаимосвязи, выстраивает контекстные цепочки и так далее. Таким образом нейросеть может переварить некий языковой корпус и строить на его основе предложения. Собственных мыслей к компьютера нет, так что от своего лица он может только нести грамматически верную чушь. А понимать поступающие реплики и формировать ответы на них таким образом получается очень хорошо.
Латентный семантический анализ (Latent Semantic Analysis, LSA)
Когда вы читаете предложение «Я увидел каменный замок, на его воротах висел замок», вы легко распознаете значения двух омонимов. Аналогично, вам несложно подобрать синоним к какому-либо слову — вы понимаете его значение и представляете, чем можно его заменить. Однако компьютеру такие операции даются с трудом, и создателям NLP-продуктов приходится придумывать, как обеспечить их системе возможность понимать контекст. В этом им снова помогает алгоритм сингулярного разложения. Они разбивают некий объем текстовых материалов на меньшие матрицы, по которым можно соотнести тему, ее контекст и употребляемые термины. Такое разложение помогает найти внутренние связи в массивном наборе текстов и понимать контекстуальное значение слов.
Тензоры и работа с изображениями
Вектор — это простой массив данных, матрица — двухмерный массив, а тензор объединяет n измерений, где n>2. Компьютерные системы используют эти структуры, чтобы видеть и понимать изображения. Для передачи цвета в цифровых изображениях используется шкала RGB — Red, Green, Blue. Когда аналитическая модель получает некую картинку, она создает тензор, который объединяет в себе три матрицы, у которых в каждой ячейке хранится цветовое значение соответствующего пикселя. Первая такая матрица содержит значения красного, вторая — зеленого, третья — синего. Пример того, как дальше можно работать с этими данными в следующем пункте.
Функция свертки
Напоследок рассмотрим функцию свертки, которая позволяет определять объекты на изображениях. Механика, в общем-то, напоминает работу человеческого мозга — модель запоминает некий образ, а потом внимательно рассматривает предложенную картинку, чтобы найти его среди пикселей. Для компьютера такой образ представляет собой сумму значений пикселей, которые составляют изображение целевого объекта. Эта сумма называется ядром. Имея в своем распоряжении такое ядро, программа поочередно сравнивает его с разными участками изображения. В том участке, где совпадение оказывается максимальным, она и предполагает наличие искомого объекта. Этот механизм также можно использовать, чтобы повысить или понизить четкость изображений, наложить на него разнообразные фильтры. Принцип один и тот же — когда нейросеть распознает определенные объекты, она может проводить с ним требуемые операции.

Data Scientist
Дата-сайентисты решают поистине амбициозные задачи. Научитесь создавать искусственный интеллект, обучать нейронные сети, менять мир и при этом хорошо зарабатывать. Программа рассчитана на новичков и плавно введет вас в Data Science. 24 месяца
Линейная алгебра в переводе на нормальный язык
Несмотря на целых два курса линейной алгебры, все мои знания о ней состояли из «матриц, определителей, чего-то там собственного».
Почему так? Давайте разберемся в особенностях моего курса:
- Название курса «Линейная алгебра», но почему-то упор делается на термины вроде матриц и векторов
- Суть обучения сводилась к порядку строк/колонок с мнемоникой вместо пояснения самого смысла происходящего
- Предпочтение отдавалось абстрактным примерам (2-мерные векторы! 3-мерные векторы!), и до самой последней недели мы всячески избегали примеров из реального мира
В таком тяжелом бою между терминологией и смыслом выживают только физики, графические программисты и прочие мазохисты. Мы упустили главный момент:
Линейная алгебра предоставляет вам мини-таблицы для математических уравнений.
Можно взять таблицу данных (матрицу) и создать обновленные таблицы на ее основе. В этом и есть сила таблицы вычислений, написанной в виде уравнения.
Мне бы очень помогло такое введение в линейную алгебру на своем курсе, с пояснением на примере фондовой биржи из реального мира.
Что в имени тебе моем?
«Алгебра», грубо говоря, означает, «связи». Алгебра в начальной школе раскрывает связи между неизвестными числами. Не зная x и y, мы все равно можем узнать, что (x + y) 2 = x 2 + 2xy + y 2
«Линейная алгебра» означает, в общем смысле, «линейно-подобные связи». Тут остановимся поподробнее.
Прямые линии предсказуемы. Представьте себе, будто вы идете по крыше: поднимитесь на три метра вверх по склону, и вы подниметесь ровно на 1 метр над уровнем земли (Вы же движетесь по склону! Вертикальный подъем/пройденный путь = 1/3). Пройдите 6 метров, и вы уже подниметесь над землей на целых 2 метра. Сравните подъем по крыше со взбиранием по куполу: каждый метр, пройденный по горизонтали, поднимает вас на разную высоту над землей.
Линии очень милые и предсказуемые:
- Если 3 метра вперед подымают на 1 метр, тогда пройденный путь длиной в 10х раз больше должен поднять вас над землей на 10х высоту (30 метров пути дают 10-метровый подъем)
- Если 3 метра, пройденных по крыше, подымают человека на 1 метр над землей, а 6 метров пути дают подъем на 2 метра, тогда (3 + 6) метров пути должны подымать на (1 + 2) метра
Выражаясь математическим языком, операция F является линейной, если масштабирование исходных параметров масштабирует ее значение:
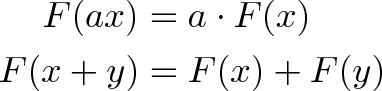
В нашем примере, F(x) вычисляет подъем при движении вверх по склону крыши на x метров, и сохраняются такие соотношения:
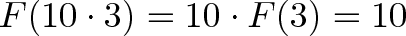
Линейные операции
Операция — это вычисление, основанное на некоторых входных параметрах. Какие операции являются линейными и предсказуемыми? Похоже, операция умножения как раз хороший пример.
Экспоненты (F(x)=x 2 ) не являются предсказуемыми: 10 2 равно 100, но 20 2 равно 400. Мы удвоили входной параметр, но учетверили результат.
Вы удивитесь, но обычное сложение также нелинейно. Рассмотрим функцию «плюс три»:
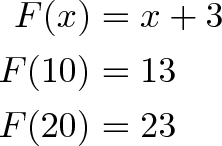
Мы удвоили аргумент (входное значение) и не удвоили результат. (Да, функция F(x) = x + 3 представляет собой уравнение прямой линии, но она всё равно не «линейная», потому что F(10) не равно 10*F(1). Забавно.)
Наша единственная надежда — умножение на константу: F(x) = ax (в нашем примере с крышей a=1/3). Тем не менее, мы всё еще можем комбинировать линейные операции для создания новой линейной операции:
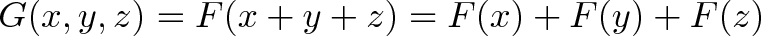
G состоит из 3 линейных кусочков: если мы удвоим аргументы, у нас удвоится значение самой функции.
Тут мы пустим в ход «мини-арифметику»: умножайте аргументы на константу и складывайте результаты. Это довольно полезный прием, потом что он позволяет разделить аргументы, проанализировать их индивидуально, а затем сложить результаты:
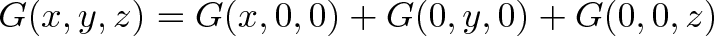
Если бы аргументы вели себя как экспоненты, разделить их не получилось бы — тут следует анализировать всё сразу, а не по отдельности.
Организация аргументов и операций
Большинство курсов математики бросают вам в лицо детали матрицы. «Ну что ж, детишки, давайте научимся говорить. Берем существительное, глагол и прилагательное. Далее, спрягаем глагол. Затем добавляем предлоги…»
НЕТ! Суть не в грамматике. В чем заключается основная идея? Как пояснить суть процесса?
- У нас есть набор входных параметров для анализа
- У нас есть предсказуемые, линейны операции (наша «мини-арифметика»)
- Мы генерируем результат, возможно, снова его трансформируя
Хорошо. Для начала нам нужно отследить набор входных параметров? Как насчёт того, чтобы представить их в виде списка:
x y z
Неплохо. Мы бы могли написать то же самое в виде строки (x, y, z) — держитесь за эту мысль.
Далее, как же нам контролировать наши операции? Помните, у нас есть только «мини-арифметика»: умножения и конечное сложение. Если наша операция F ведет себя так:
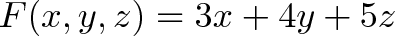
То мы бы могли сократить написание всей функции до (3, 4, 5). Мы знаем, что нужно умножить первый аргумент на первую цифру, второй аргумент на вторую и т.д. и сложить результат.
Нужен только первый аргумент?
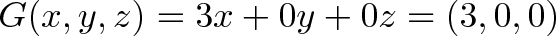
Давайте добавим остроты: как организовать множество наборов входных параметров? Допустим, мы хотим произвести операцию F над аргументами (a, b, c) и (x, y, z). Можно попробовать так:
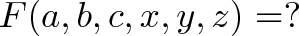
Но это не сработает: операция F работает только с 3 аргументами, а не с 6. Нужно разделить аргументы на группы:
1-я группа 2-я группа ------------------------- a x b y c z
А как в таком случае прогнать один и тот же аргумент через несколько операций? Для каждой операции должна быть своя строка:
F: 3 4 5 G: 3 0 0
Как всё аккуратно. У нас вырисовывается структура: аргументы в вертикальных колонках, а операции в горизонтальных строках.
Визуализируем матрицу
В математике слов недостаточно. Я покажу, как визуализирую аргументы, операции и результаты:
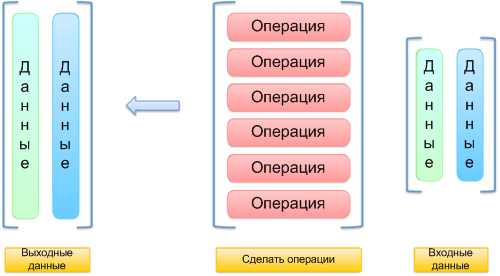
Представьте себе как будто вы «наливаете» каждый вводный параметр в каждую операцию:
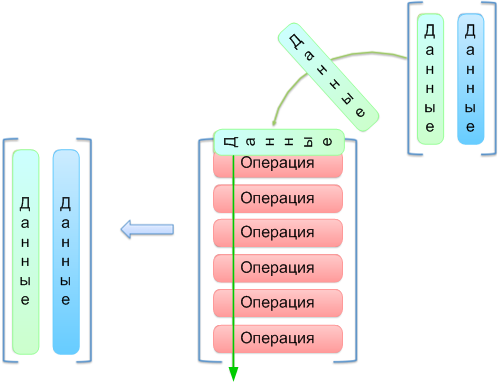
По мере прохождения аргумента через операцию создается результат (значение операции). В нашем примере аргумент (a, b, c) проходит через операцию F и выдает результат 3a + 4b + 5c. Затем он проходит через операцию G и образовывает результат 3a + 0 + 0.
Настало время красной таблетки. Матрица представляет собой условное обозначение наших диаграмм:
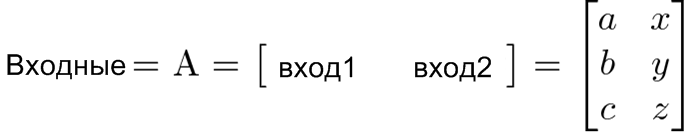
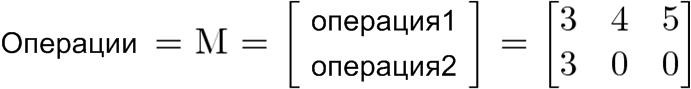
Матрица — это единая переменная, представляющая собой таблицу аргументов или операций.
Хитрость #1: Порядок чтения
Вместо последовательности аргумент => матрица => результат, мы используем запись вызова функции, например, y = f(x) или f(x) = y. Обычно матрица обозначается заглавной буквой (F), а одинарная колонка аргумента — маленькой буквой (х). Так как у нас есть несколько аргументов (А) и несколько результатов (В), их тоже рассматривают в качестве матрицы:
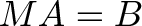
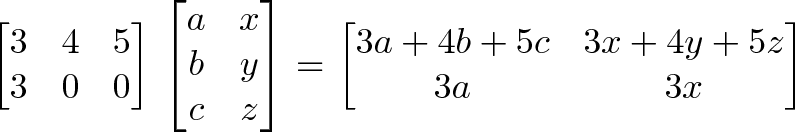
Хитрость #2: Нумерация
Размер матрицы измеряется как СxК: количество строк, количество колонок. Элементы в матрице обозначаются таким же образом: aij — элемент i-й строки j-й колонки (на доске «i» и «j» очень легко перепутать, глядя издалека). Мнемоника отлично запоминается с помощью контекста, и вот что мне приходит на ум:
- СК — сокращенно от «система координат» или «спортивный клуб»
- Для поиска нужного элемента матрицы двигайтесь по матрице по перевернутой букве Г ( или латинской букве L): сместитесь вниз на i, а затем вправо на j позиций
Почему представлять матрицу в виде СК имеет смысл? Матрица операций в нашем примере имеет размер 2×3, а матрица аргументов — 3×2. Если написать их вместе, получится:
[Матрица операций] [Матрица аргументов] [число операций x размер операций] [размер аргументов x количество аргументов] [m x n] [p x q] = [m x q] [2 x 3] [3 x 2] = [2 x 2]
Заметьте, что матрицы касаются «размера операций» и «размера аргументов» (n = p). Они должны быть равны! Если аргумент состоит из 3 компонентов, то операция тоже будет содержать 3 элемента. На самом деле, мы можем только умножать матрицы при n = p.
Матрица результатов содержит m строк операций для каждого аргумента, и q аргументов дает матрицу размером «m x q».
Более навороченные операции
Давайте освоим операции получше. Имея 3 аргумента, мы можем соорудить несколько 1-операционных матриц:
- Сумматор: [1 1 1]
- Усреднитель: [1/3 1/3 1/3]
«Сумматор» — это просто a + b + c. «Усреднитель» работает по принципу: (a + b + c)/3 = a/3 + b/3 + c/3.
Попробуйте эти 1-линейники:
- Есть только первый аргумент: [1 0 0]
- Только второй аргумент: [0 1 0]
- Только третий аргумент: [0 0 1]
Объединив всё это в одну матрицу, мы получим:
[1 0 0] [0 1 0] [0 0 1]
Ухты — да это же «единичная матрица», которая копирует 3 аргумента в 3 результата без изменений. А как насчёт такого варианта?
[1 0 0] [0 0 1] [0 1 0]
Он меняет местами аргументы: (x, y, z) становится (x, z, y).
[2 0 0] [0 2 0] [0 0 2]
А это уже удвоитель аргументов. Мы можем переписать его в виде 2*I (I — единичная матрица).
- Масштаб: делает все аргументы больше/меньше
- Наклон: делает определенные аргументы больше/меньше
- Зеркальное отображение: аргументы становятся отрицательными
- Поворот: генерирует новые координаты на основе старых (восток стает севером, север — западом и т.д.)
Это всё геометрические интерпретации умножения и способы деформации векторного пространства. Просто помните, что векторы — это просто примеры данных, которые можно изменять.
Невекторный пример: портфель ценных бумаг
Давайте попрактикуем линейную алгебру в реальном мире:
- Аргументы: портфель ценных бумаг с долларами в акциях Apple, Google и Microsoft
- Операции: изменения в стоимости компаний вследствие выпуска новостей
- Результат: обновленный портфель
И бонусный результат: давайте создадим новый портфель, содержащий прибыль/потери от конкретного события.
Обычно мы бы отслеживали изменения в таблице. Но давайте научимся думать методами линейной алгебры:
- Входной вектор мог бы быть ($Apple, $Google, $Microsoft), показывая сумму в каждом виде акций. (Эти значения могут быть получены из другой матрицы, которая просто умножила количество акций на их цену. Представьте себе!)
- 4 операции для результата могут включать: обновить стоимость акций Apple, обновить стоимость акций Google, обновить стоимость акций Microsoft, вычислить прибыль
А теперь визуализируем задачу. Представьте себе проход по каждой операции:
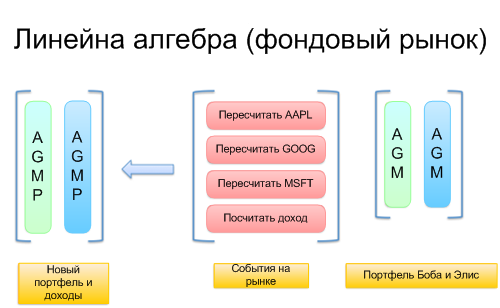
Тут важно понять, почему мы вообще строим такую матрицу, а не оперируем цифрами вслепую.
Давайте пройдемся по сценарию.
Допустим, выпустили секретный iDevice: акции Apple подпрыгнули на 20%, Google подешевели на 5%, а Microsoft остался на прежнем уровне. Мы хотим обновить стоимость каждой акции, используя нечто, похожее на единичную матрицу:
Новая цена Apple [1,2 0 0] Новая цена Google [ 0 0,95 0] Новая цена Microsoft [ 0 0 1]
Новая цена Apple представляет собой оригинальную цену, увеличенную на 20% (Google = 5% рост, Microsoft = без изменений).
Подождите! Нам же еще нужна совокупная прибыль:
Общая прибыль = (0,20 * Apple) + (-0,05 * Google) + (0 * Microsoft)
Конечная матрица операций имеет вид:
Новая цена Apple [1.2 0 0] Новая цена Google [ 0 0.95 0] Новая цена Microsoft [ 0 0 1] Общая прибыль [.20 -.05 0]
Вам стало понятнее? Три аргумента на входе, четыре значения на выходе. Первые три представляют собой «измененную копию», а четвертая представляет собой сумму всех изменений.
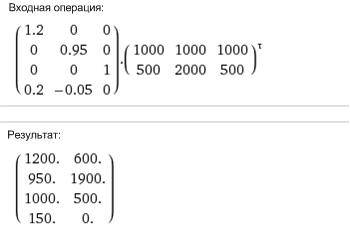
(Примечание: Входные параметры должны быть представлены в колонках, но проще печатать их в виде строк. Операция Transpose (транспонирование), обозначенная буквой t (тау), конвертирует строки в колонки).
Конечные цифры: у Ани теперь акций AAPL на $1200, GOOG на $950, и MSFT на $1000, а совокупная прибыль составила $150. У Пети акций AAPL на $600, GOOG на $1900, и MSFT на $500, при совокупной прибыли $0.
Что происходит? Мы делаем вычисления в нашей таблице. Линейная алгебра появилась в 1800-х годах, а вот динамические таблицы были изобретены только в 1980-х. Я связываю такой огромный промежуток между этими двумя изобретениями с плохим преподаванием линейной алгебры.
Историческая справка: Решение системы уравнений
Ранним применением таблиц чисел (еще не «матриц») была запись систем линейных уравнений:
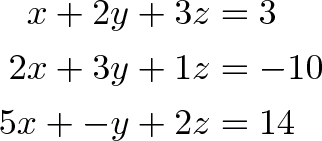
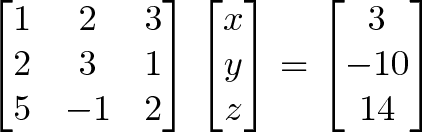
Можно попросту складывать/вычитать строки в матрице и выводе, вместо многочисленных переписываний полной системы уравнений. По мере того, как матрица преобразовывается в единичную матрицу, значения x, y и z появляются на стороне вывода.
Этот процесс, названный исключением по Гауссу-Жордану с выбором главного элемента, экономит время. Несмотря на это, линейная алгебра больше касается трансформаций матрицы, а не решения огромных систем уравнений (это всё равно что использовать Excel для составления списка покупок).
Терминология, определители, собственный вектор и число
У слов есть технические категории для описания их применения (существительные, глаголы, прилагательные). Матрицы можно разделить таким же образом.
Описания вроде «верхний треугольник», «симметричная», «диагональная» показывают форму матрицы. Они также влияют на ее возможные трансформации.
Определитель — это «размер» преобразования матрицы на выходе. Если вводным параметром был единичный вектор (представляет площадь размером 1), определитель — это размер трансформированной площади или объема. Определитель 0 означает, что матрица «деструктивная» и не может иметь обратную матрицу (это всё равно, что умножение на 0: информация попросту теряется).
Собственный вектор и собственное число представляют собой «оси» преобразования. Представьте себе, как крутите глобус: любая точка на глобусе кроме полюсов движется по своей траектории. «Собственный вектор» — это вводный параметр, который не изменяет направление при прохождении через матрицу (он расположен «вдоль оси»). И хотя направление не изменяется, размер может меняться. Собственное значение — это число, обозначающее, во сколько раз уменьшается или увеличивается собственный вектор при прохождении через матрицу.
Матрицы в качестве входных значений
Мы ведь можем использовать матрицы операций в качестве входных параметров!
Представьте рецепт как список команд (досыпьте два стакана сахара, три стакана муки…). А что, если нам нужна метрическая версия, применимая для любых дозировок продуктов? Сами инструкции воспринимайте как простой текст, а единицы конвертируйте в нужные. Рецепт — это не что иное, как «аргумент», который нужно изменить. После перевода всех единиц в нужные нам, можно снова последовать инструкциям и приготовить вкусняшку.
Матрица операций — это нечто похожее: набор команд, которые надо преобразовать. Применяя одну матрицу операций к другой, вы получите новую матрицу операций, в которой применяются оба преобразования, по порядку.
Если N — это «изменить портфель согласно новостям», а Т — «изменить портфель, вычтя налоги», то применение обоих операций записывается как:
и означает «Создайте матрицу X, которая сначала изменяет портфель согласно новостям, а потом согласно налогам». И тут нам даже не понадобились входные данные по портфелям, мы просто применили одну матрицу к другой.
Красота линейной алгебры состоит в возможности представить целую таблицу вычислений одной буквой. Хотите применить одно и то же преобразование несколько раз? Используйте N 2 или N 3 .
Скажите, пожалуйста, а можно использовать простое сложение?
Да, потому что вы очень вежливо попросили. Наша «мини-арифметика» кажется довольно ограниченной: умножение, но не сложение? Пора расширить рамки своего мышления.
Представьте добавление простой единицы в матрицу вводных параметров: (x, y, z) превращается в (x, y, z, 1).
Теперь в матрице операций появилось еще одно значения, с которым нужно поработать! Если мы хотим x + 1 , мы можем написать:
[1 0 0 1]
А x + y – 3 будет выглядеть так:
[1 1 0 -3]
Хотите эксцентричных пояснений? Мы представляем, будто бы наш аргумент существует в измерении на 1 порядок выше, и в этом измерении мы размещаем «1». Мы смещаем большую размерность, которая выглядит как наклонная плоскость в текущей размерности. Например, возьмите аргумент (x, y, z, 1) и пропустите его через:
[1 0 0 1] [0 1 0 1] [0 0 1 1] [0 0 0 1]
Результатом будет (x + 1, y + 1, z + 1, 1). Игнорируя 4-ю размерность, каждый входной аргумент получил +1. Можно продолжить добавлять измерения в матрицу и сгенерировать еще больше дополнительных плоскостей.
Мини-арифметика не такая уж и ограниченная.
Заглядывая наперед
Я опустил некоторые премудрости линейной алгебры, но не сильно переживаю на этот счёт. Почему? Эти метафоры помогают мне мыслить матрицами больше, чем все те курсы, которые я закончил «на отлично». Я, наконец, на вопрос «В чем польза от линейной алгебры?» я могу ответить теми же аргументами, «Почему полезны динамические таблицы?».
Они не несут никакой пользы, если только вам не нужен инструмент, способный решить любую задачу из реального мира. Поинтересуйтесь у бизнесменов, что они выберут: пожертвовать свою почку или навсегда лишиться Excel. Это и есть сила линейной алгебры, которую мы упустили при изучении в университете: удобная система обозначений, позволяющая привнести табличные вычисления в обычные математические уравнения.
Линейная алгебра для Data Science и Machine Learning
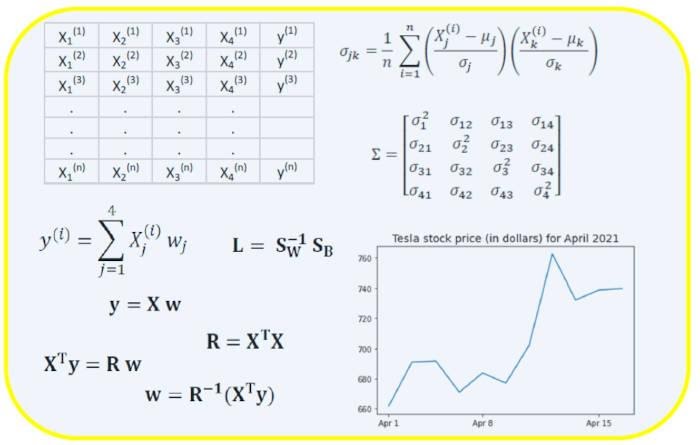
Линейная алгебра в Data Science и Machine Learning является основополагающей. Новички, начинающие свой путь обучения в области Data Science, а также признанные практики должны развить хорошее понимание основных понятий линейной алгебры.
Специально к новому старту курса математика и Machine Learning для Data Science делимся переводом статьи Бенджамина Оби Тайо — физика, кандидата наук и преподавателя Data Science — о том, что нужно знать, чтобы лучше понимать Data Science и Machine Learning.
Линейная алгебра — это раздел математики, который чрезвычайно полезен в Data Science и машинном обучении. Владение линейной алгеброй — это также самый важный математический навык в машинном обучении. Большинство моделей машинного обучения могут быть выражены в матричном виде. Сам набор данных часто представляется в виде матрицы. Линейная алгебра используется при предварительной обработке данных, в преобразовании данных и оценке моделей. Вот темы, с которыми вы должны быть знакомы:
- Векторы.
- Матрицы.
- Транспонирование матрицы.
- Обратная матрица.
- Определитель матрицы.
- След матрицы.
- Скалярное произведение.
- Собственные значения.
- Собственные векторы.
В этой статье мы проиллюстрируем применение линейной алгебры в Data Science и Machine Learning с использованием набора данных рынка технологических акций, который можно найти здесь.
Линейная алгебра для предварительной обработки данных
Мы начнём с иллюстрации того, как линейная алгебра применяется для предварительной обработки данных.
Импорт необходимых библиотек линейной алгебры
import numpy as np import pandas as pd import pylab import matplotlib.pyplot as plt import seaborn as snsЧтение набора данных и отображение признаков
data = pd.read_csv("tech-stocks-04-2021.csv") data.head()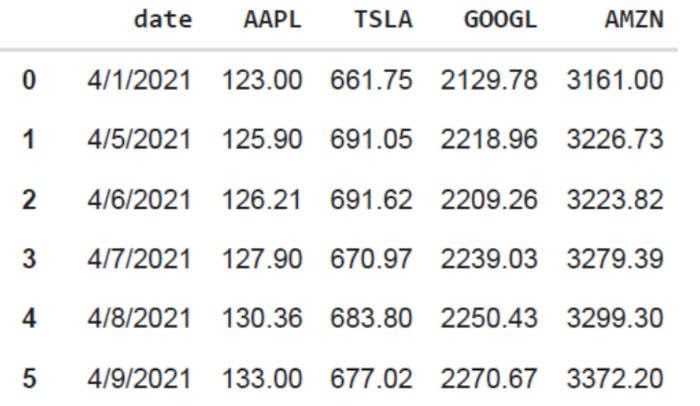
print(data.shape) output = (11,5) Функция data.shape позволяет нам узнать размерность нашего набора данных. В этом случае набор данных содержит 5 признаков (date, AAPL, TSLA, GOOGL и AMZN) и каждый содержит 11 наблюдений. Дата (date) относится к торговым дням в апреле 2021 года (до 16 апреля). AAPL, TSLA, GOOGL и AMZN — это цены закрытия акций Apple, Tesla, Google и Amazon соответственно.
Визуализация данных
Чтобы выполнить визуализацию данных, нужно определить столбцовые матрицы визуализируемых признаков:
x = data['date'] y = data['TSLA'] plt.plot(x,y) plt.xticks(np.array([0,4,9]), ['Apr 1','Apr 8','Apr 15']) plt.title('Tesla stock price (in dollars) for April 2021',size=14) plt.show()
Ковариационная матрица
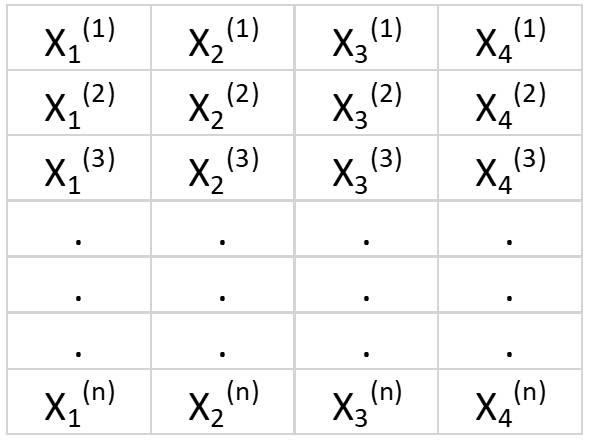
Ковариационная матрица является одной из наиболее важных матриц в Data Science и Machine Learning. Она предоставляет информацию о совместном движении (корреляции) между признаками. Предположим, у нас есть матрица признаков с 4 признаками и n наблюдениями, как показано в таблице 2:
Чтобы визуализировать корреляции между признаками, мы можем сгенерировать диаграмму рассеяния:
cols=data.columns[1:5] print(cols) output = Index(['AAPL', 'TSLA', 'GOOGL', 'AMZN'], dtype='object') sns.pairplot(data[cols], height=3.0)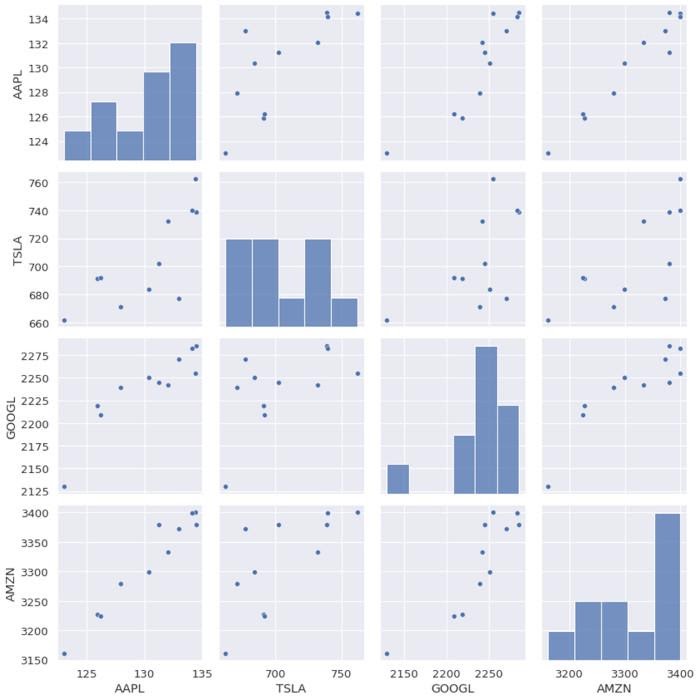
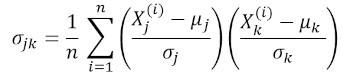
где μ и σ — среднее значение и стандартное отклонения признака соответственно. Это уравнение указывает, что при нормализации признаков матрица ковариации представляет собой просто точечное произведение между признаками. Ковариационная матрица может быть выражена в виде вещественной и симметричной матрицы 4 х 4:
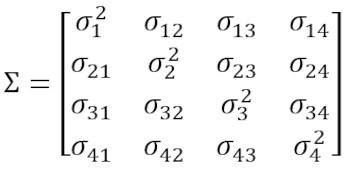
Эта матрица может быть преобразована в диагональную путём выполнения унитарного преобразования, также называемого преобразованием анализа главных компонентов (PCA), чтобы получить следующее:
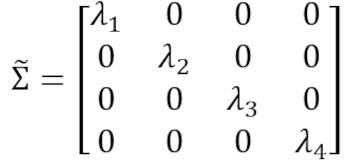
Поскольку след матрицы при унитарном преобразовании остаётся инвариантным, мы наблюдаем, что сумма собственных значений диагональной матрицы равна общей дисперсии, содержащейся в признаках X1, X2, X3 и X4.
Вычисление ковариационной матрицы для технологических акций
from sklearn.preprocessing import StandardScaler stdsc = StandardScaler() X_std = stdsc.fit_transform(data[cols].iloc[:,range(0,4)].values) cov_mat = np.cov(X_std.T, bias= True)Обратите внимание, что при этом используется транспонирование нормализованной матрицы.
Визуализация ковариационной матрицы
plt.figure(figsize=(8,8)) sns.set(font_scale=1.2) hm = sns.heatmap(cov_mat, cbar=True, annot=True, square=True, fmt='.2f', annot_kws=, yticklabels=cols, xticklabels=cols) plt.title('Covariance matrix showing correlation coefficients') plt.tight_layout() plt.show()
Из рисунка 3 видно, что AAPL сильно коррелирует с GOOGL и AMZN и слабо с TSLA. TSLA обычно слабо коррелирует с AAPL, GOOGL и AMZN, в то время как AAPL, GOOGL и AMZN сильно коррелируют друг с другом.
Вычисление собственных значений ковариационной матрицы
np.linalg.eigvals(cov_mat) output = array([3.41582227, 0.4527295 , 0.02045092, 0.11099732]) np.sum(np.linalg.eigvals(cov_mat)) output = 4.000000000000006 np.trace(cov_mat) output = 4.000000000000001 Мы наблюдаем, что, как и ожидалось, след ковариационной матрицы равен сумме собственных значений.
Вычисление кумулятивной дисперсии
Поскольку след матрицы остаётся инвариантным при унитарном преобразовании, мы наблюдаем, что сумма собственных значений диагональной матрицы равна общей дисперсии, содержащейся в признаках X1, X2, X3 и X4. Следовательно, мы можем определить следующие величины:

Обратите внимание, что когда p = 4, кумулятивная дисперсия, как и ожидалось, становится равной 1.
eigen = np.linalg.eigvals(cov_mat) cum_var = eigen/np.sum(eigen) print(cum_var) output = [0.85395557 0.11318237 0.00511273 0.02774933] print(np.sum(cum_var)) output = 1.0Из кумулятивной дисперсии (cum_var) мы видим, что 85 % дисперсии содержатся в первом собственном значении и 11 % — во втором. Это означает, что при реализации PCA могут использоваться только первые два основных компонента, поскольку 97 % общей дисперсии приходятся на эти 2 компонента. Это может существенно уменьшить размерность пространства признаков (с 4 до 2), когда реализован PCA.
Матрица линейной регрессии
Предположим, у нас есть набор данных, который имеет 4 признака предиктора и n наблюдений, как показано ниже.
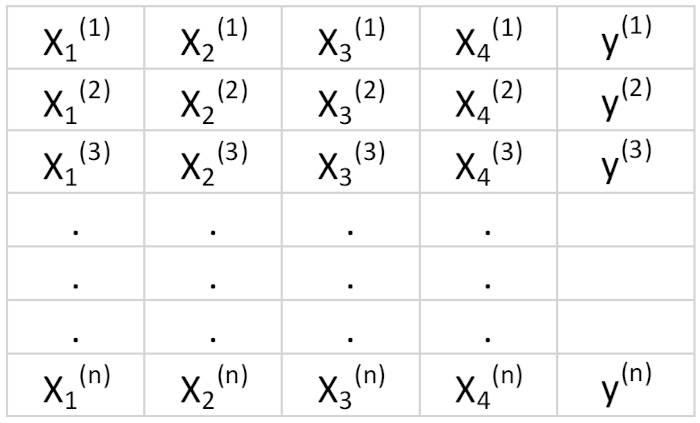
Мы хотели бы построить модель множественной регрессии для прогнозирования значений y (столбец 5). Таким образом, наша модель может быть выражена так:
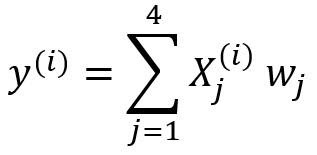
В матричном виде это уравнение можно записать так:
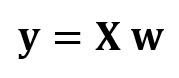
где X — матрица признаков (n x 4), w — матрица (4 x 1), представляющая определяемые коэффициенты регрессии, и y — матрица (n x 1), содержащая n наблюдений целевой переменной y.
Обратите внимание, что X является прямоугольной матрицей, поэтому мы не можем решить приведённое выше уравнение, взяв обратную X величину.
Чтобы преобразовать X в квадратную матрицу, мы умножаем левую и правую части нашего уравнения на транспонирование из X, то есть:
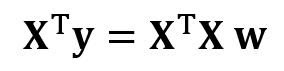
Это уравнение можно записать так:
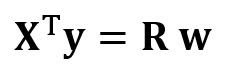
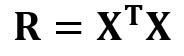
является матрицей регрессии (4×4). Мы наблюдаем, что R — это вещественная и симметричная матрица. Обратите внимание, что в линейной алгебре транспонирование произведения двух матриц подчиняется следующему соотношению:
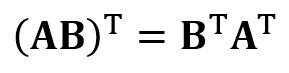
Теперь, когда мы сократили нашу задачу регрессии и выразили её в терминах (4×4) вещественной, симметричной и обратимой матрицы регрессии R, легко показать, что точное решение уравнения регрессии выглядит так:
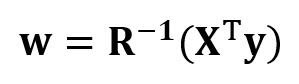
Примеры регрессионного анализа для прогнозирования непрерывных и дискретных переменных приведены ниже:
- Основы линейной регрессии для абсолютных новичков.
- Построение перцептронного классификатора с помощью метода наименьших квадратов.
Матрица линейного дискриминантного анализа
Другим примером реальной и симметричной матрицы в Data Science является матрица линейного дискриминантного анализа (LDA). Эта матрица может быть выражена так:
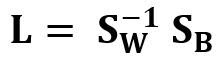
Где SW — матрица рассеяния в пределах признака (the within-feature scatter matrix), а SB — матрица рассеяния между признаками. Поскольку обе матрицы SW и SB вещественны и симметричны, из этого следует, что L также вещественна и симметрична. Диагонализация L создаёт подпространство признаков, которое оптимизирует раздельность классов и уменьшает размерность. Следовательно, LDA является алгоритмом обучения с учителем, а PCA — нет.
Чтобы узнать больше о реализации LDA, пожалуйста, ознакомьтесь со следующими ссылками:
- Машинное обучение: уменьшение размерности с помощью линейного дискриминантного анализа.
- Репозиторий GitHub для реализации LDA с использованием набора данных Iris.
- Машинное обучение Python от Себастьяна Рашки, 3-е изд. (глава 5).
Резюме
Итак, мы обсудили несколько применений линейной алгебры в Data Science и машинном обучении. Используя набор данных рынка технологических акций, мы проиллюстрировали важные понятия, такие как размер матрицы, столбцовые матрицы, квадратные матрицы, ковариационные матрицы, транспонирование матрицы, собственные значения, точечные произведения и т. д.
Линейная алгебра является важным инструментом в Data Science и машинном обучении. Таким образом, новички, интересующиеся Data Science, должны ознакомиться с основными понятиями линейной алгебры.
Чтобы в деталях разобраться с внутренней механикой Data Science, не оставив без внимания машинное обучение, вы можете присмотреться к нашему курсу математика и Machine Learning для Data Science, где опытные менторы и эксперты в своём деле ответят на сложные вопросы, устранят неясности и правильно направят ваши размышления, чтобы в дальнейшем вы решали сложные проблемы самостоятельно.
Узнайте, как прокачаться и в других специальностях или освоить их с нуля:
- Профессия Data Scientist
- Профессия Data Analyst
- Курс по Data Engineering
ПРОФЕССИИ
- Профессия Fullstack-разработчик на Python
- Профессия Java-разработчик
- Профессия QA-инженер на JAVA
- Профессия Frontend-разработчик
- Профессия Этичный хакер
- Профессия C++ разработчик
- Профессия Разработчик игр на Unity
- Профессия Веб-разработчик
- Профессия iOS-разработчик с нуля
- Профессия Android-разработчик с нуля
КУРСЫ
- Курс по Machine Learning
- Курс «Machine Learning и Deep Learning»
- Курс «Математика для Data Science»
- Курс «Математика и Machine Learning для Data Science»
- Курс «Python для веб-разработки»
- Курс «Алгоритмы и структуры данных»
- Курс по аналитике данных
- Курс по DevOps