Визуализация в Python. Seaborn
Для демонстрации визуализации данных при помощи библиотеки Seaborn будем использовать таблицу bank.csv, взятую из открытых источников, и доработанную мной для демонстрации возможностей нашей библиотеки.
Рассмотрим решение некоторых задач при помощи Seaborn:
1. Импортируем нужные библиотеки:
import pandas as pd from matplotlib import pyplot as plt import seaborn as sns
2. При помощи библиотеки Pandas открываем нужную таблицу
bank_data = pd.read_csv(‘C:/bank.csv’,delimiter=’,’) bank_data.head(S)
3. Количество записей и столбцов можно узнать при помощи функции »shape» из Pandas. В представленных банковских данных 4521 строка и 17 столбцов
bank_data.shape
4. При помощи функции »describe», все из той же Pandas, можно получить подробную информацию о столбцах, таких как: количество, среднее, минимальное и максимальное значения
bank_data.describe()
Из результатов, полученных при помощи оговоренной ранее функции, можно сделать ряд выводов:
- Минимальный возраст равен 19 лет, максимальный 87 лет, а средний возраст клиентов составляет 41 год;
- Минимальный баланс составляет -3313, максимальный 71188, а средний 1422,66;
- Максимальная продолжительность взаимодействия с клиентом длилась 3025 секунд, а минимальное время равняется 4 секундам;
- В рамках одного договора максимальное взаимодействие с клиентом равно 50, минимальное 1.
Далее будем визуализировать имеющиеся данные, а также рассмотрим, как некоторые столбцы соотносятся с целевым столбцом.
1. Соотношение баланса и взятых кредитов, среди клиентов с балансом от 0 до 1400, больше тех, кто не подали заявку на кредит, чем тех, кто это сделал
sns.set_style(‘whitegrid’) plt.figure(figsize = (14,7)) sns.barplot(bank_data[‘loan’], y = bank_data[‘balance’])
2. Из следующей диаграммы можно понять, что больше клиентов заключили договор на кредит, при этом с ними связывались 3 раза.
sns.set_style(‘whitegrid’) plt.figure(figsize = (14,7)) sns.barplot(x = bank_data[‘loan’], y = bank_data[‘campaign’])
Теперь рассмотрим работу с данными, которые представляют из себя категории. Для большего понимания они приведены ниже.
1. Из диаграмм, приведенных ниже, можно сделать вывод, что люди, занимающие руководящие должности, заключили договор на кредит в большем количестве относительно остальных.
sns.set_style(‘whitegrid’) plt.figure(figsize = (14,7)) sns.countplot(bank_data[‘job’])
2. Из диаграммы, приведенной далее, можно сделать вывод, что среди заключивших договор на кредит больше людей состоящих в браке, чем одиноких или с неизвестным семейным положением.
sns.set_style(‘whitegrid’) plt.figure(figsize = (14,7)) sns.countplot(bank_data[‘marital’])
3. В кредитовании в большей степени участвовали люди со средним образованием.
Топ-10 библиотек Python для Data Science
Уже довольно давно Python очаровывает ученых, занимающихся данными. Чем больше я взаимодействую с ресурсами, литературой, курсами, тренингами и людьми в науке о данных, тем более глубокие знания Python приобретаю. При этом, когда я только начинал развивать свои навыки Python, у меня был целый список библиотек, о которых мне предстояло узнать. И вот, через некоторое время.
Специалисты в области Data Science точно знают о библиотеках Python, которые можно использовать в науке о данных, но когда в интервью просят назвать их или указать их функцию, мы часто попадаем впросак или, возможно, не помним более 5 библиотек (это случилось со мной: / )
Сегодня я подготовил список из 10 библиотек Python, которые помогают в области Data Science, когда их использовать, каковы их особенности и преимущества.
В этой статье я кратко изложил 10 наиболее полезных библиотеках Python для data scientist’ов и инженеров, основываясь на моем недавнем опыте и исследованиях. Читайте статью до конца, чтобы узнать о 4 бонусных библиотеках!
1. Pandas
Pandas — это пакет Python с открытым исходным кодом, который предоставляет высокоэффективные, простые в использовании структуры данных и инструменты анализа для помеченных данных на языке программирования Python. Pandas расшифровывается как библиотека анализа данных Python. Кто-нибудь знал об этом?
Когда использовать? Pandas — это идеальный инструмент для обработки данных. Он предназначен для быстрой и простой обработки данных, чтения, агрегирования и визуализации.
Pandas берет данные в файле CSV или TSV или базу данных SQL и создает объект Python со строками и столбцами, который называется фреймом данных. Фрейм данных очень похож на таблицу в статистическом программном обеспечении, скажем, в Excel или SPSS.
Что можно делать с помощью Pandas?
1. Индексирование, манипулирование, переименование, сортировка, объединение фрейма данных;
2. Обновить, добавить, удалить столбцы из фрейма данных;
3. Восстановить недостающие файлы, обработать недостающие данные или NAN;
4. Построить гистограмму или прямоугольную диаграмму.
Это делает Pandas фундаментальной библиотекой в изучении Python для Data Science. Если вам интересно узнать 10 приемов Python Pandas, которые сделают вашу работу более эффективной, читайте нашу статью.
2. NumPy
NumPy — один из самых фундаментальных пакетов в Python — универсальный пакет для обработки массивов. Он предоставляет высокопроизводительные объекты многомерных массивов и инструменты для работы с массивами. NumPy — это эффективный контейнер универсальных многомерных данных.
Основной объект NumPy — это однородный многомерный массив. Это таблица элементов или чисел одного и того же типа данных, проиндексированная набором натуральных чисел. В NumPy размеры называются осями, а число осей называется рангом. Класс массива NumPy называется ndarray, он же array.
Когда использовать? NumPy используется для обработки массивов, в которых хранятся значения одного и того же типа данных. NumPy облегчает математические операции над массивами и их векторизацию. Это значительно повышает производительность и, соответственно, ускоряет время выполнения.
Что можно делать с помощью NumPy?
1. Основные операции с массивами: добавление, умножение, срез, выравнивание, изменение формы, индексирование массивов;
2. Расширенные операции с массивами: стековые массивы, разбиение на секции, широковещательные массивы;
3. Работа с DateTime или линейной алгеброй;
4. Основные нарезки и расширенное индексирование в NumPy Python.
О 4 приемах Python NumPy, которые должен знать каждый новичок, читайте здесь.
3. SciPy
Библиотека SciPy является одним из ключевых пакетов, которые составляют стек SciPy. Теперь есть разница между SciPy Stack и библиотекой SciPy. SciPy основывается на объекте массива NumPy и является частью стека, который включает в себя такие инструменты, как Matplotlib, Pandas и SymPy с дополнительными инструментами.
Библиотека SciPy содержит модули для эффективных математических процедур, таких как линейная алгебра, интерполяция, оптимизация, интеграция и статистика. Основной функционал библиотеки SciPy построен на NumPy и его массивах.
Когда использовать? SciPy использует массивы в качестве базовой структуры данных. Он имеет различные модули для выполнения общих задач научного программирования, таких как линейная алгебра, интеграция, матанализ, обыкновенные дифференциальные уравнения и обработка сигналов.
Что можно делать с помощью SciPy?
1. Математические, научные, инженерные вычисления;
2. Процедуры численной интеграции и оптимизации;
3. Поиск минимумов и максимумов функций;
4. Вычисление интегралов функции;
5. Поддержка специальных функций;
6. Работа с генетическими алгоритмами;
7. Решение обыкновенных дифференциальных уравнений.
4. Matplotlib
Это, несомненно, моя любимая и основная библиотека Python. Вы можете создавать истории с данными, визуализированными с помощью Matplotlib. Еще одна библиотека из стека SciPy — Matplotlib — строит 2D-фигуры.
Когда использовать? Matplotlib — это библиотека Python, предоставляющая API для встраивания графиков в приложения. Очень напоминает MATLAB, встроенный в язык программирования Python.
Что можно делать с помощью Matplotlib?
Гистограммы, столбцовые диаграммы, точечные диаграммы, круговые диаграммы — Matplotlib может отображать широкий спектр визуализаций. Приложив немного усилий, с Matplotlib, вы можете создавать любые визуализации:
1. Линейные диаграммы;
2. Точечные диаграммы;
3. Диаграммы с областями;
4. Столбцовые диаграммы и гистограммы;
5. Круговые диаграммы;
6. Диаграммы «стебель-листья»;
7. Контурные графики;
8. Поля векторов;
Matplotlib также облегчает использование меток, сеток, легенд и некоторых других объектов форматирования. В общем, речь идет обо всем, что можно нарисовать!
5. Seaborn
Итак, когда вы читаете официальную документацию по Seaborn, она определяется как библиотека визуализации данных на основе Matplotlib, предоставляющем высокоуровневый интерфейс для изображения интересных и информативных статистических графиков. Проще говоря, seaborn — это расширение Matplotlib с дополнительными возможностями.
Так в чем разница между Matplotlib и Seaborn? Matplotlib используется для основного построения столбцовых, круговых, линейных, точечных диаграмм и пр., в то время как Seaborn предоставляет множество шаблонов визуализации с меньшим количеством синтаксических правил, причем более простых.
Что можно делать с помощью Seaborn?
1. Определять отношения между несколькими переменными (корреляция);
2. Соблюдать качественные переменные для агрегированных статистических данных;
3. Анализировать одномерные или двумерные распределения и сравнивать их между различными подмножествами данных;
4. Построить модели линейной регрессии для зависимых переменных;
5. Обеспечить многоуровневые абстракции, многосюжетные сетки.
Seaborn — это отличный вариант для библиотек визуализации R, таких как corrplot и ggplot.
6. Scikit Learn
Scikit Learn, представленный миру как проект Google Summer of Code, представляет собой надежную библиотеку машинного обучения для Python. Он включает в себя алгоритмы ML, такие как SVM, random forests, k-means кластеризацию, спектральную кластеризацию, сдвиг среднего значения, перекрестную проверку и многие другие. Даже NumPy, SciPy и связанные с ними научные операции поддерживаются Scikit Learn, при этом Scikit Learn является частью SciPy Stack.
Когда использовать? Scikit-learn предоставляет ряд контролируемых и неконтролируемых алгоритмов обучения через согласованный интерфейс в Python. Scikit learn будет вашим руководством для того, чтобы модели контролируемого обучения, такие как Naive Bayes, группировали непомеченные данные, такие как KMeans.
Что можно делать с помощью Scikit Learn?
1. Классификация: обнаружение спама, распознавание изображений;
2. Кластеризация: воздействия лекарственных препаратов, цена акций;
3. Регрессия: сегментация клиентов, группировка результатов эксперимента;
4. Уменьшение размерности: визуализация, повышенная эффективность;
5. Выбор модели: повышенная точность благодаря настройке параметров;
6. Предварительная обработка: подготовка входных данных в виде текста для обработки с помощью алгоритмов машинного обучения.
Scikit Learn фокусируется на моделировании данных; не манипулировании данными. Для обобщения и манипуляции у нас есть NumPy и Pandas.
7. TensorFlow
Еще в 2017 году я получил TensorFlow USB в знак признательности за то, что был потрясающим докладчиком на мероприятии Google WTM, хаха. На USB был загружен официальный документ о TensorFlow. Не имея представления о том, что такое TensorFlow, я его погуглил.
TensorFlow — это библиотека AI, которая помогает разработчикам создавать крупномасштабные нейронные сети со многими слоями, используя графики потоков данных. TensorFlow также облегчает построение моделей глубокого обучения, продвигает современную технологию ML / AI и позволяет легко развертывать приложения на базе ML.
Одним из наиболее развитых веб-сайтов среди всех библиотек является TensorFlow. Гиганты, такие как Google, Coca-Cola, Airbnb, Twitter, Intel, DeepMind, все используют TensorFlow!
Когда использовать? TensorFlow достаточно эффективен, когда дело доходит до классификации, восприятия, понимания, обнаружения, прогнозирования и создания данных.
Что можно делать с помощью TensorFlow?
1. Распознавание голоса / звука — IoT, автомобильная промышленность, безопасность, UX/UI, телекоммуникации;
2. Анализ настроений — в основном для CRM или CX;
3. Текстовые Приложения — Обнаружение угроз, Google Translate, Gmail Smart Reply;
4. Распознавание лиц — Facebook’s Deep Face, Photo tagging, Smart Unlock;
5. Временной ряд — рекомендации от Amazon, Google и Netflix;
6. Обнаружение видео — обнаружение движения, обнаружение угроз в реальном времени в играх, безопасности, аэропортах.
Более подробно о TensorFlow рассказываем в статье.
8. Keras
Keras — это высокоуровневый API TensorFlow для создания и обучения кода глубоких нейронных сетей. Это библиотека нейронных сетей с открытым исходным кодом на Python. С Keras статистическое моделирование, работа с изображениями и текстом намного легче с упрощенным кодированием для глубокого обучения.
В чем разница между Keras и TensorFlow?
Keras — это нейросетевая библиотека, написанная на языке Python, а TensorFlow — это библиотека с открытым исходным кодом для различных задач машинного обучения. TensorFlow предоставляет как высокоуровневые, так и низкоуровневые API, в то время как Keras предоставляет только высокоуровневые API. Keras создан для Python и делает его более удобным, модульным и компонуемым, чем TensorFlow.
Что можно делать с помощью Keras?
1. Определить процентную точность;
2. Функция вычисления потерь;
3. Создать пользовательские функциональные слои;
4. Встроенные функции обработки данных и изображений;
5. Функции с повторяющимися блоками кода: глубиной 20, 50, 100 слоев.
9. Statsmodels
Когда я сначала изучил R, проведение статистических тестов и исследование статистических данных казались мне самым простым в R и я избегал Python для статистического анализа до тех пор, пока я не изучил Statsmodels в Python.
Когда использовать? Statsmodels — это универсальный пакет Python, который обеспечивает простые вычисления для описательной статистики и оценки и формирования статистических моделей.
Что можно делать с помощью Statsmodels?
1. Линейная регрессия;
3. Метод наименьшего квадрата (OLS);
4. Анализ выживания;
5. Обобщенные линейные модели и байесовская модель;
6. Однофакторный и двухфакторный анализ, проверка гипотез (в основном, что может сделать R!).
10. Plotly
Plotly — это типичная графическая библиотека для Python. Пользователи могут импортировать, копировать, вставлять или передавать данные, которые должны быть проанализированы и визуализированы. Plotly предлагает изолированную версию Python (где вы можете запустить Python, ограниченный в своих возможностях). Теперь осталось понять, что значит ограниченная версия, но я точно знаю, что Plotly облегчает задачу!
Когда использовать? Вы можете использовать Plotly, если хотите создавать и отображать фигуры, обновлять фигуры, наводить курсор на текст для получения подробной информации. Plotly также имеет дополнительную функцию отправки данных на облачные серверы. Это интересно!
Что можно делать с помощью Plotly?
Библиотека графиков Plotly имеет широкий спектр графиков, которые вы можете построить:
1. Основные диаграммы: линейные, круговые, точечные, пузырьковые, Ганта, санбёрст, древовидные, санкей, графики с областями;
2. Статистические стили и стили Seaborn: ошибки, гистограммы, диаграммы Facet и Trellis, деревообразные графики, графики-скрипки, линии тренда;
3. Научные карты: контур, троичный сюжет, логарифмический график, поля векторов, ковровый график (Carpet plot), радарчарт, тепловые карты Роза ветров и Полярный сюжет;
4. Финансовые графики;
8. Взаимодействие Jupyter Widgets.
Plotly это типичная библиотека графиков. Подумайте о визуализации и Plotly сделает это!
Итак, мы изучили путеводитель по топ 10 библиотекам Python для науки о данных, а теперь рассмотрим наши 4 бонусные библиотеки!
1. SpaСy
SpaCy — это библиотека с открытым исходным кодом, используемая для продвинутого NLP для Python и Cython (язык программирования Python, обеспечивающий ощущение и производительность в стиле C с кодом Python, а также синтаксис на основе C).
2. Bokeh
Bokeh — это библиотека Python, которую я бы назвал интерактивной визуализацией данных. С такими инструментами, как Tableau, QlikView или PowerBI, зачем нам Bokeh? Во-первых, Bokeh позволяет очень быстро строить сложные статистические графики с помощью простых команд. Он поддерживает вывод HTML, блокнота или сервера. Во-вторых, можно интегрировать визуализацию Bokeh в приложения Flask и Django или визуализации, написанные в других библиотеках, таких как matplotlib, seaborn, ggplot.
3. Gensim
Gensim — это то, что, по моему мнению, сильно отличается от того, что мы встречали до этого. Он автоматически извлекает семантические темы из документов без труда и с высокой эффективностью. Алгоритмы Gensim не контролируются, это означает, что никакой человеческий ввод не требуется — просто текстовые документы, и затем выполняется извлечение.
4. NLTK
NLTK (Natural Language Toolkit) в основном работает с человеческим языком, а не с компьютерным, чтобы применять обработку естественного языка (NLP). Он содержит библиотеки обработки текста, с помощью которых вы можете выполнять токенизацию, парсинг, классификацию, выделение, тегирование и семантическое обоснование данных. На основе функционала этой библиотеки может показаться, что она повторяется, но каждая библиотека в Python была написана для повышения некоторой эффективности.
Как строить красивые графики на Python с Seaborn
Визуализация данных — это метод, который позволяет специалистам по анализу данных преобразовывать сырые данные в диаграммы и графики, которые несут ценную информацию. Диаграммы уменьшают сложность данных и делают более понятными для любого пользователя.
Есть множество инструментов для визуализации данных, таких как Tableau, Power BI, ChartBlocks и других, которые являются no-code инструментами. Они очень мощные, и у каждого своя аудитория. Однако для работы с сырыми данными, требующими обработки, а также в качестве песочницы, Python подойдет лучше всего.
Несмотря на то, что этот путь сложнее и требует умения программировать, Python позволит вам провести любые манипуляции, преобразования и визуализировать ваши данные. Он идеально подходит для специалистов по анализу данных.
Python — лучший инструмент для data science и этому много причин, но самая важная — это его экосистема библиотек. Для работы с данными в Python есть много замечательных библиотек, таких как numpy , pandas , matplotlib , tensorflow .
Matplotlib , вероятно, самая известная библиотека для построения графиков, которая доступна в Python и других языках программирования, таких как R. Именно ее уровень кастомизации и удобства в использовании ставит ее на первое место. Однако с некоторыми действиями и кастомизациями во время ее использования бывает справиться нелегко.
Разработчики создали новую библиотеку на основе matplotlib , которая называется seaborn . Seaborn такая же мощная, как и matplotlib , но в то же время предоставляет большую абстракцию для упрощения графиков и привносит некоторые уникальные функции.
В этой статье мы сосредоточимся на том, как работать с seaborn для создания первоклассных графиков. Если хотите, можете создать новый проект и повторить все шаги или просто обратиться к моему руководству по seaborn на GitHub.
Что такое Seaborn?
Seaborn — это библиотека для создания статистических графиков на Python. Она основывается на matplotlib и тесно взаимодействует со структурами данных pandas.
Архитектура Seaborn позволяет вам быстро изучить и понять свои данные. Seaborn захватывает целые фреймы данных или массивы, в которых содержатся все ваши данные, и выполняет все внутренние функции, нужные для семантического маппинга и статистической агрегации для преобразования данных в информативные графики.
Она абстрагирует сложность, позволяя вам проектировать графики в соответствии с вашими нуждами.
Установка Seaborn
Установить seaborn так же просто, как и любую другую библиотеку, для этого вам понадобится ваш любимый менеджер пакетов Python. Во время установки seaborn библиотека установит все зависимости, включая matplotlib , pandas , numpy и scipy .
Давайте уже установим seaborn и, конечно же, также пакет notebook , чтобы получить доступ к песочнице с данными.
pipenv install seaborn notebookПомимо этого, перед началом работы давайте импортируем несколько модулей.
import seaborn as sns import pandas as pd import numpy as np import matplotlibСтроим первые графики
Перед тем, как мы начнем строить графики, нам нужны данные. Прелесть seaborn в том, что он работает непосредственно с объектами dataframe из pandas , что делает ее очень удобной. Более того, библиотека поставляется с некоторыми встроенными наборами данных, которые можно использовать прямо из кода, и не загружать файлы вручную.
Давайте посмотрим, как это работает на наборе данных о рейсах самолетов.
flights_data = sns.load_dataset("flights") flights_data.head()Seaborn для визуализации данных в Python
Seaborn — библиотека для создания статистических графиков на Python. Она построена на основе matplotlib и тесно интегрируется со структурами данных pandas. Seaborn помогает вам изучить и понять данные. Его функции построения графиков работают с датасетами и выполняют все необходимы преобразования для создания информативных графиков.
Синтаксис, ориентированный на набор данных, позволяет сосредоточиться на графиках, а не деталях их построения.
Установка seaborn
Официальные релизы seaborn можно установить из PyPI:
pip install seabornБиблиотека также входит в состав дистрибутива Anaconda:
conda install seaborn Библиотека работает с Python версии 3.6+. Если их еще нет, эти библиотеки будут загружены при установке seaborn: numpy, scipy, pandas, matplotlib.
Как только вы установите Seaborn, можете скачать и построить тестовый график для одного из встроенных датасетов:
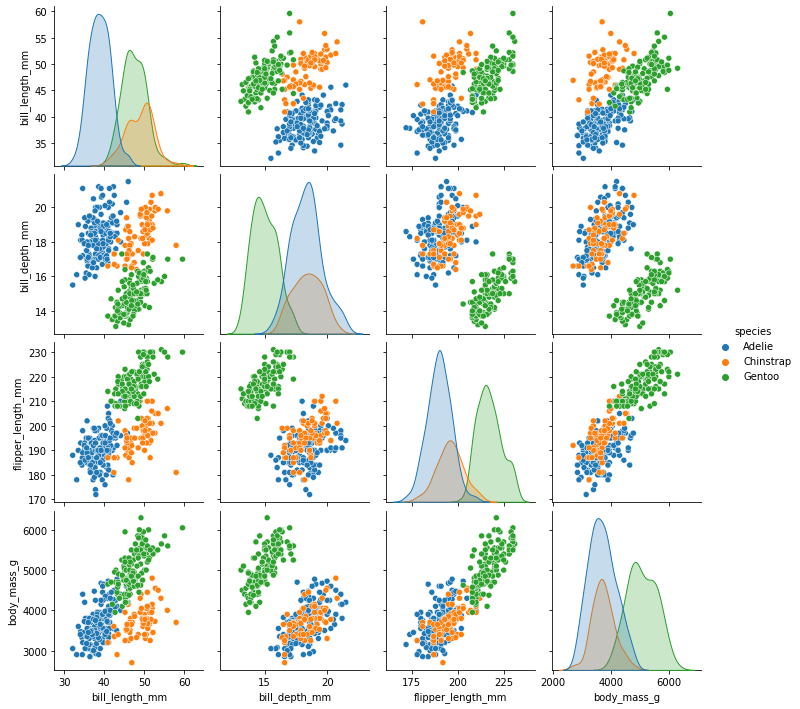
import seaborn as sns df = sns.load_dataset("penguins") sns.pairplot(df, hue="species")Выполнив этот код в Jupyter Notebook, увидите такой график.
Если вы не работаете с Jupyter, может потребоваться явный вызов matplotlib.pyplot.show() :
import matplotlib.pyplot as plt plt.show()Давайте более детально рассмотрим построение популярных типов графиков.
Весь дальнейший код будет выполняться в Jupyter Notebook
Построение Bar Plot в Seaborn
Гистограммы отображают числовые величины на одной оси и переменные категории на другой. Они позволяют вам увидеть, значения параметров для каждой категории.
Гистограммы можно использовать для визуализации временных рядов, а также только категориальных данных.
Построение гистограммы
Чтобы нарисовать гистограмму в Seaborn нужно вызвать функцию barplot() , и передать ей категориальные и числовые переменные, которые нужно визуализировать, как это сделано в примере:
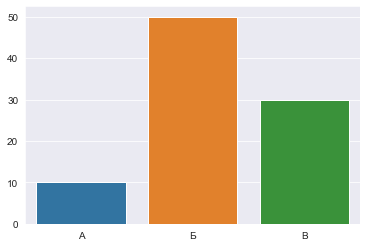
import matplotlib.pyplot as plt import seaborn as sns x = ['А', 'Б', 'В'] y = [10, 50, 30] sns.barplot(x=x, y=y);В данном случае, у нас есть несколько категориальных переменных в списке — А, Б и В. А также непрерывные переменные (числа) в другом списке — 10, 50 и 30. Зависимость между этими двумя элементами визуализируется на гистограмме, для чего эти два списка передаются в функцию sns.barplot() .
В результате получается четкая и простая гистограмма:
Чаще всего вы будете работать с датасетами, которые содержат гораздо больше данных, чем тот что приведен в примере. Иногда к этим наборам данным требуется сортировка, или подсчитать, сколько раз повторяются то или другое значение.
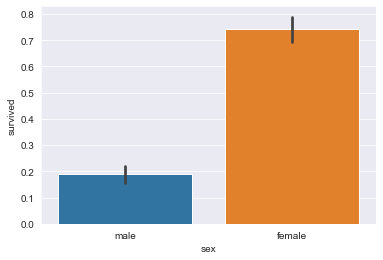
Когда вы работаете с данными можете столкнуться с ошибками и пропусками, которые в них имеются. К счастью, Seaborn защищает нас и автоматически применяет фильтр, который основан на вычислении среднего значения предоставленных данных.
Давайте импортируем классический датасет Titanic и визуализируем Bar Plot с этими данными:
# Импорт данных titanic_dataset = sns.load_dataset("titanic") # Постройка графика sns.barplot(x="sex", y="survived", data=titanic_dataset);В данном случае мы назначили осям Х и Y колонки "sex" и "survived" , вместо жестко заданных.
Если мы выведем первые строки датасета ( titanic_dataset.head() ), увидим такую таблицу:
survived pclass sex age sibsp parch fare . 0 0 3 male 22.0 1 0 7.2500 . 1 1 1 female 38.0 1 0 71.2833 . 2 1 3 female 26.0 0 0 7.9250 . 3 1 1 female 35.0 1 0 53.1000 . 4 0 3 male 35.0 0 0 8.0500 .Убедитесь, что имена колонок совпадают с теми, которые вы назначили переменным x и y .
Наконец, мы используем эти данные и передаем их в качестве аргумента функции, с которой работаем. И получаем такой результат:
Построение горизонтальной гистограммы
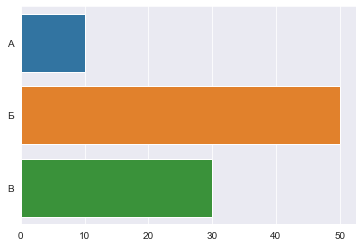
Чтобы нарисовать горизонтальную, а не вертикальную гистограмму нужно просто поменять местами переменные передаваемые в x и y .
В этом случае категориальная переменная будет отображаться по оси Y, что приведет к постройке горизонтального графика:
x = ['А', 'Б', 'В'] y = [10, 50, 30] sns.barplot(x=y, y=x);График будет выглядеть так:
Как изменить цвет в barplot()
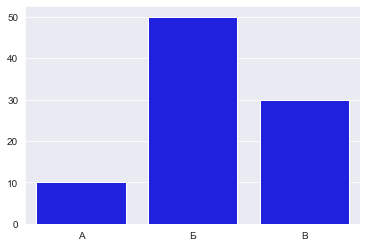
Изменить цвет столбцов довольно просто. Для этого нужно задать параметр color функции barplot и тогда цвет всех столбцов изменится на заданный.
Изменим на голубой:
x = ['А', 'Б', 'В'] y = [10, 50, 30] sns.barplot(x=x, y=y, color='blue');Тогда график будет выглядеть так:
Или, что еще лучше, установить аргумент pallete , который может принимать большое количество цветов. Довольно распространенное значение этого параметра hls :
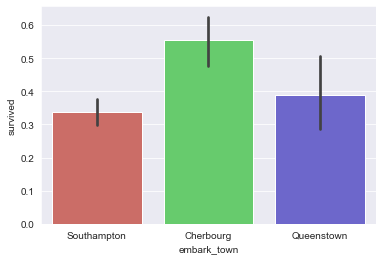
sns.barplot( x="embark_town", y="survived", palette='hls', data=titanic_dataset );Что приведет к такому результату:
Группировка Bar Plot в Seaborn
Часто требуется сгруппировать столбцы на графиках по одному признаку. Допустим, вы хотите сравнить некоторые общие данные, выживаемость пассажиров, и сгруппировать их по заданным критериям.
Нам может потребоваться визуализировать количество выживших пассажиров, в зависимости от класса (первый, второй и третий), но также учесть, города из которого они прибыли.
Всю эту информацию можно легко отобразить на гистограмме.
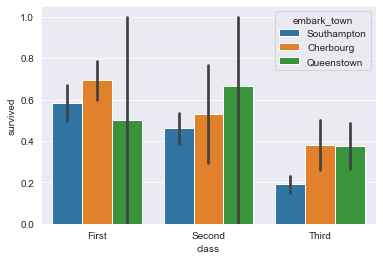
Чтобы сгруппировать столбцы вместе, мы используем аргумент hue . Этот аргумент группирует соответствующие данные и сообщает библиотеке Seaborn, как раскрашивать столбцы.
Давайте посмотрим на только что обсужденный пример:
sns.barplot(x="class", y="survived", hue="embark_town", data=titanic_dataset);Получим такой график:
Настройка порядка отображения групп столбцов на гистограмме
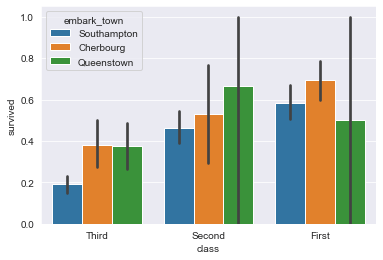
Вы можете изменить порядок следования столбцов по умолчанию. Это делается с помощью аргумента order , который принимает список значений и порядок их размещения.
Например, до сих пор он упорядочивал классы с первого по третий. Что, если мы захотим сделать наоборот?
sns.barplot( x="class", y="survived", hue="embark_town", order=["Third", "Second", "First"], data=titanic_dataset );Получится такой график:
Изменяем доверительный интервал в barplot()
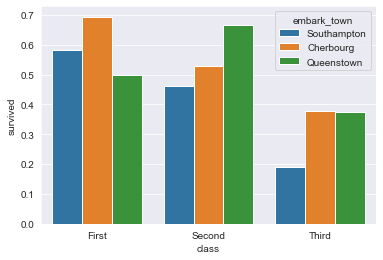
Вы также можете поэкспериментировать с доверительным интервалом, задав аргумент ci .
Например, вы можете отключить его, установив для него значение None , или использовать стандартное отклонение вместо среднего, установив sd , или даже установить верхний предел на шкале ошибок, установив capsize .
Давайте немного поэкспериментируем с атрибутом доверительного интервала:
sns.barplot( x="class", y="survived", hue="embark_town", ci=None, data=titanic_dataset );Получим такой результат:
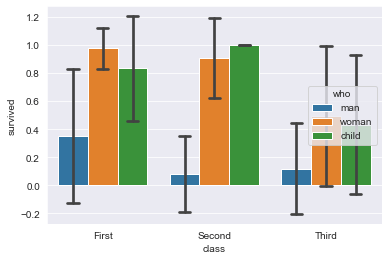
Или мы можем использовать стандартное отклонение:
sns.barplot( x="class", y="survived", hue="who", ci="sd", capsize=0.1, data=titanic_dataset );
Мы рассмотрели несколько способов построения гистограммы в Seaborn на примерах. Теперь перейдем к тепловым картам.
Построение Heatmap в Seaborn
Давайте посмотрим, как мы можем работать с библиотекой Seaborn на Python, чтобы создать базовую тепловую карту корреляции.
Для наших целей мы будем использовать набор данных о жилье Ames, доступный на Kaggle.com. Он содержит более 30 показателей, которые потенциально могут повлиять на стоимость недвижимости.Поскольку Seaborn была написана на основе библиотеки визуализации данных Matplotlib, их довольно просто использовать вместе. Поэтому помимо стандартных модулей мы также собираемся импортировать Matplotlib.pyplot.
import pandas as pd import numpy as np import seaborn as sns import matplotlib.pyplot as pltСледующий код создает матрицу корреляции между всеми исследуемыми показателями и нашей переменной y (стоимость недвижимости).
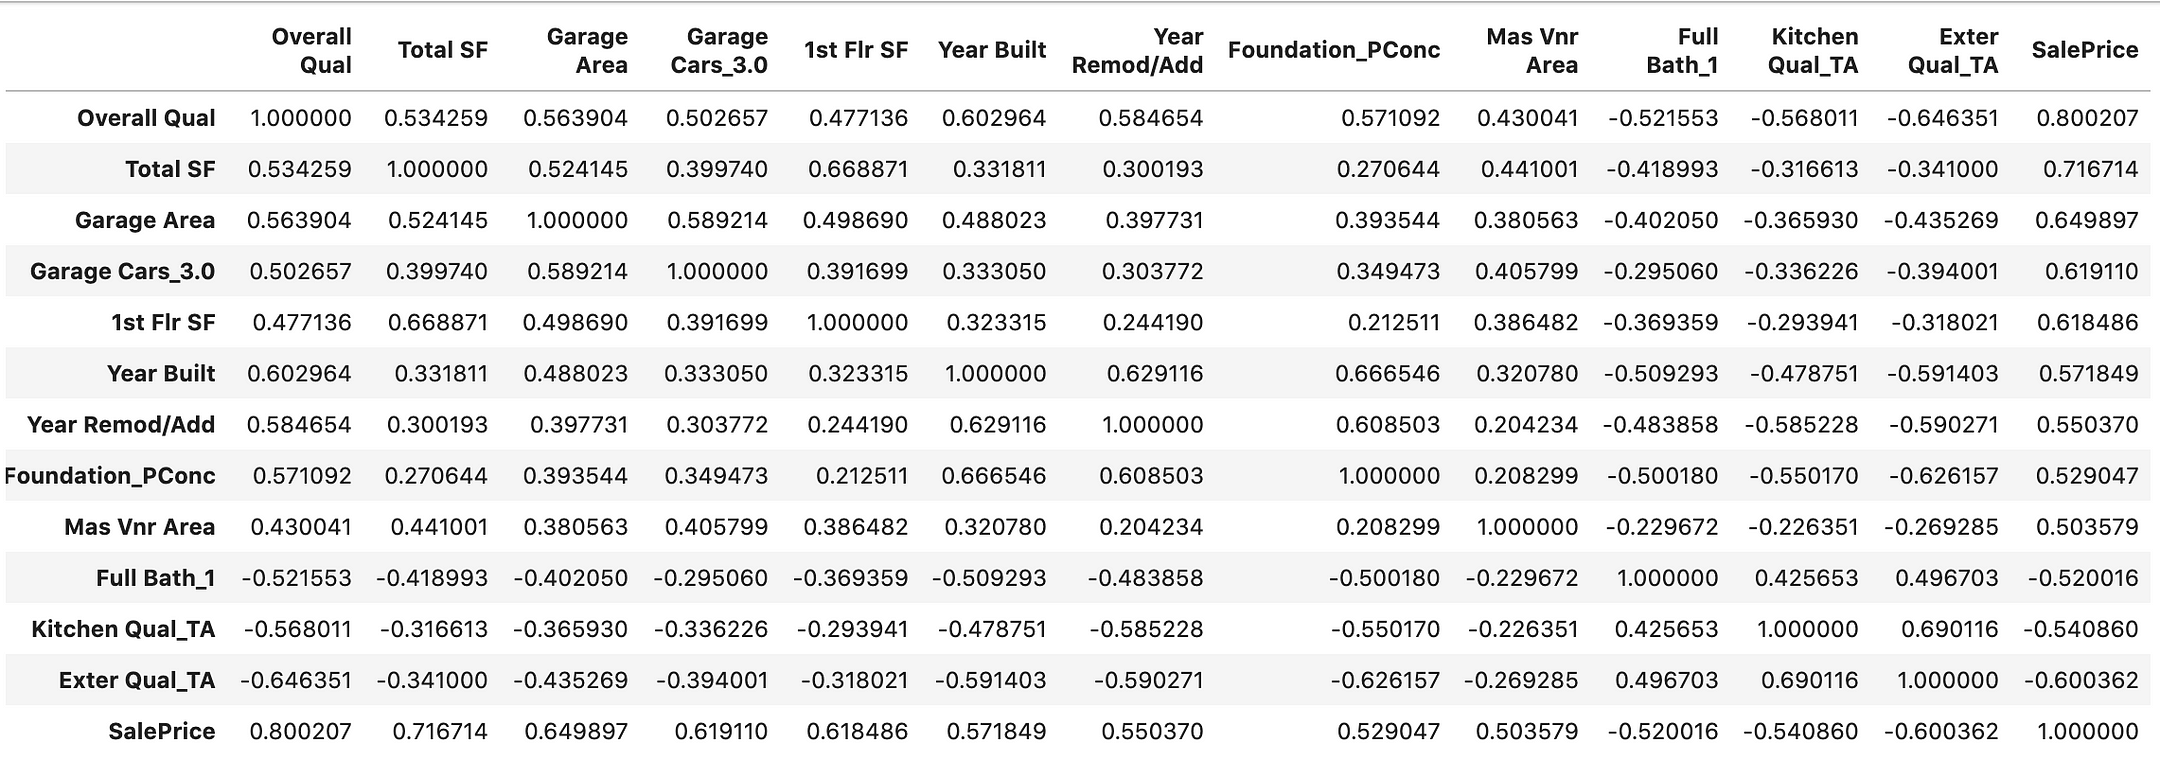
dataframe.corr()
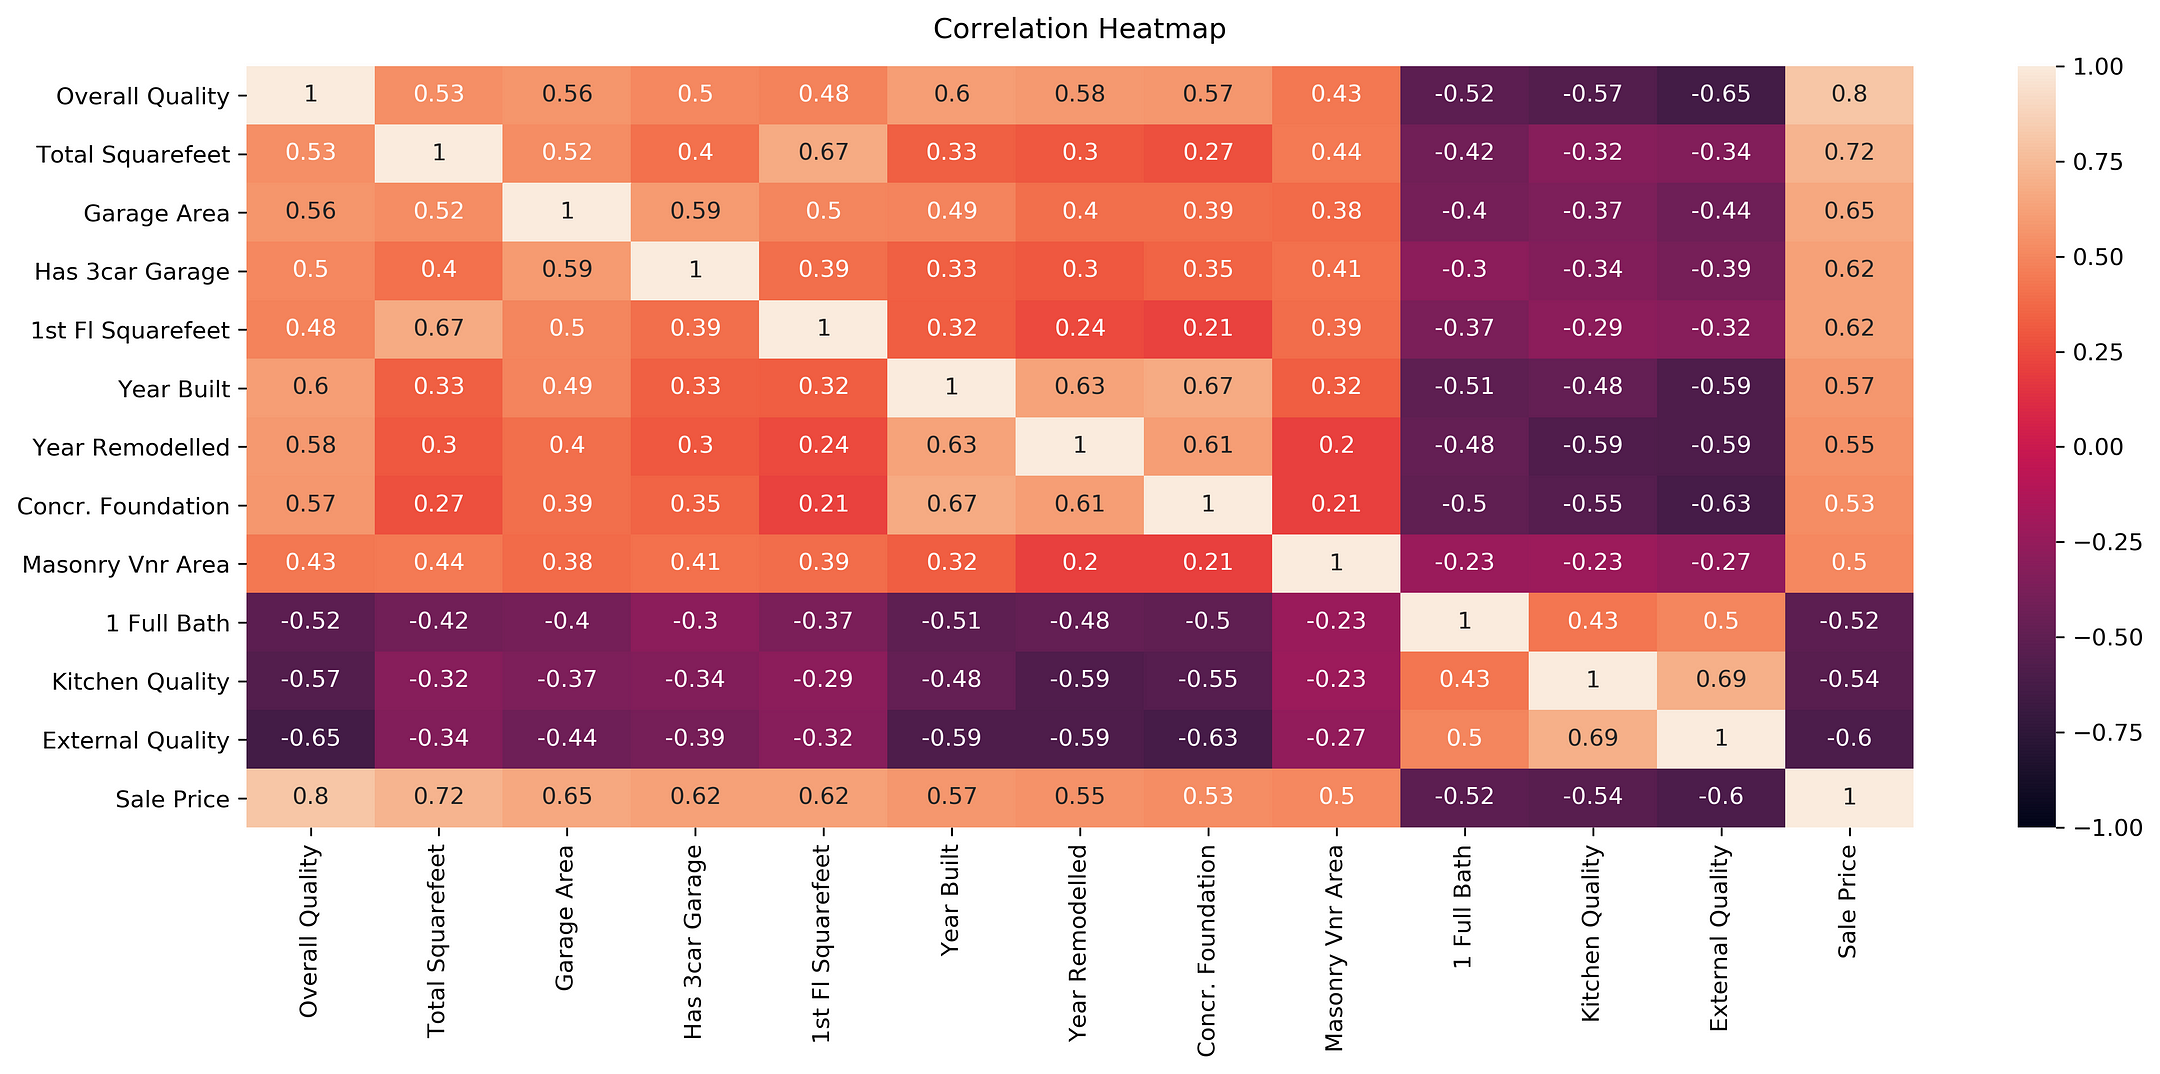
Корреляционная матрица всего с 13 переменными. Нельзя сказать, что она совсем не читабельна. Однако почему бы не облегчить себе жизнь визуализацией?
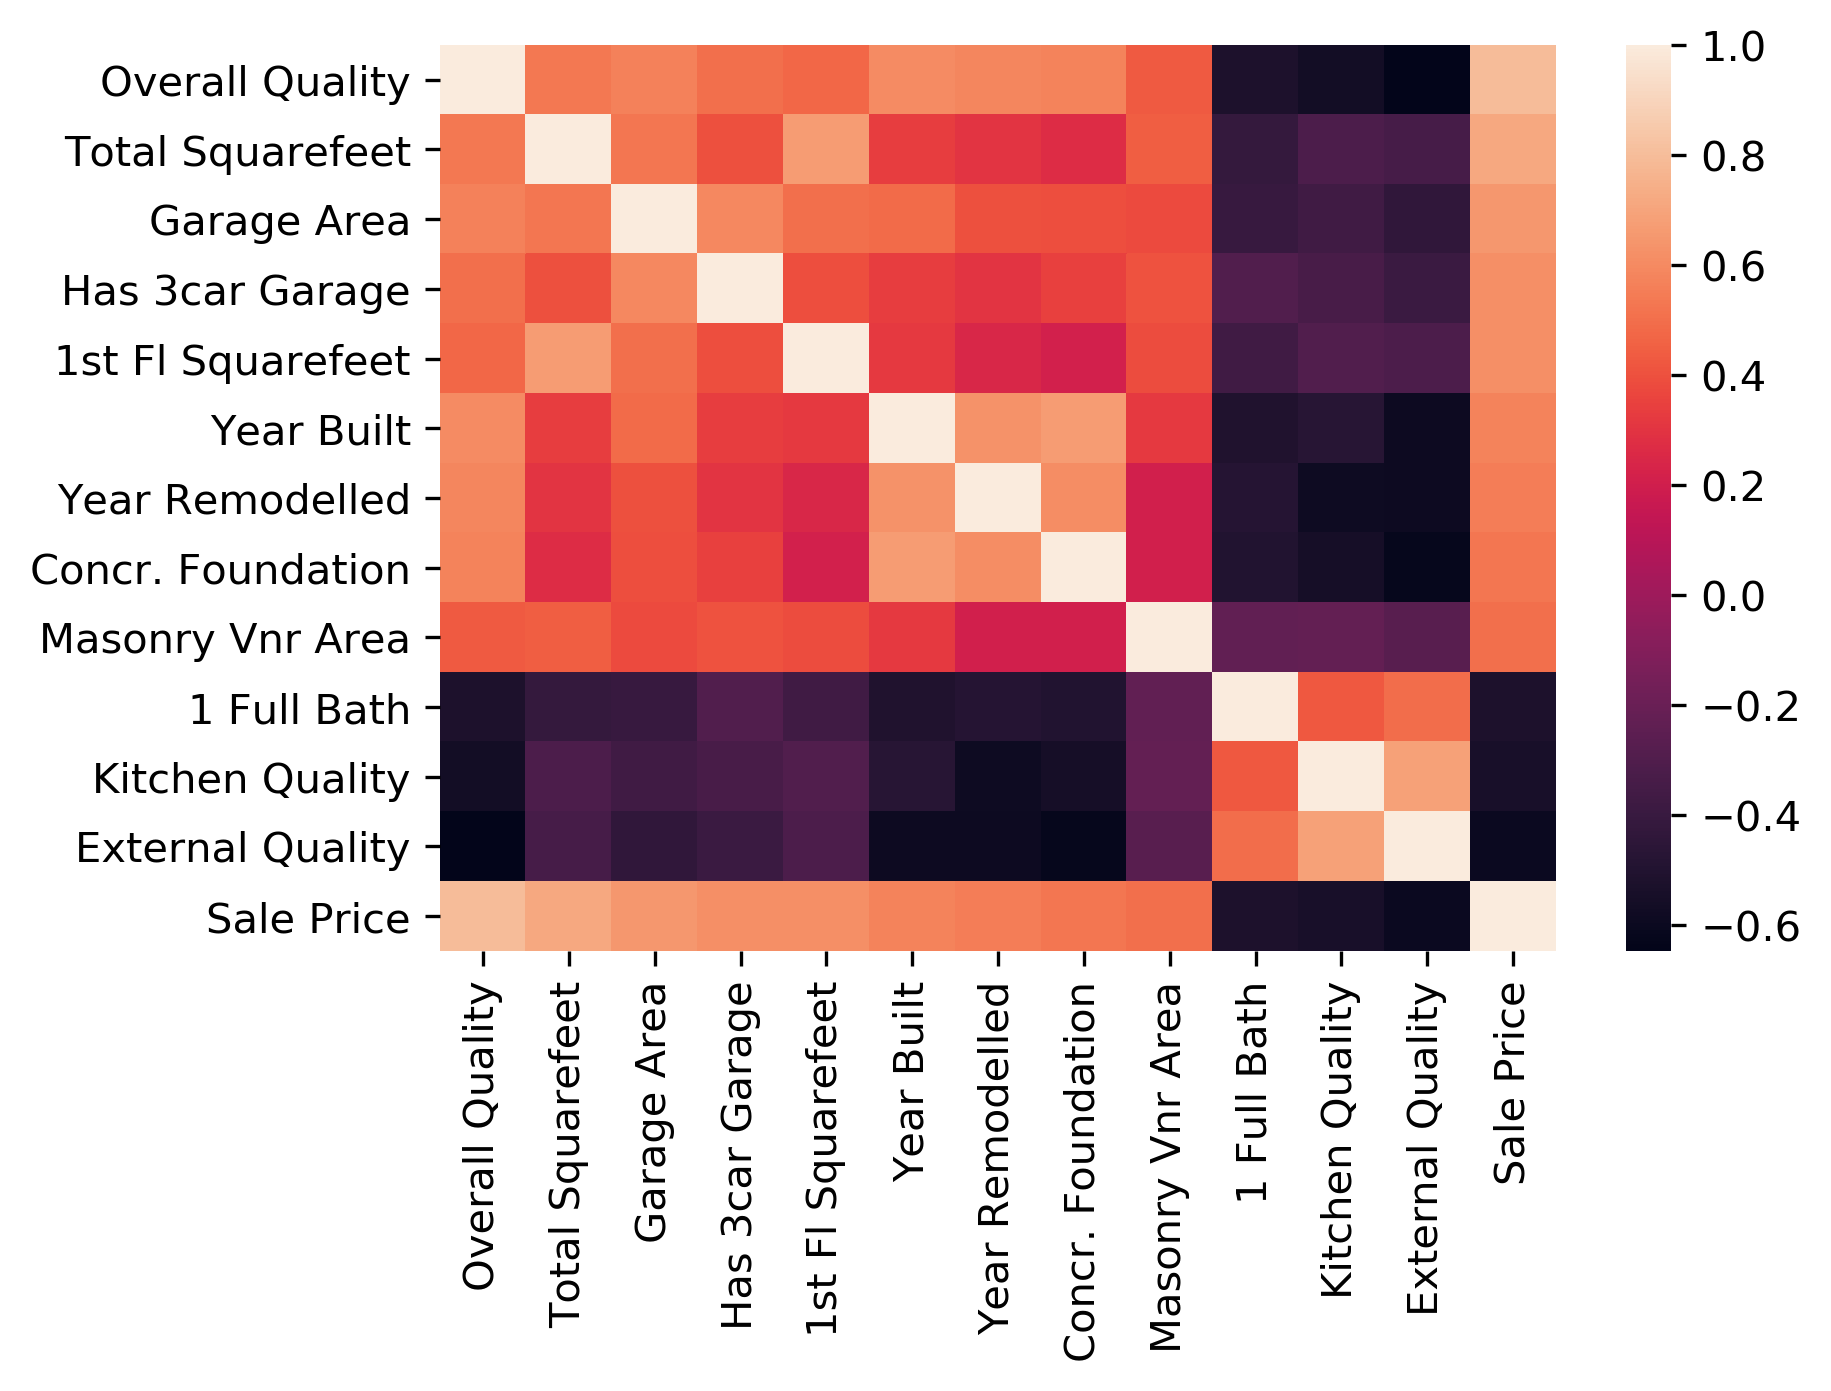
Простая тепловая карта в Seaborn
sns.heatmap(dataframe.corr());
Seaborn прост в использовании, но в нем довольно сложно ориентироваться. Библиотека поставляется с множеством встроенных функций и обширной документацией. Может быть трудно понять, какие именно аргументы использовать, если вам не нужны все возможные навороты.
Давайте сделаем базовую тепловую карту более полезной с минимальными усилиями.
Взгляните на список аргументов heatmap :
seaborn.heatmap(data, *, vmin=None, vmax=None, cmap=None, center=None, robust=False, annot=None, fmt='.2g', annot_kws=None, linewidths=0, linecolor='white', cbar=True, cbar_kws=None, cbar_ax=None, square=False, xticklabels='auto', yticklabels='auto', mask=None, ax=None, **kwargs)
- vmin , vmax — устанавливают диапазон значений, которые служат основой для цветовой карты (colormap).
- cmap — определяет конкретную colormap, которую мы хотим использовать (ознакомьтесь с полным диапазоном цветовых палитр здесь).
- center — принимает вещественное число для центрирования цветовой карты; если cmap не указан, используется colormap по умолчанию; если установлено значение True — все цвета заменяются на синий.
- annot — при значении True числовые значения корреляции отображаются внутри ячеек.
- cbar — если установлено значение False , цветовая шкала (служит легендой) исчезает.
# Увеличьте размер heatmap plt.figure(figsize=(16, 6)) # Сохраните объект тепловой карты в переменной, чтобы легко получить к нему доступ, # когда вы захотите включить дополнительные функции (например, отображение заголовка). # Задайте диапазон значений для отображения на цветовой карте от -1 до 1 и установите для аннотации (annot) значение True, # чтобы отобразить числовые значения корреляции на тепловой карте. heatmap = sns.heatmap(dataframe.corr(), vmin=-1, vmax=1, annot=True) # Дайте тепловой карте название. Параметр pad (padding) определяет расстояние заголовка от верхней части тепловой карты. heatmap.set_title('Correlation Heatmap', fontdict=, pad=12);
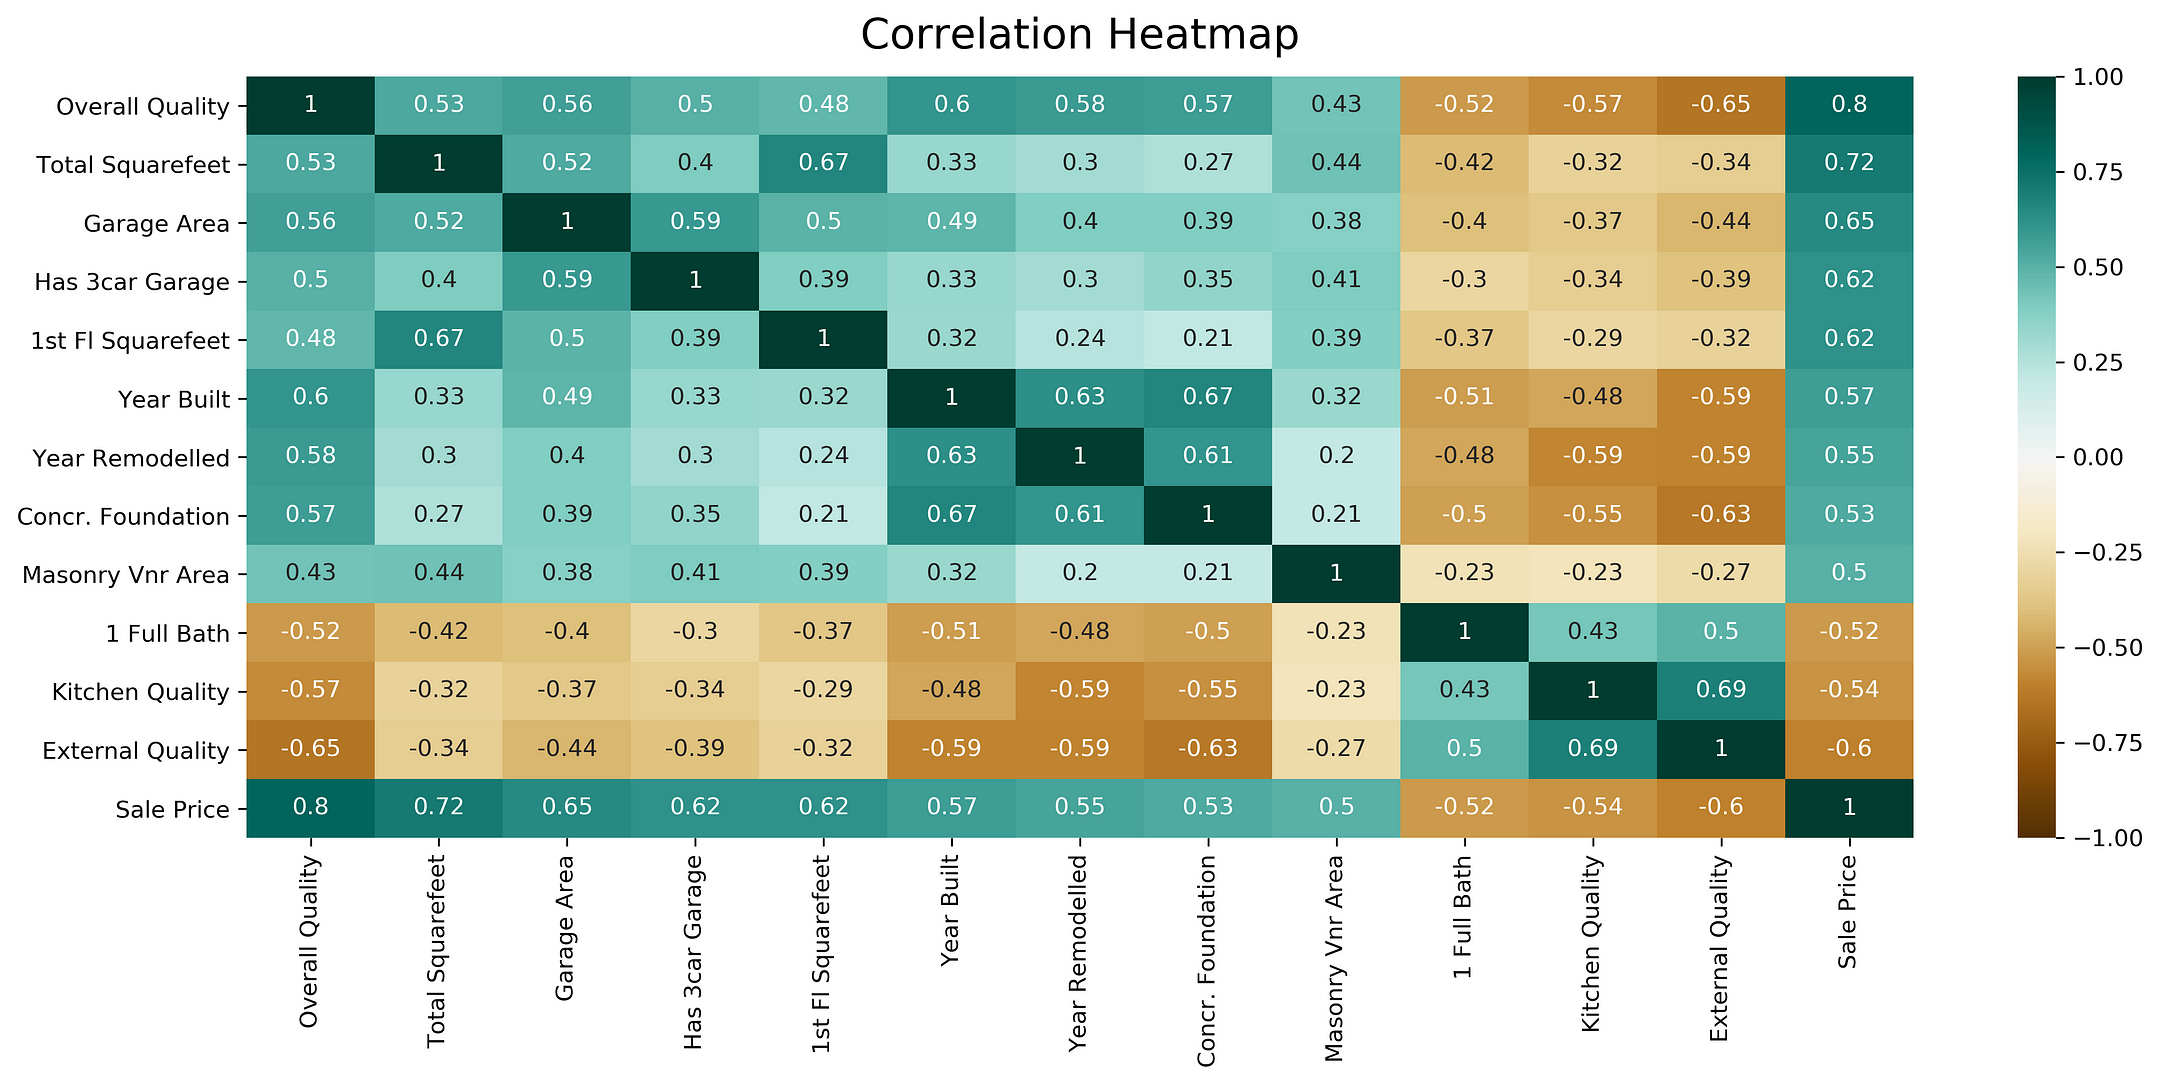
Для работы с heatmap лучше всего подходит расходящаяся цветовая палитра. Она имеет два очень разных темных (насыщенных) цвета на соответствующих концах диапазона интерполированных значений с бледной, почти бесцветной средней точкой. Проиллюстрируем это утверждение и разберемся с еще одной небольшой деталью: как сохранить созданную тепловую карту в файл png со всеми необходимыми x и y метками ( xticklabels и yticklabels ).
plt.figure(figsize=(16, 6)) heatmap = sns.heatmap(dataframe.corr(), vmin=-1, vmax=1, annot=True, cmap='BrBG') heatmap.set_title('Correlation Heatmap', fontdict=, pad=12); # Сохраните карту как png файл # Параметр dpi устанавливает разрешение сохраняемого изображения в точках на дюйм # bbox_inches, когда установлен в значение 'tight', не позволяет обрезать лейблы plt.savefig('heatmap.png', dpi=300, bbox_inches='tight')
Треугольная тепловая карта корреляции
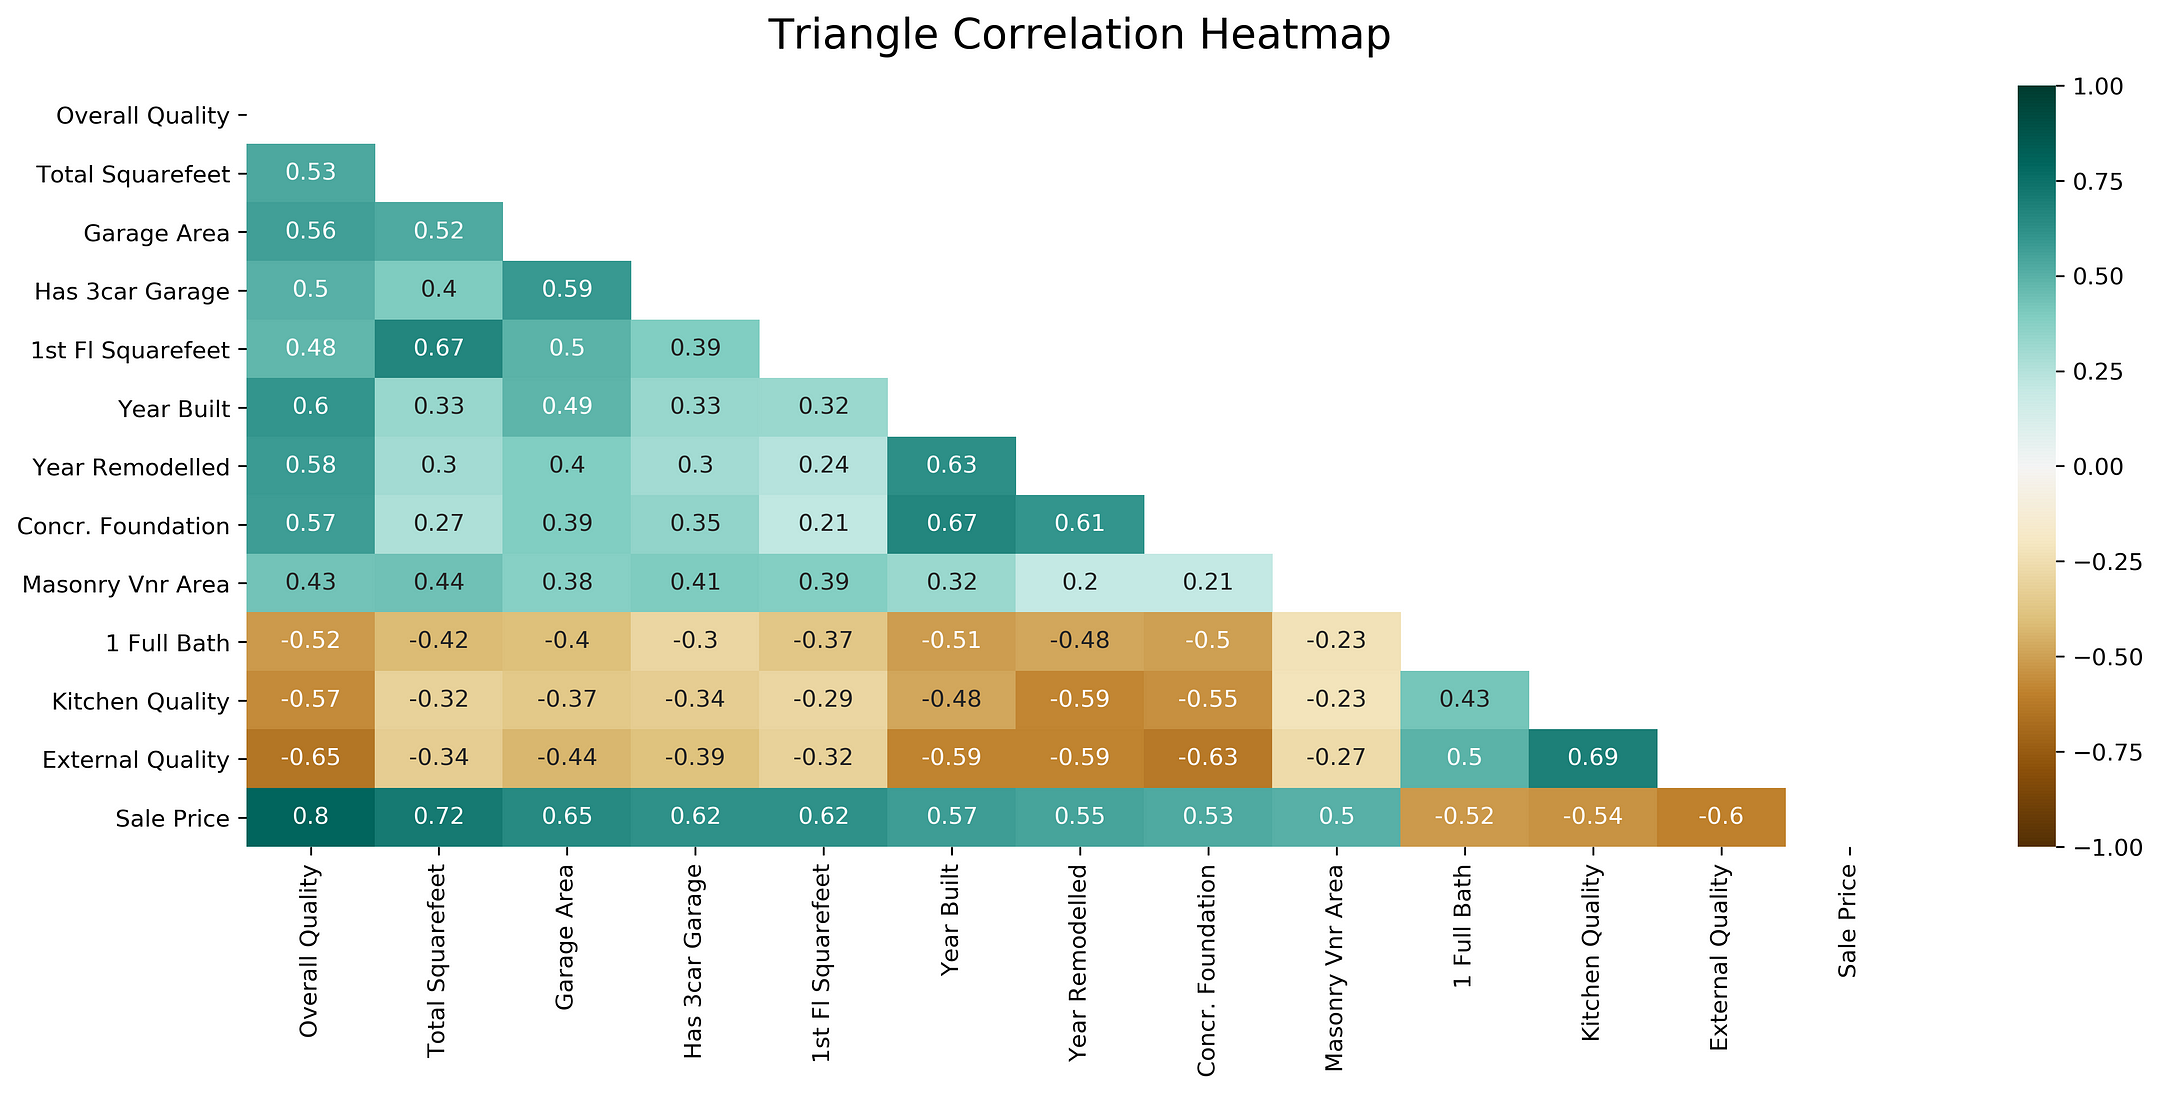
Взгляните на любую из приведенных выше тепловых карт. Если вы отбросите одну из ее половин по диагонали, обозначенной единицами, вы не потеряете никакой информации. Итак, давайте сократим тепловую карту, оставив только нижний треугольник.
Аргумент mask (маска) heatmap пригодится, чтобы скрыть часть тепловой карты. Маска — принимает в качестве аргумента массив логических значений или структуру табличных данных ( dataframe ). Если она предоставлена, ячейки тепловой карты, для которых значения маски является True , не отображаются.
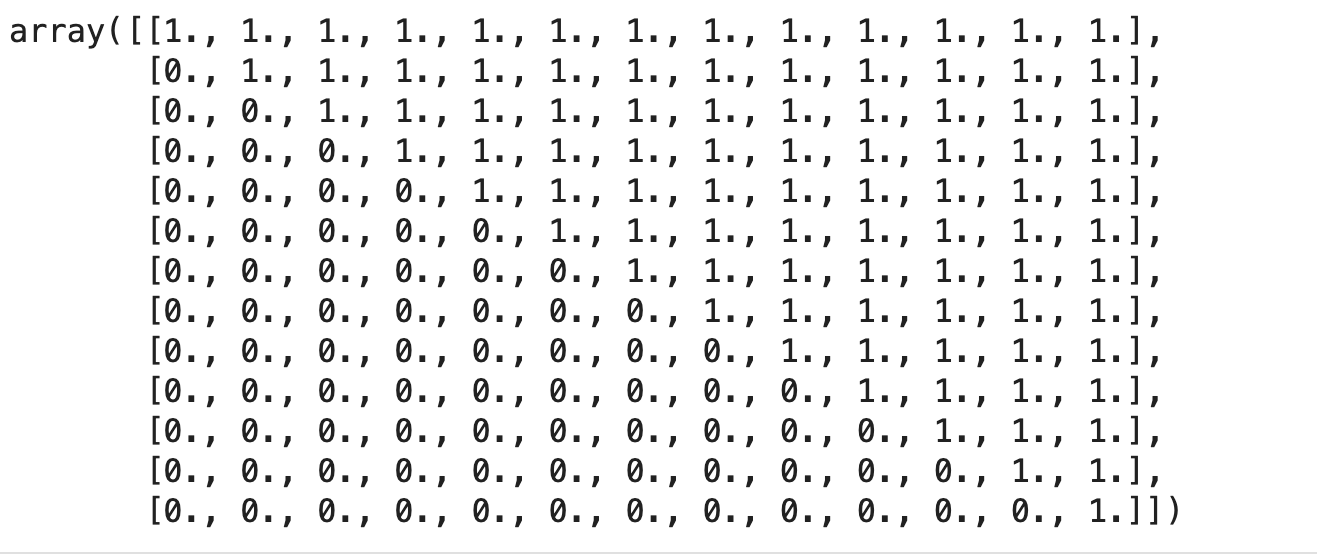
Давайте воспользуемся функцией np.triu() библиотеки numpy, чтобы изолировать верхний треугольник матрицы, превращая все значения в нижнем треугольнике в 0. np.tril() будет делать то же самое, только для нижнего треугольника. В свою очередь функция np.ones_like() изменит все изолированные значения на 1.
np.triu(np.ones_like(dataframe.corr()))
plt.figure(figsize=(16, 6)) # Определите маску, чтобы установить значения в верхнем треугольнике на True mask = np.triu(np.ones_like(dataframe.corr(), dtype=np.bool)) heatmap = sns.heatmap(dataframe.corr(), mask=mask, vmin=-1, vmax=1, annot=True, cmap='BrBG') heatmap.set_title('Triangle Correlation Heatmap', fontdict=, pad=16);
Корреляция независимых переменных с зависимой
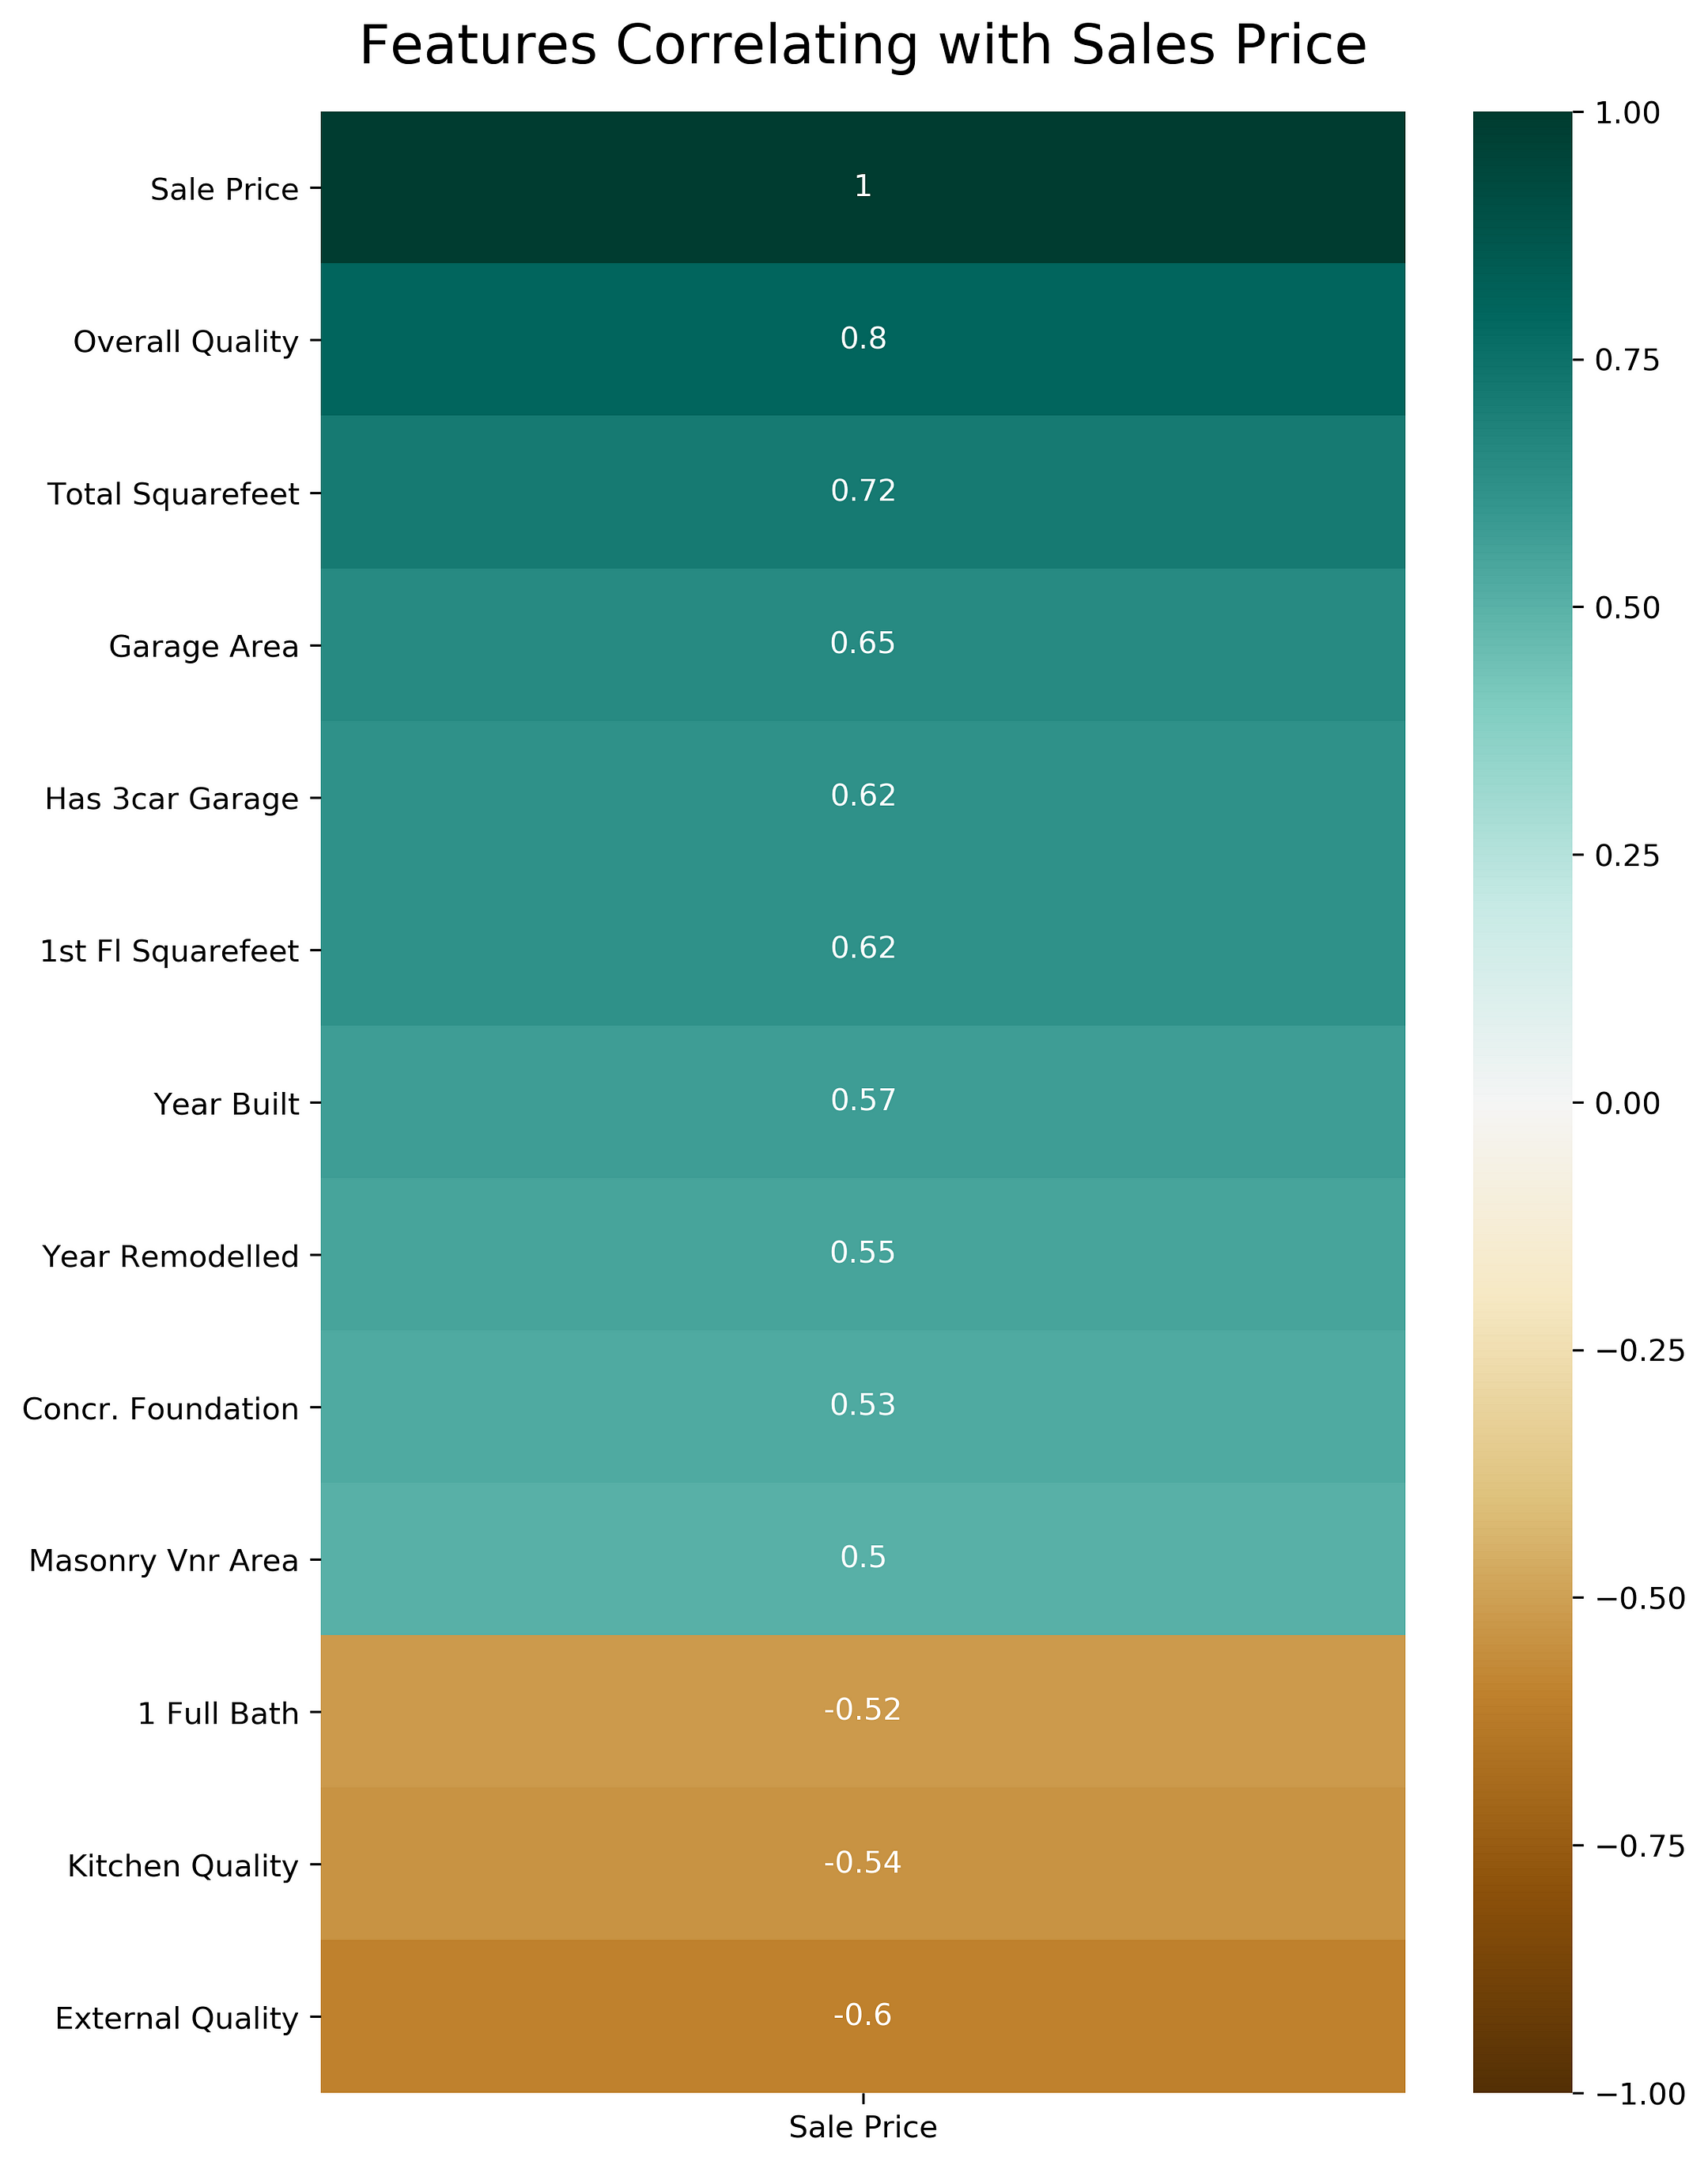
Довольно часто мы хотим создать цветную карту, которая показывает выраженность связи между каждой независимой переменной, включенной в нашу модель, и зависимой переменной.
Следующий код возвращает корреляцию каждого параметра с «ценой продажи», единственной зависимой переменной в порядке убывания.
dataframe.corr()[['Sale Price']].sort_values(by='Sale Price', ascending=False)Давайте используем полученный список в качестве данных для отображения на тепловой карте.
plt.figure(figsize=(8, 12)) heatmap = sns.heatmap(dataframe.corr()[['Sale Price']].sort_values(by='Sale Price', ascending=False), vmin=-1, vmax=1, annot=True, cmap='BrBG') heatmap.set_title('Features Correlating with Sales Price', fontdict=, pad=16);
Эти примеры демонстрируют основную функциональность heatmap в Seaborn. Теперь перейдем к точечным диаграммам.
Построение Scatter Plot в Seaborn
Давайте рассмотрим процесс создания точечной диаграммы в Seaborn. Построим простые и трехмерные диаграммы рассеивания, а также групповые графики на базе FacetGrid.
Импорт данных
Мы будем использовать набор данных, основанный на мировом счастье. Сравнение его индекса с другими показателям отразит факторы, влияющие на уровень счастья в мире.
Построение точечной диаграммы
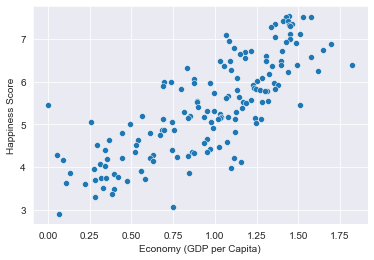
На графике отразим соотношение индекса счастья к экономике страны (ВВП на душу населения):
dataframe = pd.read_csv('2016.csv') sns.scatterplot(data=dataframe, x="Economy (GDP per Capita)", y="Happiness Score");При помощи Seaborn очень легко составлять простые графики наподобие диаграмм рассеивания. Нам не обязательно использовать объект Figure и экземпляры Axes или что-нибудь настраивать. Здесь мы передали dataframe в качестве аргумента с данными, а признаки с информацией, которую нужно визуализировать, в x и y .
Оси диаграммы по умолчанию подписываются именами столбцов, которые соответствуют заголовкам из загружаемого файла. Ниже мы рассмотрим, как это изменить.
После выполнения кода мы получим следующее:
Результат показал прямую зависимость между ВВП на душу населения и предполагаемого уровня счастья жителей конкретной страны или региона.
Построение группы графиков scatterplot при помощи FacetGrid
Если требуется сравнить много переменных друг с другом, например, среднюю продолжительность жизни наряду с оценкой счастья и уровнем экономики, нет необходимости строить 3D-график.
Несмотря на существование двумерных диаграмм, позволяющих визуализировать соотношение между множествами переменных, не все из них просты в применении.
При помощи объекта FacetGrid , библиотека Seaborn позволяет обрабатывать данные и строить на их основе групповые взаимосвязанные графики.
Взглянем на следующий пример:
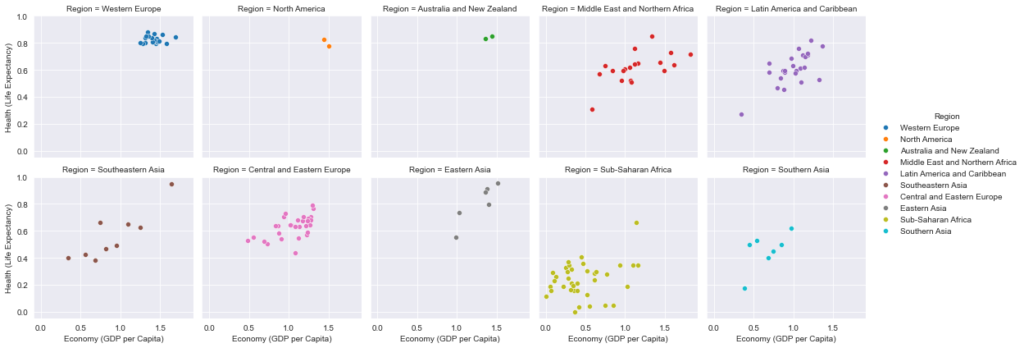
grid = sns.FacetGrid(dataframe, col="Region", hue="Region", col_wrap=5) grid.map(sns.scatterplot, "Economy (GDP per Capita)", "Health (Life Expectancy)") grid.add_legend();
В этом примере мы создали экземпляр объекта FacetGrid с параметром dataframe в качестве данных. При передаче значения "Region" аргументу col библиотека сгруппирует датасет по регионам и построит диаграмму рассеивания для каждого из них.
Параметр hue задает каждому региону собственный оттенок. Наконец, при помощи аргумента col_wrap ширина области Figure ограничивается до 5-ти диаграмм. По достижении этого предела следующие графики будут построены на новой строке.
Для подготовки сетки перед выводом на экран мы используем метод map() . Тип диаграммы передается в первом аргументе со значением sns.scatterplot , а в качестве осей служат переменные x и y .
В результате будет сформировано 10 графиков по каждому региону с соответствующими им осями. Непосредственно перед печатью мы вызываем метод, добавляющий легенду с обозначением цветовой маркировки.
Построение 3D-диаграммы рассеивания
К сожалению, в Seaborn отсутствует собственный 3D-движок. Являясь лишь дополнением к Matplotlib, он опирается на графические возможности основной библиотеки. Тем не менее, мы все еще можем применить стиль Seaborn к трехмерной диаграмме.
Посмотрим, как она будет выглядеть с выборкой по уровням счастья, экономики и здоровья:
%matplotlib notebook import matplotlib.pyplot as plt import pandas as pd import seaborn as sns from mpl_toolkits.mplot3d import Axes3D df = pd.read_csv('Downloads/2016.csv') fig = plt.figure() ax = fig.add_subplot(111, projection = '3d') x = df['Happiness Score'] y = df['Economy (GDP per Capita)'] z = df['Health (Life Expectancy)'] ax.set_xlabel("Счастье") ax.set_ylabel("Экономика") ax.set_zlabel("Здоровье") ax.scatter(x, y, z) plt.show()В результате выполнения кода появится интерактивная 3D-визуализация, которую можно вращать и масштабировать в трехмерном пространстве:
Настройка Scatter Plot
При помощи Seaborn можно легко настраивать различные элементы создаваемых диаграмм. Например, присутствует возможность изменения цвета и размера каждой точки на графике.
Попробуем задать некоторые параметры и посмотреть, как изменится его внешний вид: