Что такое Python и как его использовать в аналитике данных
Узнайте, что такое Python и как использовать его в аналитике данных благодаря простоте, библиотекам и примерам кода!
Алексей Кодов
Автор статьи
23 июня 2023 в 18:21
Python — это высокоуровневый язык программирования, который широко используется в аналитике данных, науке о данных, машинном обучении и других областях. Он обладает простым синтаксисом, что делает его доступным для новичков, а также богатой библиотекой инструментов для работы с данными.
Преимущества использования Python в аналитике данных
- Простота и читаемость: Python легко читать и понимать, что делает код на Python более удобным для анализа и сопровождения.
- Богатая библиотека: Python имеет огромное количество библиотек и инструментов для работы с данными, таких как NumPy, Pandas, TensorFlow и других.
- Поддержка сообщества: Python имеет большое и активное сообщество разработчиков, которые готовы помочь и поделиться опытом.
- Кросс-платформенность: Python работает на различных платформах и операционных системах, что позволяет использовать его в разных средах.
Некоторые основные библиотеки Python для аналитики данных
- NumPy: Мощная библиотека для работы с массивами, матрицами и математическими операциями.
- Pandas: Библиотека для обработки и анализа данных, позволяющая работать с табличными данными и временными рядами.
- Matplotlib: Инструмент для создания графиков и визуализации данных.
- Scikit-learn: Библиотека для машинного обучения, предоставляющая инструменты для классификации, регрессии, кластеризации и других задач.
Аналитик данных: новая работа через 5 месяцев
Получится, даже если у вас нет опыта в IT
Пример использования Python в аналитике данных
Допустим, у нас есть набор данных о продажах товаров, и мы хотим проанализировать его с помощью Python. Вот пример кода, который загружает данные с помощью Pandas, обрабатывает их и строит график продаж:
import pandas as pd import matplotlib.pyplot as plt # Загрузка данных data = pd.read_csv("sales_data.csv") # Обработка данных data["total_sales"] = data["quantity"] * data["price"] # Визуализация данных plt.plot(data["date"], data["total_sales"]) plt.xlabel("Дата") plt.ylabel("Общие продажи") plt.show()
Этот пример демонстрирует, как можно использовать Python и его библиотеки для анализа и визуализации данных. Однако, это лишь краткий обзор того, что можно сделать с Python в аналитике данных.
Хотите научиться использовать Python и другие инструменты для аналитики данных? Обратите внимание на эту онлайн школу, которая поможет вам стать специалистом в этой области:
Как быстро начать программировать на Python аналитику данных?
От автора Telegram-канала Аналитика и Growth mind-set (делюсь кейсами с работы, бесплатным обучением, задачами с собеседований).
Я уверена, что даже полный новичок в Python сможет сделать простой анализ уже через 2 недели. Анализ данных на Python — это не миллионы строк кода, многие манипуляции с данными — это всего лишь одна или несколько строчек.
Вот некоторые мысли из моего опыта.
1) ИЗУЧИТЕ ОСНОВЫ PYTHON (СИНТАКСИС).
Однако тут может возникнуть проблема — вы неделями и месяцами изучаете синтаксис, но при этом до сих пор не понимаете, как делать анализ данных с помощью Python.
На старте я изучала бесплатный курс Python в 2х частях (Часть 1 и Часть 2 на Stepik. Хороший курс? Да. Но изучать его довольно долго. Заявлено 40 + 64 часа, но выходит гораздо больше. Некоторые задачи можно решать по несколько часов, а задач только в Части 1 более 150). Ну и если уделять даже 2 часа в день 5 дней в неделю, обучение все равно растянется на несколько месяцев, а то и полгода. А за это время вы так и не поймете, как делать анализ данных с помощью Python.
Синтаксис знать важно, но также важно не утонуть в нем. На мой взгляд, начать лучше с более короткого курса и быстрее перейти к изучению библиотек для анализа данных и практике. А к синтаксису вы так или иначе будете возвращаться и углубляться в него по мере практики.
Например, есть 2 коротких бесплатных курса от Kaggle по синтаксису: Введение в программирование с Python и Python. Но можно брать и другие.
2) ИЗУЧИТЕ БИБЛИОТЕКИ ДЛЯ АНАЛИЗА ДАННЫХ.
Именно изучая библиотеки вы и поймете, как делать анализ данных с Python. Библиотеки — это наборы шаблонов кода для каждой конкретной ситуации. Знакомиться с библиотеками лучше всего выполняя реальный проект по анализу данных.
Начните с Pandas — это основная библиотека для работы с данными. С помощью нее можно очищать и подготавливать данные, делать анализ, визуализировать и др.
А если вы уже знаете Excel или SQL, то вам будет еще проще освоить эту библиотеку: Pandas имеет схожие функции и может принимать различные типы данных. На официальном сайте Pandas даже есть туториалы, где функции Pandas приводятся в сравнении с Excel или SQL.
Освоив азы Pandas, вам будет легко понять Numpy, Matplotlib, Seaborn и другие библиотеки для анализа данных.
Например, вот краткий бесплатный курс по визуализации данных в Python от Kaggle (а именно используются библиотеки Seaborn и Matplotlib).
3) НАЧНИТЕ ПРАКТИЧЕСКИЙ ПРОЕКТ ПО АНАЛИЗУ ДАННЫХ С ПЕРВЫХ ДНЕЙ
Обучение на практике — лучший способ научиться программировать. Да, это вызов и выход из зоны комфорта, но так вы научитесь гораздо быстрее. После короткого курса синтаксиса уже можно переходить к реальному проекту, в процессе изучая библиотеки.
Поначалу можете подсмотреть, как выглядят проекты по анализу данных у других (например, на Medium много таких проектов). Также примеры проектов анализа данных с помощью Python и где взять данные писала тут.
Если в процессе сталкиваетесь с ошибками, то в помощь Google и Stackoverflow.
4) ЧТОБЫ ПИСАТЬ КОД, НУЖНО НАСТРОИТЬ СРЕДУ РАЗРАБОТКИ.
Первый раз мне эта задача не показалась легкой, тк возникали ошибки, которые я достаточно долго исправляла.
Поэтому с первых дней можно начать с облачных сред разработки, в которых можно писать код сразу без настройки. Например, Google Collab или Kaggle Notebook. А в последствии установите среду разработки, например PyCharm, VScode или другую.
Подписывайтесь на мой канал Аналитика и Growth mind-set, там публикую больше интересного. Вот некоторые посты:
Экспресс-анализ данных на Python
В рамках расширения своих компетенций периодически провожу анализ данных датасетов. В какой-то момент осознал, что трачу время на столбцы с аналитиками, в которых все в порядке. Данные полные, тип данных единый, интерпретация понятна. Если столбцов несколько десятков, то обзорная проверка атрибутов каждого столбца занимает довольно значительное время.
Посмотрел в сторону библиотеки pandas-profiling.
Мне показалось, что инструмент хорошо подходит для датасета в котором отработаны аномалии, пропуски, выбросы, типы данных. Вызвав df.profile_report() получаешь добротный отчет и остается только рыться во всех вкладках отчета и анализировать интересующие столбцы.
Меня смутил большой объем информации, который выдает profile_report(). Мне не хватило более простой обзорной формы, где легко можно сделать вывод и решить для себя стоит обратить внимание на столбец или нет. Возникла потребность самому настроить выдачу отчета под себя.
Разработчиком я не являюсь, поэтому попытался накидать простой код своими силами, который бы позволил немного ускорить процесс проверки. Возможно он поможет и вам. Был бы признателен, если в комментариях, напишите ваше предложение, что можно улучшить, добавить, скорректировать.
Требования и план разработки
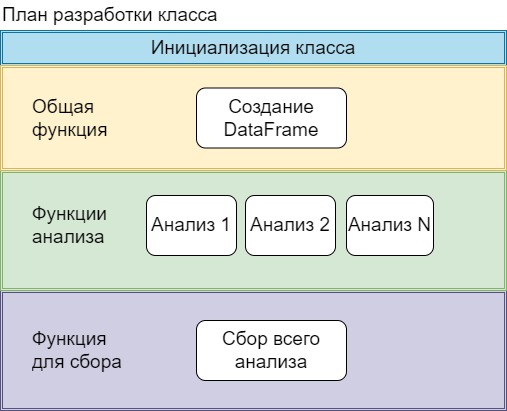
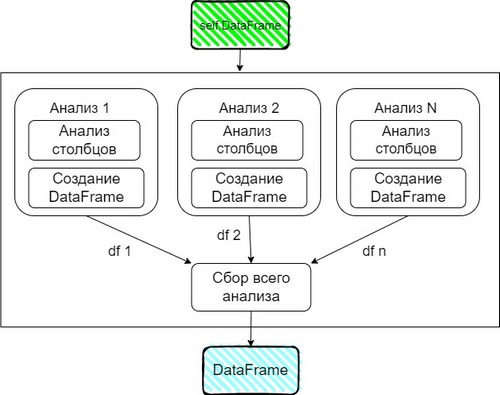
При построении нужно предусмотреть добавление функций для анализа данных, если возникнет потребность расширить пул анализируемых параметров. Возможность вызывать, как отдельную функцию с конкретным анализом, так и все сразу. Функции должны перебирать каждый столбец в DateFrame.
Подумав над решением пришел к выводу, что понадобиться класс, в котором инициализируются переменные, которые будут доступны всем функциям. Графически вижу это так:
Подумал, как выстроить алгоритм для анализа столбцов. На вход функция получает таблицу с данными, анализирует через цикл каждый столбец. По итогу должна родиться строка с результатом. Один столбец = одной строке с результатом.
Функция должна иметь возможность быть вызвана независимо от других, следовательно, чтобы удовлетворить это требование результатом работы (return) должен быть DateFrame
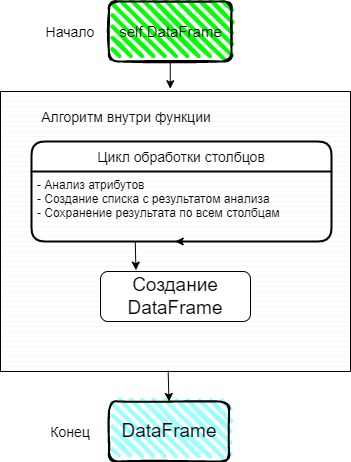
Функция вывода всех результатов анализа, решил построить следующим образом
Разработка
Инициализируем класс
На вход подаем Dataframe
import pandas as pd class DataAnalysisColumns(): def __init__(self, df: pd.DataFrame): self.df = df self.columns = df.columns self.TotalRows = df.shape[0] self.BoxResult = [] self.СolumnsDict =
Делаем доступными для функций:
Список с названием столбцов
Общие количество строк. Понадобиться для части функций.
Пустой список для сохранения результата анализа столбцов.
Словарь с названиями столбцов итогового отчета.
Общая функция
CreateDf принимает список с результатом анализа и создает DataFrame. Очищает список, в котором хранились результаты с целью использования в следующих функциях.
def CreateDf(self,BoxResult:list): OutputDf = pd.DataFrame(data=BoxResult, columns=list(self.СolumnsDict.keys())) self.BoxResult.clear() return OutputDf
Функции анализа
Напишем несколько простых функций с анализом. Проанализируем имена столбцов на предмет наличия пробелов. Ранее при использовании query в pandas пробелы в названиях столбцов попортили нервы.
Второй анализ будет связан с наличием пустых строк в столбце. Выведем абсолютное и относительное число.
Каждая функция завершается созданием отдельного dataframe
def AnalysisOfColumnNames(self): for NameColumn in self.columns: if " " in NameColumn: ListAttributes = ['Сolumn name', NameColumn, NameColumn] self.BoxResult.append(ListAttributes) return self.CreateDf(self.BoxResult) def AnalysisOfNull(self): for NameColumn in self.columns: CountNull = self.df[NameColumn].isnull().sum() if CountNull > 0: ListAttributes = ['Null Count', NameColumn , f' of or ".format(CountNull/self.TotalRows)>'] self.BoxResult.append(ListAttributes) return self.CreateDf(self.BoxResult)
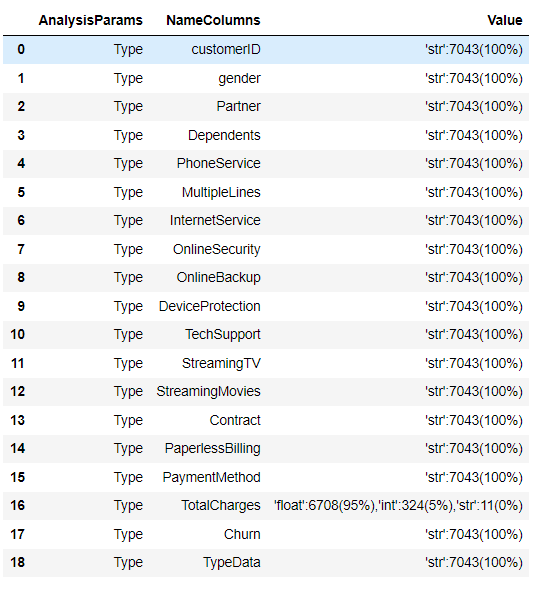
Третья функция немного сложнее. Анализируем состав типа данных внутри столбца. Результаты выводим так же в абсолютных и относительных значениях.
В строках 18-20 пытаюсь выдернуть из , тип данных c кавычки ‘str’. Переменные FirsttNumOfSymbol, LatsNumOfSymbol. Наверное, его можно заменить регулярным выражением. Пытался сделать не получилось. Был бы рад, если в комментариях подскажите это сократит код.
def AnalysisOfType(self): # анализируем каждый столбец for NameColumn in self.columns: TypeColumn = str(self.df[NameColumn].dtype) # для типа 'object' пробегаемся по всему столбцу # формируем сводную по типу данных и считаем кол-ву строк if TypeColumn == 'object': self.df['TypeData'] = self.df[NameColumn].apply(lambda x: str(type(x))) PivotTable = self.df.groupby('TypeData').agg().reset_index() PivotTable.columns = ['TypeData', 'count'] ColumnType = PivotTable['TypeData'] BoxResult = [] # собираем все в один результат(строку) for i in range(len(PivotTable)): FirsttNumOfSymbol = ColumnType[i].find("'") LatsNumOfSymbol = ColumnType[i].rfind("'") + 1 NameTypeRow = ColumnType[i][FirsttNumOfSymbol:LatsNumOfSymbol] Percent = "".format(PivotTable['count'][i]/self.TotalRows) StringForAppend = f":()" BoxResult.append(StringForAppend) ListAttributes = ['Type', NameColumn, ",".join(BoxResult)] self.BoxResult.append(ListAttributes) return self.CreateDf(self.BoxResult)
Функции для анализа выбросов и анализ уникальности я оставлю в коде на GitHub.
Сбор всего анализа
Наши функции выдают отдельные DataFrame, соберем их в отдельный список. При помощи concat объединим в один.
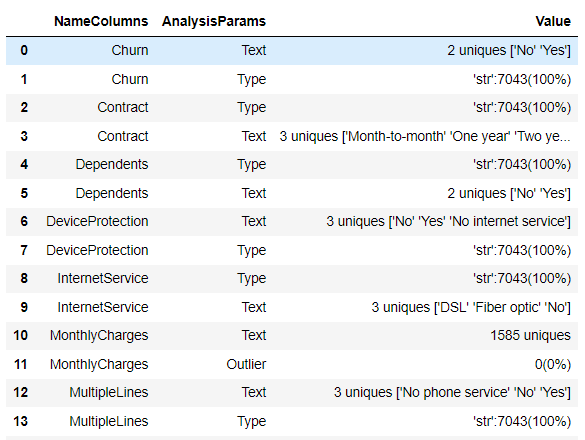
В качестве демонстрации работы с итоговой таблицей, изменил порядок столбцов и добавил сортировку.
def AnalysisOfDf(self): ListOfAnalysis = [self.AnalysisOfColumnNames(), self.AnalysisOfNull(), self.AnalysisOfType(), self.AnalysisOfOutlier(), self.AnalysisOfUniqueText(), ] OutputDf = pd.concat(ListOfAnalysis).reset_index(drop=True) OutputDf = OutputDf[['NameColumns', 'AnalysisParams', 'Value']] return OutputDf.sort_values(by=['NameColumns']).reset_index(drop=True)Результат
Тестируем на реальных данных. Вызовем весь анализ. Размер таблицы (7043, 24)
Посмотрим, как работает отдельно функция по анализу типов данных
Заключение
Данное решение является для меня самым первым этапом анализа. Потенциальные проблемы или их отсутствие видны в таблицы. После этого можно начинать следующие шаги и сфокусироваться на требующих детальной разборки столбцах.
Повторюсь, если у вас есть предложения, что можно улучшить, добавить, скорректировать прошу в комментарии.
Код и данные на GitHub
- python
- визуализация данных
- анализ данных python
- анализ данных
- аналитика
- data analysis
- data science
- data
Анализ данных с использованием Python
Язык программирования Python в последнее время все чаще используется для анализа данных, как в науке, так и коммерческой сфере. Этому способствует простота языка, а также большое разнообразие открытых библиотек.
В этой статье разберем простой пример исследования и классификации данных с использованием некоторых библиотек на Python. Для исследования, нам понадобится выбрать интересующий нас набор данных (DataSet). Разнообразные наборы Dataset’ы можно скачать с сайта. DataSet обычно представляет собой файл с таблицей в формате JSON или CSV. Для демонстрации возможностей исследуем простой набор данных с информацией о наблюдениях НЛО. Наша цель будет не получить исчерпывающие ответы на главный вопрос жизни, вселенной и всего такого, а показать простоту обработки достаточно большого объема данных средствами Python. Собственно, на месте НЛО могла быть любая таблица.
И так, таблица с наблюдениями имеет следующие столбцы:
- datetime — дата появления объекта
- city — город в котором появился объект
- state — штат
- country — страна
- duration (seconds) — время на которое появился объект в секундах
- duration (hours/min) — время на которое появился объект в часах/минутах
- shape — форма объекта
- comments — коментарий
- date posted — дата публикации
- latitude — широта
- longitude — долгота
Для тех, кто хочет пробовать нуля, подготовим рабочее место. У меня на домашнем ПК стоит Ubuntu, поэтому покажу для нее. Для начала нужно установить сам интерпретатор Python3 с библиотеками. В убунту подобном дистрибутиве это будет:
sudo apt-get install python3 sudo apt-get install python3-pip
pip — это система управления пакетами, которая используется для установки и управления программными пакетами, написанными на Python. С её помощью устанавливаем библиотеки, которые будем использовать:
- sklearn — библиотека, алгоритмов машинного обучения, она понадобится нам в дальнейшем для классификации исследуемых данных,
- matplotlib — библиотека для построения графиков,
- pandas — библиотека для обработки и анализа данных. Будем использовать для первичной обработки данных,
- numpy — математическая библиотека с поддержкой многомерных массивов,
- yandex-translate — библиотека для перевода текста, через yandex API (для использования нужно получить API ключ в яндексе),
- pycountry — библиотека, которую будем использовать для преобразования кода страны в полное название страны,
Используя pip пакеты ставятся просто:
pip3 install sklearn pip3 install matplotlib pip3 install pandas pip3 install numpy pip3 install yandex-translate pip3 install pycountry Файл DataSet — scrubbed.csv должен лежать в рабочей директории, где создается файл программы.
Итак приступим. Подключаем модули, которые используются нашей программой. Модуль подключается с помощью инструкции:
import
Если название модуля слишком длинное, и/или не нравится по соображениям удобства или политическим убеждениямм, то с помощью ключевого слова as для него можно создать псевдоним:
import as
Тогда, чтобы обратиться к определенному атрибуту, который определен в модуле
Для подключения определенных атрибутов модуля используется инструкция from. Для удобства, чтобы не писать названия модуля, при обращении к атрибуту, можно подключить нужный атрибут отдельно.
from import
Подключение нужных нам модулей:
import pandas as pd import numpy as np import pycountry import matplotlib.pyplot as plt from matplotlib import cm from mpl_toolkits.mplot3d import Axes3D from yandex_translate import YandexTranslate # Используем класс YandexTranslate из модуля yandex_translate from yandex_translate import YandexTranslateException # Используем класс YandexTranslateException из модуля yandex_translateДля того, что бы улучшить наглядность графиков, напишем вспомогательную функцию для генерации цветовой схемы. На входе функция принимает количество цветов, которое необходимо сгенерировать. Функция возвращает связный список с цветами.
# Размер надписей на графиках PLOT_LABEL_FONT_SIZE = 14 # Генерация цветовой схемы # Возвращает список цветов def getColors(n): COLORS = [] cm = plt.cm.get_cmap('hsv', n) for i in np.arange(n): COLORS.append(cm(i)) return COLORS Для перевода некоторых названий с англиского на русский язык создадим функцию translate. И да, нам понадобится интернет, чтобы воспользоваться API переводчика от Яндекс.
Функция принимает на вход аргументы:
- string — строка, которую нужно перевести,
- translator_obj — объект в котором реализован переводчик, если равен None, то строка не переводится.
и возвращает переведенную на русский язык строку.
def translate(string, translator_obj=None): if translator_class == None: return string t = translator_class.translate(string, 'en-ru') return t['text'][0] Инициализация объекта переводчика должна быть в начале кода.
YANDEX_API_KEY = 'Здесь должен быть определен API ключ . ' try: translate_obj = YandexTranslate(YANDEX_API_KEY) except YandexTranslateException: translate_obj = None YANDEX_API_KEY — это ключ доступа к API Yandex, его следует получить в Яндексе. Если он пустой, то объект translate_obj инициализируется значением None и перевод будет игнорироваться.
Напишем еще одну вспомогательную функцию для сортировки объектов dict.
dict — представляет собой встроенный тип Python, где данные хранятся в виде пары ключ-значения. Функция сортирует словарь по значениям в убывающем порядке и возвращает отсортированные список ключей и соответсвуюущий ему по порядку следования элементов список значений. Эта функция будет полезна при построении гистограмм.
def dict_sort(my_dict): keys = [] values = [] my_dict = sorted(my_dict.items(), key=lambda x:x[1], reverse=True) for k, v in my_dict: keys.append(k) values.append(v) return (keys,values) Мы добрались до непосредственно данных. Для чтения файла с таблицей используем метод read_csv модуля pd. На вход функции подаем имя csv файла, и чтобы подавить предупреждения при чтении файла, задаем параметры escapechar и low_memory.
- escapechar — символы, которые следует игнорировать
- low_memory — настройка обработки файла. Задаем False для считывание файла целиком, а не частями.
df = pd.read_csv('./scrubbed.csv', escapechar='`', low_memory=False) В некоторых полях таблицы есть поля со значением None. Этот встроенный тип, обозначающий неопределенность, поэтому некоторые алгоритмы анализа могут работать некорректно с этим значением, поэтому произведем замену None на строку ‘unknown’ в полях таблицы. Эта процедура называется импутацией.
df = df.replace(, 'unknown') Поменяем коды стран на названия на русском языке с помощью библиотеки pycountry и yandex-translate.
country_label_count = pd.value_counts(df['country'].values) # Получить из таблицы список всех меток country с их количеством for label in list(country_label_count.keys()): c = pycountry.countries.get(alpha_2=str(label).upper()) # Перевести код страны в полное название t = translate(c.name, translate_obj) # Перевести название страны на русский язык df = df.replace(, t) Переведем все названия видов объектов на небе на русский язык.
shapes_label_count = pd.value_counts(df['shape'].values) for label in list(shapes_label_count.keys()): t = translate(str(label), translate_obj) # Перевести название формы объекта на русский язык df = df.replace(, t) Первичную обработку данных на этом завершаем.
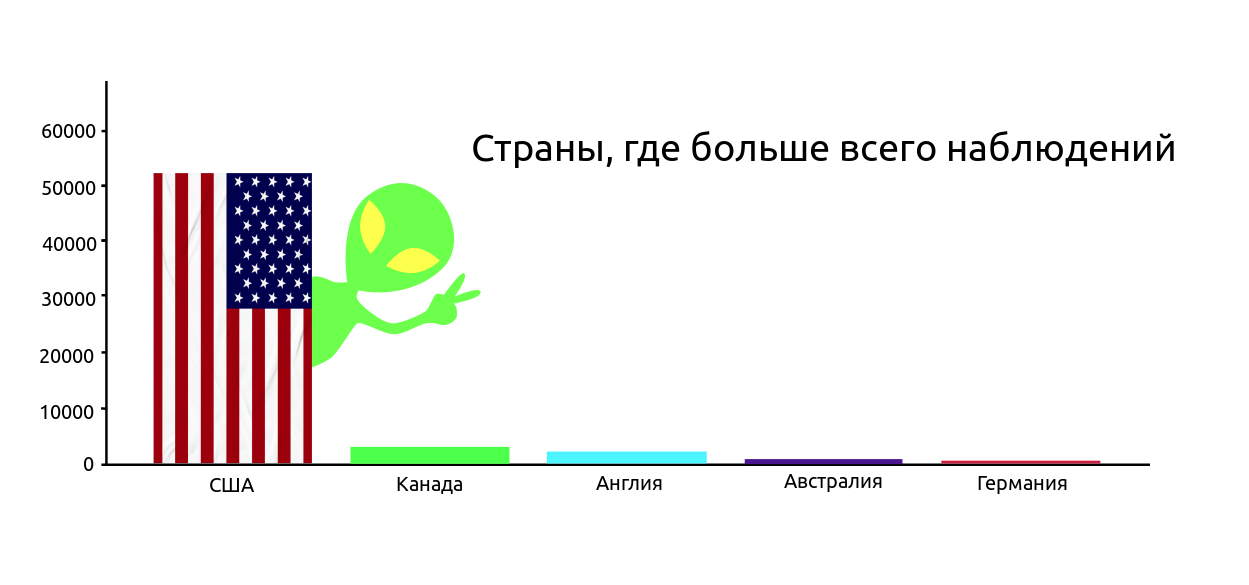
Постороим график наблюдений по странам. Для построения графиков используется библиотека pyplot. Примеры построения простого графика можно найти на официальном сайте https://matplotlib.org/users/pyplot_tutorial.html. Для построения гистограммы можно использовать метод bar.
country_count = pd.value_counts(df['country'].values, sort=True) country_count_keys, country_count_values = dict_sort(dict(country_count)) TOP_COUNTRY = len(country_count_keys) plt.title('Страны, где больше всего наблюдений', fontsize=PLOT_LABEL_FONT_SIZE) plt.bar(np.arange(TOP_COUNTRY), country_count_values, color=getColors(TOP_COUNTRY)) plt.xticks(np.arange(TOP_COUNTRY), country_count_keys, rotation=0, fontsize=12) plt.yticks(fontsize=PLOT_LABEL_FONT_SIZE) plt.ylabel('Количество наблюдений', fontsize=PLOT_LABEL_FONT_SIZE) plt.show() 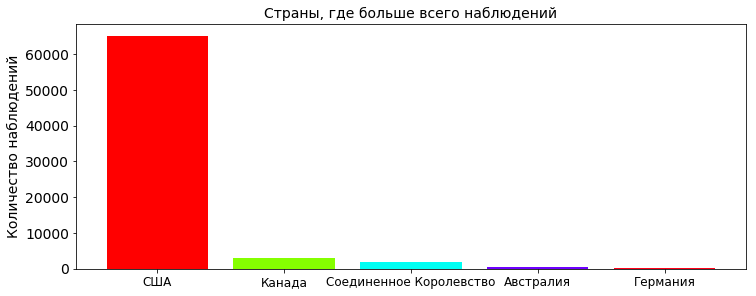
Больше всего наблюдений естественно в США. Тут ведь оно как, все гики, которые следят за НЛО живут в США (о версии, что таблица составлялась гражданами США, лукаво умолчим). Судя по количеству американских фильмов скорее всего второе. От Кэпа: если инопланетяне действительно посещали землю в открытую, то вряд ли бы их заинтересовала одна страна, сообщение об НЛО появлялись бы из разных стран.
Интересно еще посмотреть в какое время года наблюдали больше всего объектов. Есть резонное предположение, что больше всего наблюдений в весеннее время.
MONTH_COUNT = [0,0,0,0,0,0,0,0,0,0,0,0] MONTH_LABEL = ['Январь', 'Февраль', 'Март', 'Апрель', 'Май', 'Июнь', 'Июль', 'Август', 'Сентябрь' ,'Октябрь' ,'Ноябрь' ,'Декабрь'] for i in df['datetime']: m,d,y_t = i.split('/') MONTH_COUNT[int(m)-1] = MONTH_COUNT[int(m)-1] + 1 plt.bar(np.arange(12), MONTH_COUNT, color=getColors(12)) plt.xticks(np.arange(12), MONTH_LABEL, rotation=90, fontsize=PLOT_LABEL_FONT_SIZE) plt.ylabel('Частота появления', fontsize=PLOT_LABEL_FONT_SIZE) plt.yticks(fontsize=PLOT_LABEL_FONT_SIZE) plt.title('Частота появления объектов по месяцам', fontsize=PLOT_LABEL_FONT_SIZE) plt.show() 
Ожидалось весеннее обострение, но предположение не подтвердилось. Кажется теплые летние ночи и период отпусков дают о себе знать сильнее.
Посмотрим какие формы объектов на небе видели и сколько раз.
shapes_type_count = pd.value_counts(df['shape'].values) shapes_type_count_keys, shapes_count_values = dict_sort(dict(shapes_type_count)) OBJECT_COUNT = len(shapes_type_count_keys) plt.title('Типы объектов', fontsize=PLOT_LABEL_FONT_SIZE) bar = plt.bar(np.arange(OBJECT_COUNT), shapes_type_count_values, color=getColors(OBJECT_COUNT)) plt.xticks(np.arange(OBJECT_COUNT), shapes_type_count_keys, rotation=90, fontsize=PLOT_LABEL_FONT_SIZE) plt.yticks(fontsize=PLOT_LABEL_FONT_SIZE) plt.ylabel('Сколько раз видели', fontsize=PLOT_LABEL_FONT_SIZE) plt.show() 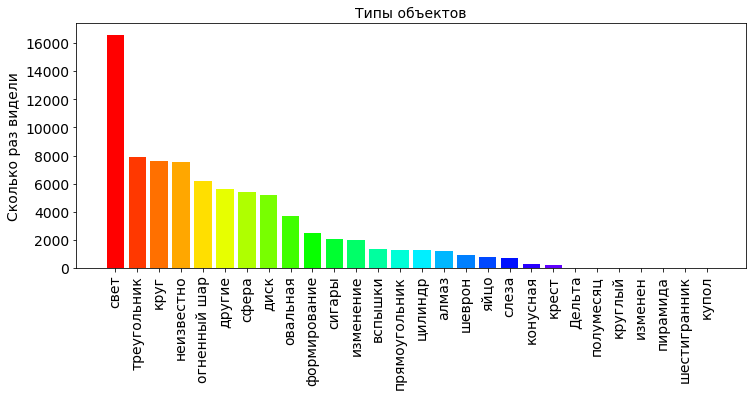
Из графика мы видим, что больше всего на небе видели просто свет, который в принципе необязательно является НЛО. Этому явлению существует внятное объяснение, например, ночное небо отражает свет от прожекторов, как в фильмах про Бэтмена. Также это вполне может быть северным сиянием, которое появляется не только в полярной зоне, но и в средних широтах, а изредка даже и в близи эвкватора. Вообще атмосфера земли пронизана множеством излучений различной природы, электрическими и магнитными полями.
Вообще, атмосфера Земли пронизана множеством излучений различной природы, электрическими и магнитными полями.
Интересно еще посмотреть среднее время, на которое в небе появлялся каждый из объектов.
shapes_durations_dict = <> for i in shapes_type_count_keys: dfs = df[['duration (seconds)', 'shape']].loc[df['shape'] == i] shapes_durations_dict[i] = dfs['duration (seconds)'].mean(axis=0)/60.0/60.0 shapes_durations_dict_keys = [] shapes_durations_dict_values = [] for k in shapes_type_count_keys: shapes_durations_dict_keys.append(k) shapes_durations_dict_values.append(shapes_durations_dict[k]) plt.title('Среднее время появление каждого объекта', fontsize=12) plt.bar(np.arange(OBJECT_COUNT), shapes_durations_dict_values, color=getColors(OBJECT_COUNT)) plt.xticks(np.arange(OBJECT_COUNT), shapes_durations_dict_keys, rotation=90, fontsize=16) plt.ylabel('Среднее время появления в часах', fontsize=12) plt.show() 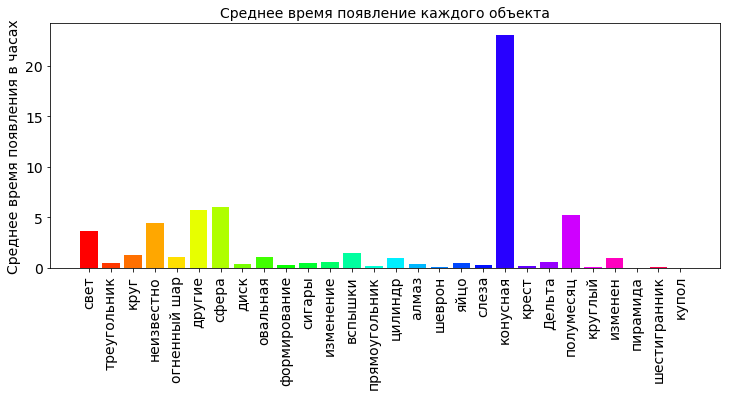
Из диаграммы видими, что больше всего в небе в среднем висел конус (более 20 часов). Если покопаться в интернетах, то ясно, что конусы в небе, это тоже свечение, только в виде конуса (неожиданно, да?). Вероятнее всего это свет от падающих комет. Среднее время больше 20 часов — это какая-то нереальная величина. В исследуемых данных большой разброс, и вполне могла вкраться ошибка. Несколько очень больших, неверных значений времени появления могут существенно исказить расчет среднего значения. Поэтому при больших отклонениях, считают не среднее значение, а медиану.
Медиана — это некоторое число, характеризующее выборку, одна половина в выборке меньше этого числа, другая больше. Для расчета медианы используем функцию median.
Заменим в коде выше:
shapes_durations_dict[i] = dfs['duration (seconds)'].mean(axis=0)/60.0/60.0shapes_durations_dict[i] = dfs['duration (seconds)'].median(axis=0)/60.0/60.0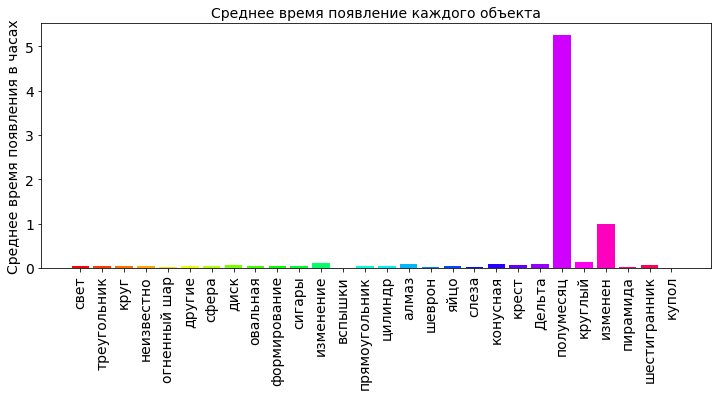
Полумесяц видели в небе чуть больше 5-ти часов. Другие объекты не надолго промелькнули в небе. Это уже наиболее достоверно.
Для первого знакомства с методологией обработки данных на Python, думаю, достаточно. В следующих публикациях займемся статистическим анализом, и постараемся выбрать другой не менее актуальный пример.