Быстрый старт
Описанные ниже шаги помогут создать кластер хранилища данных, подключиться к базе данных кластера и подготовиться к импорту и анализу данных.
- Перед началом
- Создание кластера
- Подключение к кластеру
- Импорт данных и выполнение запросов
Перед началом
- C помощью Cloud Trace Service ( CTS ) включите запись операций, выполняемых в консоли управления или посредством вызовов API . Аудит фиксируемых операций позволяет убедиться, что не выполняются недопустимые или несанкционированные действия, не связанные с запросами к базе данных.
См.также Подробнее о просмотре логов ключевых операций (en)
- Если ваш клиент находится за пределами межсетевого экрана, вам потребуется доступный порт, чтобы вы могли подключаться к кластеру и выполнять запросы и анализ с помощью инструментов SQL-клиента.
- Если у вас нет информации о доступном порте, свяжитесь с сетевым администратором, чтобы узнать, какой порт доступен через межсетевой экран. DWS поддерживает порты в интервале от 8000 до 30000.
После создания кластера его порт нельзя изменить. Убедитесь, что указанный при создании кластера порт доступен.
Создание кластера
Кластер состоит из нескольких узлов в одной подсети. Для добавления кластера:
- В консоли управления DWS на странице Cluster Management нажмите Apply for DWS Cluster .
- Задайте параметры узлов:
- Node Flavor — выберите вид узла. Если вы только знакомитесь с сервисом, оставьте значение по умолчанию.
- Nodes — количество узлов. Кластер состоит минимум из трех узлов.

- Задайте параметры кластера.
- Cluster Name — введите название кластера.
- Administrator Account — введите название аккаунта. После создания кластера клиент будет использовать его для подключения к базе данных.
- Administrator Password — задайте пароль администратора.
- Confirm Password — повторите пароль администратора.
- Database Port — укажите порт, по которому клиент или приложение будет подключаться к базе данных кластера. Поддерживаются порты в интервале от 8000 до 30000.

- Настройте параметры сети.
- VPC — выберите VPC .

Примечание Если VPC не сконфигурирована, нажмите Create VPC и создайте сеть VPC . После этого нажмите рядом со списком VPC и выберите созданную сеть.
Примечание Если вы выбрали настроенную раннее группу безопасности, добавьте входящее правило , чтобы открыть порт базы данных кластера для клиентских хостов.
Пример входящего правила
- Protocol/Application — «TCP».
- Port — «8000». Укажите порт, который вы задали в параметре Database Port при создании кластера.
- Source — выберите IP address , введите IP-адрес и маску подсети клиентского хоста, например, «192.168.0.10/16».

- Default — настройки по умолчанию:
- Automated Snapshot — включено создание снапшотов кластера;
- CNs — развернуты два CN;
- Parameter Template — к кластеру применяется шаблон параметров базы данных по умолчанию.
- Custom — выберите этот вариант, чтобы переопределить значения параметров по умолчанию.
Подключение к кластеру
- Получите имя пользователя и пароль для подключения к базе данных.
- На странице Cluster Management раскройте подробную информацию о кластере и скопируйте Public Network Address — публичный сетевой адрес.
- Подключитесь к базе данных кластера, используя публичный сетевой адрес.
См.также Способы подключения к кластеру (en).
Импорт данных и выполнение запросов
Вы можете импортировать данные в DWS из одного или нескольких источников: MRS , OBS , вставкой при помощи INSERT, загрузкой из NoSQL-базы данных, файловой системы, платформы больших данных.
7 шагов успешного создания хранилища данных(DWH)
Проектирование и построение хранилища данных (data warehouse) – задача масштабная и длительная. Необходимо учесть много факторов и нюансов, рассчитать бюджет и только на последнем этапе создавать DWH.
Рассмотрим создание хранилища данных поэтапно, рассказав о каждом шаге и возможных подводных камнях.
Для чего нужно DWH
Хранилище данных представляет собой предметно-ориентированную БД, которая аккумулирует всю информацию внутри организации в единую систему.
Данные в DWH используются не только для хранения, но и для дальнейшего анализа информации и предоставления консолидированных отчетов. На их основе руководители бизнеса принимают важные стратегические и управленческие решения.
В хранилище данных находится информация в течение многих десятков лет, что позволяет проводить более точную аналитику. При этом сам процесс анализа не влияет на производительность информационных систем, как происходит в случае использования обычных баз данных.
Архитектура DWH
Хранилище данных, построенное любым из методов, обязательно состоит из нескольких компонентов:
- Ядро. Главная часть любой DWH – обеспечивает целостность входящих данных. Структурирует полученную информацию согласно заданным параметрам.
- Область сбора информации. Компонент, который собирает всю входящую информацию с разных источников.
- Аналитическая часть отвечает за предоставления отчетности по требованию владельца.
- Сервис. Компонент отвечает за управление и стабильное взаимодействие трех предыдущих. Мониторит в режиме онлайн состояние каждого компонента и оперативно устраняет ошибки.
Методы создания DWH
Построение хранилища данных происходит по разным методикам.
- Классический метод. В его основе лежит разделение данных на две группы: измерения и факты. Связь между ними представлена в виде классических таблиц с внешним ключом. Возникает неудобство при добавлении новой составляющей в таблице, поскольку жесткая привязка таблиц к внешнему ключу не позволяет гибко менять структура data warehouse.
- Метод Инмона. По задумке создателя способа, сначала проектируется централизованное хранилище данных, а дальше добавляются витрины с информацией. При таком подходе загрузка входящей информации в data warehouse значительно упрощается, но увеличивается время при обработке запросов.
- Метод Кимбалла. В отличие от предыдущего способа DWH создается на основе витрин. Другими словами, сначала они заполняются необходимой информацией, а после проектируется централизованное хранилище.
- Метод 7D. Назван так по названиям этапов, которые включены в него: Discover, Design, Develop, Deploy, Day to day, Defend и Decommission.
Проектирование DWH с помощью 7D
Этап 1. Discover
Сначала анализируются требования к создаваемому хранилищу данных. Менеджер проекта тесно сотрудничает с представителями бизнеса, так как необходимо учитывать их задачи.
Чтобы получить необходимые данные, следует ответить на шесть главных вопросов: Что? Как? Где? Кто? Когда? Зачем?. Ответы на вопросы являются фундаментом будущей DWH.
Менеджер проекта детерминирует роли и требования по визуализации данных для заказчиков и пользователей.
Это очень важный этап, поскольку малейшая ошибка на нем приводит к невозможности создания хранилища данных.
Этап 2. Design
На втором шаге проектируются семантические и схематические реализации DWH. Для проектирования можно воспользоваться двумя методами:
- Создать концептуальные и логические реализации DWH совместно с пространственными моделями в виде многомерных кубов данных.
- Воспользоваться матрицей принятия решений для вычисления четких требований бизнеса к хранилищу данных.
Информация, которая используется на втором этапе, аккумулируется с разных внешних и внутренних источников. При этом на втором шаге сразу задаются параметры, по которым информация будет импортироваться в data warehouse либо работать со ссылкой на внешний источник.
Разделение происходит по двум уровням. На технологическом вычисляется необходимый размер дискового пространства для хранения и обработки поступающей информации. Параллельно сразу рассчитываются вычислительные мощности, которые потребуются для стабильной и быстрой работы DWH.
Закладываются расчеты на вырост. Другими словами, планируется значение, на которое ежегодно будут расти требования DWH к дисковому пространству и вычислительным мощностям аппаратной части.
Коммуникации, инженерные системы, кабелирование – также закладываются на технологическом уровне второго этапа.
На уровне приложений составляется список программного обеспечения, которое будет использоваться в DWH как для администраторов, так и для пользователей. ПО также включает в себя информационно-аналитические системы для формирования отчетов.
На данном уровне рекомендуется создавать визуальное изображение будущей модели для более наглядного показа заказчикам.
Успешным считается проектирование, когда обе полученные модели соответствуют задачам ИС управления и отображают аналитику под бизнес-задачи. Созданные на втором этапе модели должны удовлетворять в полном объеме шести вопросам, которые были озвучены на первом этапе.
А в Вашей организации есть хранилище данных?
Что такое data warehouse и как его построить
Компании получают данные из множества источников. Рекламная информация поступает из Google AdWords, сессии пользователей — из Google Analytics, данные продукта — из MySQL, MS Server или MongoDB. Информация о платежах — из 1C. Кроме этого, есть тикет-системы, чаты, CRMs и даже Excel-файлы.
Вручную обрабатывать и соединять эту информацию — нецелесообразно и дорого. Поэтому многие компании используют data warehouse (хранилище данных).
Оксана Носенко, лектор курса «SQL для аналитики» в robot_dreams, Senior Product Analyst в Jooble, объясняет, чем data warehouse отличается от базы данных и как создать собственное хранилище.
Хранение данных в «облаке»
Data warehouse — это система, которая хранит данные из разных источников для аналитики и составления отчетов.
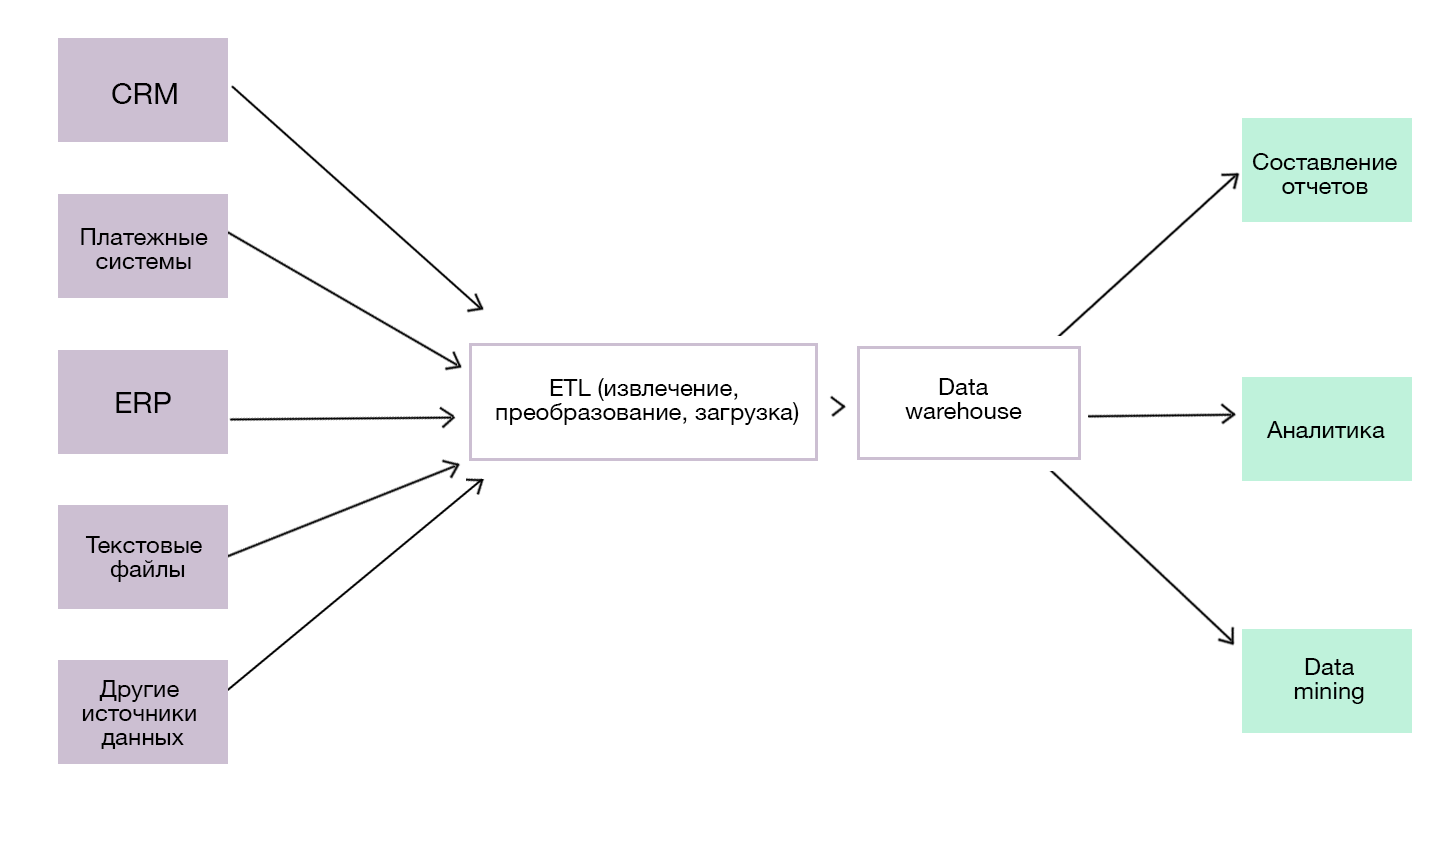
Схема хранилища данных
Хранилища отличаются от баз данных по ряду признаков:
- данные в warehouse не обязательно должны поступать в реальном времени (если иное не предусмотрено бизнес-задачей);
- данные могут иметь разную структуру (в зависимости от источников);
- хранилище не обязательно должно работать быстро. Главное, чтобы скорости хватало для решения всех аналитических задач.
Data warehouse подходит для сложных и комплексных вычислений лучше, чем база данных. Во время выполнения сложного запроса база данных может быть перегружена. Из-за этого вы рискуете потерять новую информацию — для ее обработки не хватит ресурсов.
Как создать data warehouse
Для хранения данных чаще всего используют cloud-решения. Их плюсы:
- поддержка и масштабируемость: не надо выделять комнату для серверов и подключать новые в случае роста нагрузки. Обычно облачное хранилище масштабируется автоматически;
- производительность: облачные решения работают быстрее традиционных и автоматически перераспределяют нагрузку;
- доступ к данным: чтобы попасть в облачное хранилище, не нужно устанавливать сервер на компьютер. Достаточно открыть браузер и войти в облако. SQL-запрос можно делать даже со смартфона.
Основные cloud warehouses — Amazon Redshift, Google BigQuery, Azure.
У них разная стоимость, производительность, экосистема, поддержка.
В продуктовых IT-компаниях, где я работала, мы выбирали Google Big Query по этим причинам:
- хранилище в GBQ запустить можно быстро и без помощи администраторов баз данных. Нужно только создать аккаунт в Google Cloud;
- формат pay-as-you-go: оплата по мере потребления только за те услуги, которые используем. Не нужно заранее выбирать самый оптимальный пакет;
- готовые pipeline-решения. Многие платформы предоставляют услуги трансфера данных в GBQ. Поэтому warehouse запускали только аналитики, без разработчиков и админов.
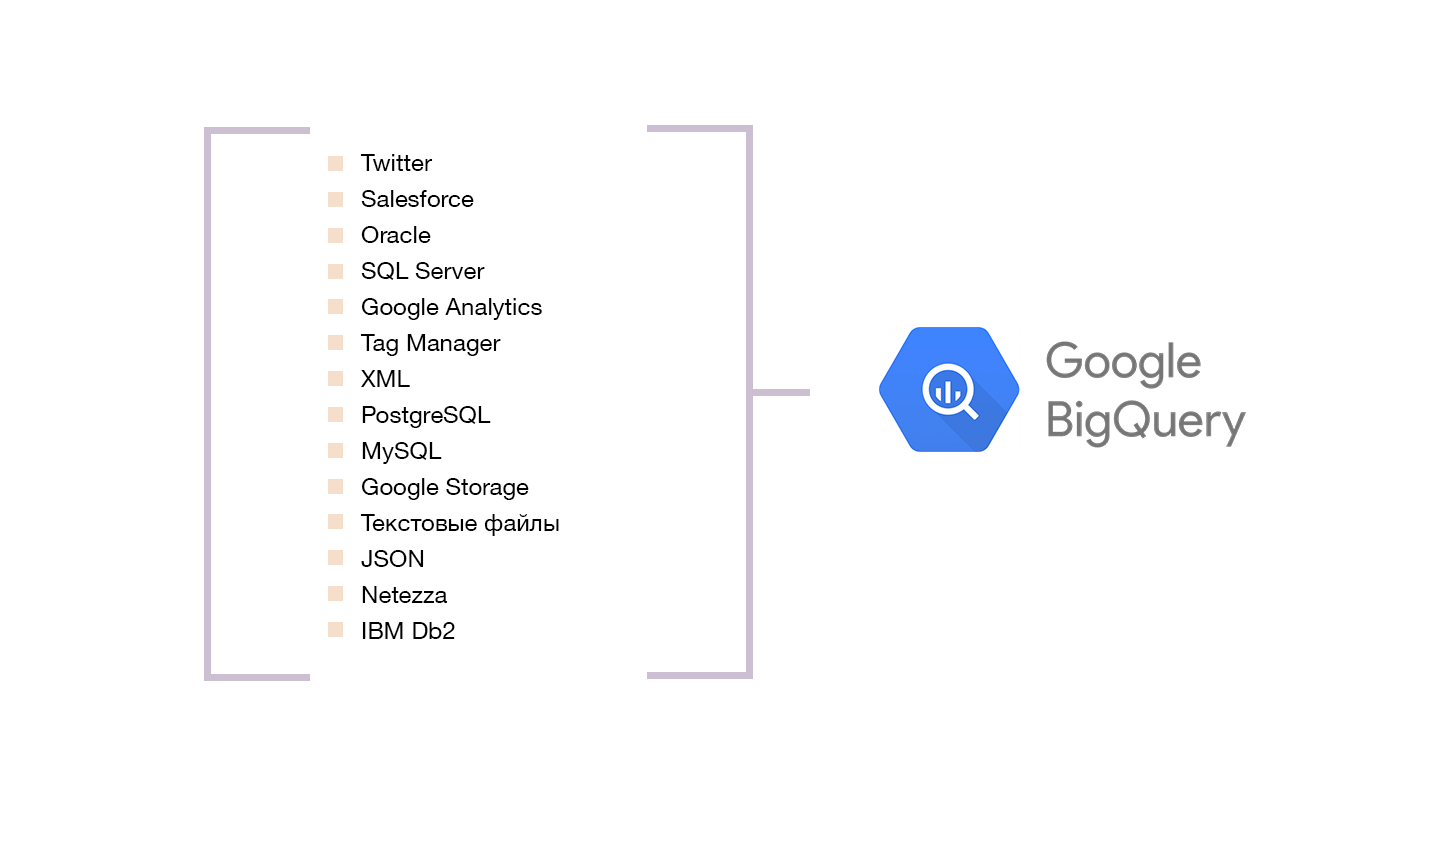
Пример GBQ Data Warehouse
Основной минус Big Query — плата за запросы. Каждый SQL-запрос использует определенный объем памяти, за который нужно платить в конце месяца. Поэтому советую поставить ограничение на количество запросов в день.
Создавая хранилище данных, нужно учитывать все сложности. Основная проблема — конструирование пайплайнов. Нужно настроить трансфер данных из всех источников в единое хранилище. Во время него придется столкнуться с несовершенными API, ограничениями по выгрузке или парсингом данных. Можно писать все соединения самостоятельно или использовать готовые решения (например, Owox, Alooma, Blendo). Тем, кто работает с большим объемом информации, лучше написать свои скрипты, которые будут синхронизировать данные каждый день.
Маленькому бизнесу без администратора баз данных стоит использовать pipeline-платформу. Ее стоимость зависит от объема информации и количества соединений.
Вторая сложность — качество данных. Трансфер данных может не выдавать ошибку. Но при этом информация может быть неполной (из-за ограничений в API). Также есть риск ошибки во время дальнейшего парсинга переменных (например, возникнут проблемы с кодировкой данных из 1С).
Следующий шаг после создания хранилища — выбор инструментов для разработки frontend-части. Бизнесу нужно видеть графики, срезы, сравнения и динамику.
Создание хранилища в Microsoft Fabric
В этой статье описывается, как приступить к работе с хранилищем в Microsoft Fabric с помощью портала Microsoft Fabric, включая обнаружение создания и потребления хранилища. Вы узнаете, как создать склад с нуля и примера вместе с другими полезными сведениями, чтобы ознакомиться с возможностями склада, предлагаемыми на портале Microsoft Fabric.
Важно отметить, что большая часть функциональных возможностей, описанных в этом разделе, также доступна пользователям с помощью подключения к конечной точке TDS и таких средств, как SQL Server Management Studio (SSMS) или Azure Data Studio (для пользователей, которые предпочитают использовать T-SQL для большинства своих потребностей в обработке данных). Дополнительные сведения см. в разделе Подключение ivity или Query a warehouse.
Вы можете продолжить работу с пустым хранилищем или примером хранилища, чтобы продолжить эту серию шагов по началу работы.
Создание хранилища
В этом разделе мы рассмотрим три различных интерфейса, доступные для создания хранилища с нуля на портале Microsoft Fabric.
Создание хранилища с помощью домашнего концентратора
Первый концентратор в меню навигации слева — главная . Вы можете начать создание хранилища из домашнего центра, выбрав карта складав разделе «Создать«. Пустое хранилище создается для начала создания объектов в хранилище. Вы можете использовать примеры данных, чтобы начать переход или загрузить собственные тестовые данные , если вы предпочитаете.

Создание хранилища с помощью центра создания
Другой вариант, доступный для создания хранилища, — это центр создания, который является вторым концентратором в меню навигации слева.
Вы можете создать хранилище из центра создания, выбрав карта хранилища в разделе Хранилище данных. При выборе карта пустое хранилище создается для начала создания объектов в хранилище или использования примера для начала работы, как раньше упоминание.

Создание хранилища из представления списка рабочих областей
Чтобы создать хранилище, перейдите в рабочую область, нажмите кнопку +Создать , а затем выберите «Склад «, чтобы создать склад.

После инициализации можно загрузить данные в хранилище. Дополнительные сведения о получении данных в хранилище см. в разделе приема данных.

Создание примера хранилища
В этом разделе мы рассмотрим два различных интерфейса, доступные для создания примера хранилища с нуля.
Создание примера хранилища с помощью домашнего концентратора
- Первый концентратор в меню навигации слева — главная . Вы можете начать создание примера хранилища из домашнего центра, выбрав пример хранилища карта в разделе «Создать«.

- Укажите имя примера хранилища и нажмите кнопку «Создать«.

- Действие создания создает хранилище и начинает загрузку примеров данных в него. Загрузка данных занимает несколько минут.

- После завершения загрузки примеров данных хранилище открывается с данными, загруженными в таблицы и представления для запроса.

Загрузка примеров данных в существующее хранилище
Дополнительные сведения о создании хранилища см. в статье «Создание хранилища данных Synapse».
- После создания хранилища можно загрузить образец данных в хранилище из примера базы данных карта.

- Загрузка данных занимает несколько минут.

- При завершении загрузки примеров данных хранилище отображает данные, загруженные в таблицы и представления для запроса.

Примеры сценариев
/************************************************* Get number of trips performed by each medallion **************************************************/ SELECT M.MedallionID ,M.MedallionCode ,COUNT(T.TripDistanceMiles) AS TotalTripCount FROM dbo.Trip AS T JOIN dbo.Medallion AS M ON T.MedallionID=M.MedallionID GROUP BY M.MedallionID ,M.MedallionCode /**************************************************** How many passengers are being picked up on each trip? *****************************************************/ SELECT PassengerCount, COUNT(*) AS CountOfTrips FROM dbo.Trip WHERE PassengerCount > 0 GROUP BY PassengerCount ORDER BY PassengerCount /********************************************************************************* What is the distribution of trips by hour on working days (non-holiday weekdays)? *********************************************************************************/ SELECT ti.HourlyBucket, COUNT(*) AS CountOfTrips FROM dbo.Trip AS tr INNER JOIN dbo.Date AS d ON tr.DateID = d.DateID INNER JOIN dbo.Time AS ti ON tr.PickupTimeID = ti.TimeID WHERE d.IsWeekday = 1 AND d.IsHolidayUSA = 0 GROUP BY ti.HourlyBucket ORDER BY ti.HourlyBucket
Вы можете продолжить работу с пустым хранилищем или примером хранилища, чтобы продолжить эту серию шагов по началу работы.