Set tmp d garbage что она делает
PHP поддерживает один оператор управления ошибками: знак @ . В случае если он предшествует какому-либо выражению в PHP-коде, любые сообщения об ошибках, генерируемые этим выражением, будут подавлены.
Если пользовательская функция обработчика ошибок установлена функцией set_error_handler() , она всё равно будет вызываться, даже если диагностика была подавлена.
Внимание
До версии PHP 8.0.0 функция error_reporting() , вызываемая внутри пользовательского обработчика ошибок, всегда возвращала 0 , если ошибка была подавлена оператором @ . Начиная с PHP 8.0.0 она возвращает значение этого (побитового) выражения: E_ERROR | E_CORE_ERROR | E_COMPILE_ERROR | E_USER_ERROR | E_RECOVERABLE_ERROR | E_PARSE .
Любое сообщение об ошибке, сгенерированное выражением, доступно в элементе массива с ключом «message» , возвращаемого функцией error_get_last() . Результат этой функции будет меняться при каждой ошибке, поэтому его необходимо проверить заранее.
/* Преднамеренная ошибка при работе с файлами */
$my_file = @ file ( ‘non_existent_file’ ) or
die ( «Ошибка при открытии файла: сообщение об ошибке было таким: ‘» . error_get_last ()[ ‘message’ ] . «‘» );
// работает для любых выражений, а не только для функций
$value = @ $cache [ $key ];
// В случае если ключа $key нет, сообщение об ошибке (notice) не будет отображено
Замечание: Оператор @ работает только с выражениями. Есть простое правило: если что-то возвращает значение, значит, можно указать перед ним оператор @ . Например, можно указать оператор @ перед именем переменной, произвольной функцией, вызовом выражения include и т. д. При этом нельзя указывать этот оператор перед определением функции или класса, условными конструкциями, например: if , foreach и т. д.
Внимание
До PHP 8.0.0 оператор @ мог подавлять критические ошибки, которые прерывали выполнение скрипта. Например, добавление оператора @ к вызову несуществующей функции, когда она недоступна или вызвана с опечаткой, приведёт к прерыванию выполнения скрипта без указания причины.
Смотрите также
- error_reporting()
- Обработка ошибок и функции логирования
User Contributed Notes 16 notes
15 years ago
I was confused as to what the @ symbol actually does, and after a few experiments have concluded the following:
* the error handler that is set gets called regardless of what level the error reporting is set on, or whether the statement is preceeded with @
* it is up to the error handler to impart some meaning on the different error levels. You could make your custom error handler echo all errors, even if error reporting is set to NONE.
* so what does the @ operator do? It temporarily sets the error reporting level to 0 for that line. If that line triggers an error, the error handler will still be called, but it will be called with an error level of 0
Hope this helps someone
14 years ago
Be aware of using error control operator in statements before include() like this:
(@include( «file.php» ))
OR die( «Could not find file.php!» );
?>
This cause, that error reporting level is set to zero also for the included file. So if there are some errors in the included file, they will be not displayed.
10 years ago
This operator is affectionately known by veteran phpers as the stfu operator.
12 years ago
If you’re wondering what the performance impact of using the @ operator is, consider this example. Here, the second script (using the @ operator) takes 1.75x as long to execute. almost double the time of the first script.
So while yes, there is some overhead, per iteration, we see that the @ operator added only .005 ms per call. Not reason enough, imho, to avoid using the @ operator.
function x () < >
for ( $i = 0 ; $i < 1000000 ; $i ++) < x (); >
?>
real 0m7.617s
user 0m6.788s
sys 0m0.792s
function x () < >
for ( $i = 0 ; $i < 1000000 ; $i ++) < @ x (); >
?>
real 0m13.333s
user 0m12.437s
sys 0m0.836s
14 years ago
Error suppression should be avoided if possible as it doesn’t just suppress the error that you are trying to stop, but will also suppress errors that you didn’t predict would ever occur. This will make debugging a nightmare.
It is far better to test for the condition that you know will cause an error before preceding to run the code. This way only the error that you know about will be suppressed and not all future errors associated with that piece of code.
There may be a good reason for using outright error suppression in favor of the method I have suggested, however in the many years I’ve spent programming web apps I’ve yet to come across a situation where it was a good solution. The examples given on this manual page are certainly not situations where the error control operator should be used.
7 years ago
There is no reason to NOT use something just because «it can be misused». You could as well say «unlink is evil, you can delete files with it so don’t ever use unlink».
It’s a valid point that the @ operator hides all errors — so my rule of thumb is: use it only if you’re aware of all possible errors your expression can throw AND you consider all of them irrelevant.
A simple example is
?>
There are only 2 possible problems here: a missing variable or a missing index. If you’re sure you’re fine with both cases, you’re good to go. And again: suppressing errors is not a crime. Not knowing when it’s safe to suppress them is definitely worse.
2 years ago
It’s still possible to detect when the @ operator is being used in the error handler in PHP8. Calling error_reporting() will no longer return 0 as documented, but using the @ operator does still change the return value when you call error_reporting().
My PHP error settings are set to use E_ALL, and when I call error_reporting() from the error handler of a non-suppressed error, it returns E_ALL as expected.
But when an error occurs on an expression where I tried to suppress the error with the @ operator, it returns: E_ERROR | E_PARSE | E_CORE_ERROR | E_COMPILE_ERROR | E_USER_ERROR | E_RECOVERABLE_ERROR (or the number 4437).
I didn’t want to use 4437 in my code in case it changes with different settings or future versions of PHP, so I now use:
function my_error_handler ( $err_no , $err_msg , $filename , $linenum ) if ( error_reporting () != E_ALL ) return false ; // Silenced
>
// .
>
?>
If the code needs to work with all versions of PHP, you could check that error_reporting() doesn’t equal E_ALL or 0.
And, of course, if your error_reporting settings in PHP is something other than E_ALL, you’ll have to change that to whatever setting you do use.
4 years ago
Quick debugging methods :
@print($a);
is equivalent to
if isset($a) echo $a ;
@a++;
is equivalent to
if isset($a) $a++ ;
else $a = 1;
4 years ago
Please be aware that the behaviour of this operator changed from php5 to php7.
The following code will raise a Fatal error no matter what, and you wont be able to suppress it
function query ()
$myrs = null ;
$tmp = @ $myrs -> free_result ();
13 years ago
After some time investigating as to why I was still getting errors that were supposed to be suppressed with @ I found the following.
1. If you have set your own default error handler then the error still gets sent to the error handler regardless of the @ sign.
2. As mentioned below the @ suppression only changes the error level for that call. This is not to say that in your error handler you can check the given $errno for a value of 0 as the $errno will still refer to the TYPE(not the error level) of error e.g. E_WARNING or E_ERROR etc
3. The @ only changes the rumtime error reporting level just for that one call to 0. This means inside your custom error handler you can check the current runtime error_reporting level using error_reporting() (note that one must NOT pass any parameter to this function if you want to get the current value) and if its zero then you know that it has been suppressed.
// Custom error handler
function myErrorHandler ( $errno , $errstr , $errfile , $errline )
if ( 0 == error_reporting () ) // Error reporting is currently turned off or suppressed with @
return;
>
// Do your normal custom error reporting here
>
?>
For more info on setting a custom error handler see: http://php.net/manual/en/function.set-error-handler.php
For more info on error_reporting see: http://www.php.net/manual/en/function.error-reporting.php
13 years ago
Be aware that using @ is dog-slow, as PHP incurs overhead to suppressing errors in this way. It’s a trade-off between speed and convenience.
12 years ago
If you use the ErrorException exception to have a unified error management, I’ll advise you to test against error_reporting in the error handler, not in the exception handler as you might encounter some headaches like blank pages as error_reporting might not be transmitted to exception handler.
function exception_error_handler ( $errno , $errstr , $errfile , $errline )
throw new ErrorException ( $errstr , 0 , $errno , $errfile , $errline );
>
function catchException ( $e )
if ( error_reporting () === 0 )
return;
>
?>
It would be better to do :
function exception_error_handler ( $errno , $errstr , $errfile , $errline )
if ( error_reporting () === 0 )
return;
>
throw new ErrorException ( $errstr , 0 , $errno , $errfile , $errline );
>
function catchException ( $e )
// Do some stuff
>
1.1.2. Команды управления файловой системой Windows
Одной из основных подсистем любой операционной системы является файловая система. Для управления файлами используется целая группа команд, позволяющих создавать и уничтожать их, переименовывать, копировать, редактировать и т.п. Рассмотрим наиболее употребительные из них.
1. Одной из интересных команд управления файловой системой является команда start. Она служит для запуска указанной в качестве параметра программы или команды в отдельном окне. Правда, запуск отдельных программ можно осуществлять и минуя эту команду. Например, следующие варианты команд:
C:>start Document.txt или
C:>start notepad Document.txt или
C:> notepad Document.txt
приводят к одному и тому же эффекту – вызову программы Блокнот с последующей загрузкой в него файла Document.txt, если такой файл существует.
Команда start Она интересна тем, что позволяет управлять приоритетами программ. Это очень важное качество команды, так как очередь готовых программ упорядочивается по убыванию их приоритетов, а значит, команда позволяет управлять последовательностью запуска программ. Все современные компьютеры являются многопрограммными. Из очереди готовых программ сначала запускаются программы с высоким приоритетом, затем с более низким.
Имеются четыре стандартных приоритета: самый низкий (low) – 4; нормальный (normal) – 8; высокий (high) – 13; реального времени (realtime) – 24. Последний вид приоритета пользователям не рекомендуется использовать, так как это может дестабилизировать систему. Значение приоритета задается в виде параметра сразу после команды start перед именем запускаемой программы, например:
C:> start /low notepad
C:> start /high test.bat.
2. Команда dir – команда вывода на экран дисплея содержимого каталогов (папок). Команда дает пользователю достаточно большой объем информации. Она выдает полный перечень всех папок и файлов в исследуемом каталоге. Содержимое каталога (папки) включает данные об имеющихся файлах и дочерних каталогах, их именах, размерах файлов, времени и датах их создания, а также сводные данные:
- общее число всех файлов, размещаемых в каталоге, и их суммарный объем;
- общее число папок в каталоге;
- общий объем свободного пространства диска, доступный пользователю.
Две первые строки содержимого каждого каталога вместо имен помечены точкой и двумя точками, что обозначает соответственно вход и выход в данном каталоге (папке).
Формат этой команды
dir диск:путь\имя_файла
Наиболее употребительными вариантами применения этой команды служат:
a) Использование команды dir без параметров, т.е. подразумевается исследование содержимого текущих каталогов и дисков, например, как показано ниже.
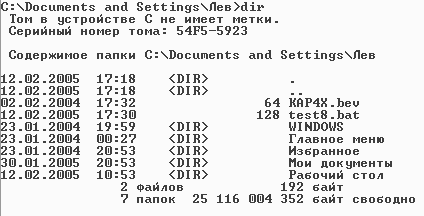
b) Использование команды dir с параметром /p. Используется в случаях, когда количество объектов в каталоге превышает количество строк экрана. Осуществляется вывод страницами, для перехода на следующую страницу следует нажать любую клавишу. Практически аналогом этого варианта применения команды является использование конвейера двух команд dir | more;
c) Использование команды dir с параметром /w. В этом случае на экран выдается краткая информация о содержимом каталога в виде пяти столбцов с именами файлов и сводные данные.
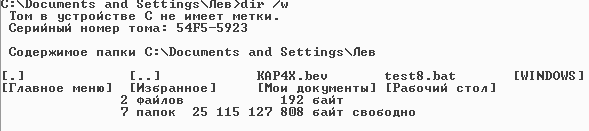
3. Кроме команды dir, формирующей информацию о содержимом каталогов и файлов, существует еще одна команда tree, строящая дерево каталогов и выводящая его на экран дисплея. Команда позволяет представить структуру каталогов. Формат команды:
tree диск:\маршрут /f
Ключ /f означает, что список файлов каждого каталога выводится на дисплей. Если в команде tree не указаны параметры диск:\ и маршрут, то по умолчанию, считается, что требуется вывести структуру подкаталогов и файлов текущего каталога.
Команда tree \ предполагает вывод всей структуры дерева каталогов текущего диска. Изучение дерева каталогов большого объема можно проводить постранично, используя конвейер команд, например: tree d:\ /f | more.
Результат выполнения команды tree можно сохранить в любом текстовом файле, указав его имя, например: tree d:\ /f tree.lst, или путем перенаправления операции вывода (используя знаки > и >>).
4. Команда find используется для поиска фрагмента текстовой строки (определенного набора символов – шаблона поиска) в одном или нескольких файлах. Формат команды
find [/v] [/c] [/n] [/i] “строка символов” [[диск:][путь]имя файла[…]].
Если путь к файлу и его имя в команде не заданы, то поиск выполняется в тексте, вводимом с клавиатуры или переданном по конвейеру другой командой. Команда имеет четыре ключа, определяющие режимы поиска:
/c – поиск с определением общего числа строк в файле, содержащих шаблон поиска;
/i – поиск строк, содержащих шаблон поиска, без учета регистра символов (прописных и строчных букв);
/n – поиск строк, содержащих шаблон, с отображением порядковых номеров строк;
/v – вывод на экран всех строк файла, не содержащих шаблон поиска.
Команда find в конвейерах с другими командами служит мощным средством получения итоговых характеристик исследования каталогов (папок). Например, если внимательно изучить структуру и содержание информации, выдаваемой по команде dir, то можно получать следующие характеристики:
dir | find “файлов” – количество файлов в каталоге и их суммарный объем;
dir | find “байт” – то же самое, так как внутри строки информация не разделяется;
dir | find “папок” – количество папок в каталоге и объем свободного пространства диска;
dir | find “.txt” – весь перечень строк, характеризующих текстовые файлы. Меняя тип расширения файлов, можно получить аналогичную характеристику по другим типам файлов;
dir | find /c “.doc” – подсчет общего числа файлов с заданным расширением.
Обратим внимание, что информация, получаемая перечисленными конвейерами, не может быть определена с помощью рубрик меню Windows.
5. Следует иметь в виду, что при формировании файловой структуры желательно иметь дерево каталогов “широким, но не глубоким”. Это позволяет уменьшить трудоемкость записи маршрута при доступе к нужному файлу, а значит, сократить число ошибок в наборе требуемых команд. Но это требование не всегда удается выполнить. В этом случае полезно использовать команду subst, заменяющую длинный маршрут доступа к объектам каталога одной буквой или более простым идентификатором. По существу команда создает виртуальный, логический диск с более простым доступом. Формат команды
subst диск1: диск2:\маршрут\
Здесь параметр диск1: несет указание буквы (идентификатора) виртуального диска, которой будет обозначаться требуемый каталог. Параметр диск2:\маршрут\ указывает местонахождение (наименование диска и маршрут следования) требуемого каталога. Например, команда subst q: a:\letters\pavlov формирует виртуальный диск q: вместо маршрута a:\letters\pavlov. Удаление виртуального диска производится командой subst диск1: /d.
6. Очень похожие действия по уменьшению трудоемкости использования “длинных” путей к файлам можно выполнить с помощью команды set. Эта команда предназначается для вывода, создания и удаления переменных среды интерпретатора команд cmd.exe. Она имеет формат
set [переменная = [строка]],
где переменная задается именем переменной среды,
строка – это строка символов, присваиваемая указанной переменной.
По этой команде формируется символьная переменная окружения в резервируемой памяти операционной системы, доступной для команд ОС и программам пользователей. Следует помнить, что имя создаваемой переменной не должно совпадать с ключевыми резервируемыми словами. Команда set без параметра выводит содержимое всех используемых ОС переменных окружения, а команда set имя = (без значения) удаляет соответствующую строку из окружения.
Например, команда set TMP=E:\GARBAGE устанавливает значение переменной окружения TMP, которую прикладные программы фирмы Microsoft (Word, Excel и др.) используют для определения каталога TMP, в котором они будут создавать временные файлы. Файлы, имеющие малый период существования, можно помещать в этот каталог. Это исключает рассеивание этих файлов по дисковым накопителям, их выявление и удаление.
Команда set в последних версиях Windows достаточно сложна и имеет много дополнительных возможностей. Так, например, с ключом /a (set /a переменная = выражение) она, по существу, является совершенно новой командой. Она позволяет обрабатывать арифметические и алгебраические выражения, заданные в правой части равенства. Обработчик формул очень прост и поддерживает следующие операции над десятичными, восьмеричными и шестнадцатеричными переменными:
^ — двоичное исключающее ИЛИ;
Ниже представлен пример задания целочисленной переменной d и с помощью нее подсчет некоторых целочисленных констант, новые значения которых выводятся сразу после выполнения набранных команд.
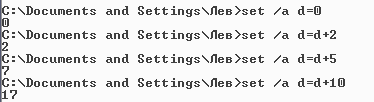
В следующем параграфе при разработке командных (пакетных) файлов будет показано, как эта команда в данной конструкции будет использоваться для подсчета некоторых характеристик проводимых вычислений.
7. Команда mkdir или md. Предназначается для создания новых каталогов (папок). Формат команды
mkdir (или md) диск:путь\имя_каталога
Например, команда C:\>md a:\practice обозначает, что, работая в корневом каталоге диска C:, создаем в корневом каталоге дискеты А: дочерний каталог \practice.
Если в команде не указывается диск и путь, то по умолчанию подразумевается, что создается дочерний каталог текущего каталога. При создании новых пользовательских каталогов необходимо придерживаться уже указанного правила: дерево создаваемых каталогов должно быть “широким, но не глубоким”. В противном случае трудоемкость записи пути к требуемым каталогам и файлам резко возрастает.
8. Команда chdir (или cd) – команда смены каталога. Команда имеет формат
Команда имеет следующие особенности применения:
- При выполнении команды новым текущим каталогом становится последний из указанных в пути каталогов.
- Если в команде параметр диск:путь не указан, то командный процессор выводит сообщение пути к текущему каталогу. Применение данного варианта оправдано, когда стандартный вид приглашения (prompt $p$g) не установлен.
- Если поиск нового каталога требуется начать с корневого каталога, то в качестве первого символа пути используется символ /. В противном случае поиск начинается с текущего каталога.
- Для перехода из дочернего каталога в родительский каталог лучше всего применять сокращенную форму, например, cd..
- Для перехода из каталога нижнего уровня в корневой каталог диска лучше всего применять сокращенную форму, например, cd\.
9. Команда copy (копирование) – достаточно сложная команда. Помимо основного своего назначения – копирования файлов, она используется для их объединения (конкатенации), создания новых текстовых файлов, передачи параметров на отдельные устройства и др.
Для копирования команда имеет следующий формат
copy Идиск:путь\имя_файла.расш Пдиск:путь\имя_файла.расш
В команде сначала указывается входная спецификация Идиск: путь\имя_файла.расш (Идиск: – имя диска-источника источника), затем – выходная Пдиск:путь\имя_файла.расш (П-приемника). В спецификациях источника и приемника допускается применение шаблонов групповых операций. В шаблонах используются символы: * – произвольное сочетание символов, ? – произвольный одиночный символ.
- Команда >copy a:s*.txt c:\proba выполняет копирование с дискеты всех текстовых файлов с именами, начинающимися с буквы s и расширением txt.
- Команда >copy a:*.* nul осуществляет копирование всех файлов с дискеты a: на несуществующее псевдоустройство nul с целью проверки их “читаемости”. Команда очень полезна, когда копируется очень важная информация для дальнейшего использования.
Для объединения (конкатенации) файлов используется другой формат
copy И1диск:путь\имя_файла.расш + И2диск:путь\имя_файла.расш +… Пдиск:путь\имя_файла.расш
Файлы, подлежащие объединению, задаются своими спецификациями И1…, И2…и т.д. между которыми ставится знак +. Результат (объединенный файл) формируется по спецификации приемника П…. Если спецификация приемника отсутствует, то результат формируется по спецификации И1….
1) copy ch1.doc+ch2.doc+ch3.doc book.doc /v
Данная команда производит объединение трех файлов ch1.doc, ch2.doc и ch3.doc в один файл book.doc в текущем каталоге текущего диска с проверкой записи.
2) copy ch*.doc book.doc /v
Данная команда производит объединение всех файлов ch*.doc с произвольными номерами в один файл book.doc в текущем каталоге текущего диска с проверкой записи.
3) copy con+trans.bat trans.bat
По данной команде строки, вводимые с клавиатуры, добавляются в начало уже существующего файла trans.bat. Ввод завершается нажатием клавиш +Z и .
Все варианты команды copy могут использовать ключи /a, /b, /v. Ключ /a рассматривает обрабатываемые файлы, как текстовые в коде ASCII (Американский код передачи информации). Ключ /b обозначает, что файлы рассматриваются как двоичные. Это следует учитывать, особенно при объединении текстовых файлов. Если объединяются текстовые файлы, то признаки окончаний этих файлов (+Z или F6) изымаются и остается только последний. При объединении двоичных файлов признаки окончаний файлов не изымаются. Ключ /v включает проверку правильности результата после копирования или объединения.
Интересна следующая модификация команды copy
Команда расшифровывается: копировать информацию, набираемую на клавиатуре (con — консоли) на принтер (prn – ключевое слово, обозначающее принтер). Она позволяет реализовать режим пишущей машинки. Текст, набираемый на клавиатуре, поступает на принтер и, если используется матричный принтер, то распечатывается посимвольно.
С помощью этой же команды можно производить передачу и установку значений некоторых параметров на отдельные устройства компьютера. При этом передача значений параметров производится в общем потоке данных, следующих в файле на устройство в виде управляющих Esc-последовательностей. Выполните задание, записанное в конце этого пункта. Оно как раз и иллюстрирует передачу параметров на принтер.
Создание текстовых файлов можно выполнить следующей командой
Например, для создания файла f1.txt в текущем каталоге необходимо выполнить команду copy con f1.txt.
Этой командой ввод текста с клавиатуры (консоли con) осуществляется в новый, создаваемый этой операцией файл f1.txt. После набора каждой строки следует нажимать клавишу . Окончание набора файла должно заканчиваться нажатием клавиш +Z или F6 (признаком окончания файла), а затем . Недостатком применения этой команды является то, что редактировать можно только текущую строку файла. После нажатия клавиши ранее введенные строки уже не доступны. Таким образом, команда copy использует простейший однострочный редактор.
10. Более привычным для пользователей будет использование внешнего редактора, вызываемого командой
Этот редактор имеет собственное, достаточно подробное меню. С помощью этого редактора удобно оперативно вносить изменения и создавать новые версии исследуемых примеров.
11. Команда type – команда просмотра содержимого текстовых файлов. Формат команды
Если в параметрах команды не задан диск и путь, а указано только имя файла, то подразумевается, что ведется работа с файлами текущего каталога. В параметре команды имена файлов должны быть определены однозначно, шаблоны групповых операций недопустимы.
12. Атрибуты файлов. Каждый файл и каталог, находящиеся в компьютере, могут иметь атрибуты – характеристики, отражающие свойства объекта, которые используются операционной системой для корректной работы с ними. Атрибутами файла (файлов) могут быть:
- R – “только для чтения”, то есть нельзя модифицировать файл и уничтожить его;
- A – “архивный”, то есть +А обозначает, что снимались копии данного файла, соответственно –А – файл является вновь созданным;
- H – “скрытый”, скрытые файлы не показываются командой dir и некоторыми программными оболочками;
- S – “системный”, этот атрибут показывает, что файл является принадлежностью операционной системы.
Изменение атрибутов файлов осуществляется командой attrib. Формат команды
Attrib +|-атрибут диск:\маршрут\имя файла /s
Установка любого атрибута производится знаком “+”, отмена – знаком “-“. Можно задавать изменение сразу нескольких атрибутов в любой последовательности. Ключ /s,стоящий в конце формата, указывает, что процесс изменения атрибутов файла (файлов) распространяется не только на текущий каталог, но и на все каталоги, подчиненные текущему.
1) команда Attrib +A +H +R primer.txt
присваивает файлу сразу три атрибута:”только для чтения”,”архивный” и ”скрытый” файлу primer.txt.
2) команда Attrib -R a:*.* /s
с использованием шаблона снимает атрибут ”только для чтения” у всех файлов диска А, то есть находящихся на дискете.
13. Команда del – команда удаления одного или нескольких файлов. Аналогом этой команды служит еще одна команда erase. Формат команд
del (erase) — диск:путь\имя_файла.расш
Особенностями выполнения команд служат следующие ситуации:
Если в команде не указан, то подразумевается, что удалению подлежит (подлежат) файл или файлы текущего каталога. В спецификации файла допускается использование групповых операций. Спецификация *.* обозначает, что удалению подлежат все файлы выбранного каталога.
Если в командах отсутствует спецификация файла, то командный процессор выдает предупреждение “Ошибка в синтаксисе команды”. Команды del не удаляют каталоги (подкаталоги). Они используются только для удаления в них файлов.
14. Команда rmdir (или rd) – команда удаления каталога. Формат команды
rmdir (rd) — диск:путь
Указываемый в команде путь каталог должен завершаться именем удаляемого каталога. Удаляемый каталог должен быть пустым. Нельзя удалить корневой каталог. Нельзя удалить текущий каталог, т. е. нельзя удалить каталог, находясь в нем.
Задание для самостоятельной работы
1. Изучите команду dir:
- Запомните (запишите) полный путь к Вашему текущему каталогу.
- Создайте дочерний каталог для своего текущего каталога.
- Используя команду dir, убедитесь в создании подкаталога.
- Сделайте дочерний каталог текущим, т.е. войдите в дочерний каталог.
- Подайте команду dir и объясните появившиеся сообщения.
- Выйдите сразу в корневой каталог.
- Вернитесь в исходный каталог.
2. Создайте текстовый файл с некоторым фрагментом текста.
- Выполните команду find с различными ключами и шаблонами поиска элементов этого текста.
- Оцените и объясните результаты поиска.
- Создайте несколько текстовых файлов с наличием в них одних и тех же элементов текста.
- Организуйте поиск элементов текста в группе файлов, используя шаблоны имен файлов (например, *.txt, s*.lst) и их перечисление.
3. Проверьте действие перечисленных конвейеров команд dir и find для собственного каталога, меняя режимы поиска и шаблоны. Оцените и объясните результаты поиска.
4. Создайте логический диск для одного из своих каталогов и убедиться, что механизм логических дисков упрощает работу пользователя.
5. С помощью команды set создайте текстовую (вые) переменную (ые) окружения и приведите примеры её (их) использования.
6. Создайте целочисленную переменную окружения и убедитесь в возможности использования ее при обработке данных.
7. Создайте небольшой текстовый файл, например f1.txt.
- Передайте его на принтер командой >copy f1.txt prn. Обратите внимание, каким шрифтом файл был распечатан.
- Измените значение параметра – размер шрифта на принтере следующей последовательностью команд:
- >copy con prn
- +O (установка уплотненного шрифта)
- +Z или F6 (завершение файла)
- Здесь +O заставляет принтер перейти на уплотненный шрифт, а следующая строка заканчивает файл (установку)
8. Создайте новый текстовый файл, используя команду edit ff.txt.
- Просмотрите рубрики меню встроенного редактора edit.
- Попробуйте средствами редактора создать несколько текстовых файлов, выполнить их редактирование и сохранение.
9. Самостоятельно изучите особенности применения и использования команд: sort, mode, more и др.
Лучшие практики bash-скриптов: краткое руководство по надежным и производительным скриптам bash
Shell wallpaper by manapi
Отладка сценариев bash — это как поиск иголки в стоге сена, тем более, когда новые дополнения появляются в существующей кодовой базе без своевременного рассмотрения вопросов структуры, логирования и надежности. В таких ситуациях можно оказаться как из-за собственных ошибок, так и при управлении сложными нагромождениями скриптов.
Команда Mail.ru Cloud Solutions перевела статью с рекомендациям, благодаря которым вы сможете лучше писать, отлаживать и поддерживать свои сценарии. Хотите верьте, хотите нет, но ничто не может сравниться с удовлетворением от написания чистого, готового к использованию bash-кода, который работает каждый раз.
В статье автор делится тем, что узнал за последние несколько лет, а также некоторыми распространенными ошибками, которые заставали его врасплох. Это важно, потому что каждый разработчик программного обеспечения в определенный момент своей карьеры работает со сценариями для автоматизации рутинных рабочих задач.
Обработчики ловушек
Большинство скриптов bash, с которыми я сталкивался, никогда не использовали эффективный механизм очистки, когда во время выполнения скрипта происходит что-то неожиданное.
Неожиданности могут возникнуть извне, например получение сигнала от ядра. Обработка таких случаев чрезвычайно важна для того, чтобы сценарии были достаточно надежными для запуска в продакшен-системах. Я часто использую обработчики выхода, чтобы реагировать на такие сценарии:
function handle_exit() < // Add cleanup code here // for eg. rm -f "/tmp/$.lock" // exit with an appropriate status code > // trap trap handle_exit 0 SIGHUP SIGINT SIGQUIT SIGABRT SIGTERMtrap — это встроенная команда оболочки, помогающая вам зарегистрировать функцию очистки, которая вызывается в случае каких-либо сигналов. Однако следует соблюдать особую осторожность с такими обработчиками, как SIGINT , который вызывает прерывание сценария.
Кроме того, в большинстве случаев следует ловить только EXIT , но идея в том, что вы действительно можете настроить поведение скрипта для каждого отдельного сигнала.
Встроенные функции set — быстрое завершение при ошибке
Очень важно реагировать на ошибки, как только они возникают, и быстро прекращать выполнение. Ничего не может быть хуже, чем продолжать выполнение команды вроде такой:
rm -rf $/*Обратите внимание, что переменная directory_name не определена.
Для обработки таких сценариев важно использовать встроенные функции set , такие как set -o errexit , set -o pipefail или set -o nounset в начале скрипта. Эти функции гарантируют, что ваш скрипт завершит работу, как только он встретит любой ненулевой код завершения, использование неопределенных переменных, неправильные команды, переданные по каналу и так далее:
#!/usr/bin/env bash set -o errexit set -o nounset set -o pipefail function print_var() < echo "$" > print_var $ ./sample.sh ./sample.sh: line 8: var_value: unbound variableПримечание: встроенные функции, такие как set -o errexit , выйдут из скрипта, как только появится «необработанный» код возврата (кроме нуля). Поэтому лучше ввести пользовательскую обработку ошибок, например:
#!/bin/bash error_exit() < line=$1 shift 1 echo "ERROR: non zero return code from line: $line -- $@" exit 1 >a=0 let a++ || error_exit "$LINENO" "let operation returned non 0 code" echo "you will never see me" # run it, now we have useful debugging output $ bash foo.sh ERROR: non zero return code from line: 9 -- let operation returned non 0 codeПодобное написание скриптов заставляет вас внимательнее относиться к поведению всех команд в скрипте и предусматривать возможность возникновения ошибки прежде, чем она застанет врасплох.
ShellCheck для выявления ошибок во время разработки
Стоит интегрировать что-то вроде ShellCheck в ваши конвейеры разработки и тестирования, чтобы проверять ваш код bash на применение лучших практик.
Я использую его в своих локальных средах разработки, чтобы получать отчеты о синтаксисе, семантике и некоторых ошибках в коде, которые я мог пропустить при разработке. Это инструмент статического анализа для ваших скриптов bash, и я настоятельно рекомендую его применять.
Использование своих exit-кодов
Коды возврата в POSIX — это не просто ноль или единица, а ноль или ненулевое значение. Используйте эти возможности для возврата пользовательских кодов ошибок (между 201-254) для различных случаев ошибок.
Эта информация может затем использоваться другими сценариями, которые обертывают ваш, чтобы точно понять, какой тип ошибки произошел, и реагировать соответствующим образом:
#!/usr/bin/env bash SUCCESS=0 FILE_NOT_FOUND=240 DOWNLOAD_FAILED=241 function read_file() < if $; then return $ fi >Примечание: пожалуйста, будьте особенно осторожны с именами переменных, которые вы определяете, чтобы не допустить случайного переопределения переменных среды.
Функции-логгеры
Красивое и структурированное ведение логов важно, чтобы легко понять результаты выполнения вашего скрипта. Как и в других языках программирования высокого уровня, я всегда использую в моих скриптах bash собственные функции логирования, такие как __msg_info , __msg_error и так далее.
Это помогает обеспечить стандартизированную структуру ведения логов, внося изменения только в одном месте:
#!/usr/bin/env bash function __msg_error() < [[ "$" == "1" ]] && echo -e "[ERROR]: $*" > function __msg_debug() < [[ "$" == "1" ]] && echo -e "[DEBUG]: $*" > function __msg_info() < [[ "$" == "1" ]] && echo -e "[INFO]: $*" > __msg_error "File could not be found. Cannot proceed" __msg_debug "Starting script execution with 276MB of available RAM"Я обычно стараюсь иметь в своих скриптах какой-то механизм __init , где такие переменные логгера и другие системные переменные инициализируются или устанавливаются в значения по умолчанию. Эти переменные также могут устанавливаться из параметров командной строки во время вызова скрипта.
Например, что-то вроде:
$ ./run-script.sh --debugКогда такой скрипт выполняется, в нем гарантировано, что общесистемные настройки установлены в значениях по умолчанию, если они обязательны, или, по крайней мере, инициализированы чем-то соответствующим, если это необходимо.
Я обычно основываю выбор, что инициализировать, а что нет, на компромиссе между пользовательским интерфейсом и деталями конфигураций, в которые пользователь может/должен вникнуть.
Архитектура для повторного использования и чистого состояния системы
Модульный / многоразовый код
├── framework │ ├── common │ │ ├── loggers.sh │ │ ├── mail_reports.sh │ │ └── slack_reports.sh │ └── daily_database_operation.shЯ держу отдельный репозиторий, который можно использовать для инициализации нового проекта/скрипта bash, который хочу разработать. Всё, что можно использовать повторно, может быть сохранено в репозитории и получено в других проектах, которые хотят использовать такие функциональные возможности. Такая организация проектов значительно уменьшает размер других скриптов, а также гарантирует, что кодовая база мала и легко тестируема.
Как и в приведенном выше примере, все функции ведения логов, такие как __msg_info , __msg_error и другие, например отчеты по Slack, содержатся отдельно в common/* и динамически подключаются в других сценариях, вроде daily_database_operation.sh .
Оставьте после себя чистую систему
Если вы загружаете какие-то ресурсы во время выполнения сценария, рекомендуется хранить все такие данные в общем каталоге со случайным именем, например /tmp/AlRhYbD97/* . Вы можете использовать генераторы случайного текста для выбора имени директории:
rand_dir_name="$(cat /dev/urandom | tr -dc 'a-zA-Z0-9' | fold -w 16 | head -n 1)"После завершения работы очистка таких каталогов может быть обеспечена в обработчиках ловушек, обсуждаемых выше. Если об удалении временных директорий не позаботиться, они накапливаются, и на каком-то этапе вызывают неожиданные проблемы на хосте, например заполненный диск.
Использование lock-файлов
Часто нужно обеспечить выполнение только одного экземпляра сценария на хосте в любой момент времени. Это можно сделать с помощью lock-файлов.
Я обычно создаю lock-файлы в /tmp/project_name/*.lock и проверяю их наличие в начале скрипта. Это помогает корректно завершить работу скрипта и избежать неожиданных изменений состояния системы другим сценарием, работающим параллельно. Lock-файлы не нужны, если вам необходимо, чтобы один и тот же скрипт выполнялся параллельно на данном хосте.
Измерить и улучшить
Нам часто приходится работать со сценариями, которые выполняются в течение длительного периода времени, например ежедневными операциями с базами данных. Такие операции обычно включают в себя последовательность шагов: загрузка данных, проверка на наличие аномалий, импорт данных, отправка отчетов о состоянии и так далее.
В таких случаях я всегда стараюсь разбивать сценарий на отдельные маленькие скрипты и сообщать об их состоянии и времени выполнения с помощью:
time source "$" "$">> "$/RUN_LOG" 2>&1Позже я могу посмотреть время выполнения с помощью:
tac "$/RUN_LOG.txt" | grep -m1 "real"Это помогает мне определить проблемные/медленные области в скриптах, которые нуждаются в оптимизации.
Что еще почитать:
- Go и кеши GPU.
- Как работает bash: разбираемся в деталях.
- Наш телеграм-канал о цифровой трансформации.
Что такое переменные среды Windows
Операционные системы и Windows не исключение имеют в своем составе особый механизм хранения различной информации, называемый переменными. Кто знаком с программированием прекрасно понимает, что это. Остальные могут представить себе это в виде записи имя_переменной=значение переменной среды. Например, запись username=Vasya означает, что переменная с именем username содержит значение Vasya.
При этом подразумевается, что имя переменной неизменно, а значение может изменяться с течением времени. Представим себе, что в переменной username хранится имя текущего пользователя Windows. Когда мы вошли в систему под именем Vasya, то в username оказалось соответствующее значение, однако если мы сменим пользователя на Ivan, то и значение изменится и username будет равно Ivan. Из-за этой возможности изменяться их и называют переменными.
Они оказываются чрезвычайно полезными при создании скриптов, работе в командной строке и адресной строке Проводника. В основном они содержат информацию из разряда имя компьютера, имя пользователя, домашняя папка пользователя, каталог куда установлена ОС, архитектура процессора, папки для временных файлов и так далее.
Таким образом эта информация дает представление о текущем окружении, то есть описывает среду, в которой происходит выполнение программы, отсюда и получили свое название переменные среды (environment variables) или по-другому переменные окружения.
В чем их практический смысл? Представьте себе, что вы создаете командный файл, в котором используется путь к домашней папке пользователя, причем он должен работать на любом компьютере. Как его прописать, если имя учетной записи заранее не известно, да и расположение папки тоже? Конечно, его можно выяснить в недрах ОС, но гораздо проще и компактней просто написать %USERPROFILE%. Система сама заботится о правильном значении, поэтому в таком варианте скрипт будет корректно работать везде.
Вот другой пример. Если в адресную строку Проводника ввести %localappdata% и нажать Enter , то произойдет переход в папку, которую установленные программы используют для хранения своих локальных данных. Обычно это C:\Users\имя текущей учетной записи\AppData\Local в которую можно конечно перейти обычным способом, но учитывая, что AppData является скрытой, то данный способ может оказаться быстрее и проще. К тому же можно создавать собственные переменные среды на нужные папки.
Так же благодаря переменной path можно запускать программы без указания полных путей к исполняем файлам, что заметно упрощает использование компьютера.
Переменные среды Windows бывают нескольких видов:
- Системные переменные — работают в пределах всего компьютера, хранятся в реестре в разделе HKLM\SYSTEM\CurrentControlSet\Control\Session Manager\Environment
- Пользовательские переменные — действуют только для конкретной учетной записи и находятся в реестре по адресу HKCU\Environment
- Сессионные переменные — существуют только в пределах текущего сеанса окна командной строки.
Настройка переменных среды Windows
В операционной системе имеется заранее предопределенный набор переменных окружения Windows и можно создавать собственные. Для просмотра и управления ими можно воспользоваться графическим интерфейсом. В разных версиях Windows вид окон немного отличается, но принципиально все одинаково. Правда в Windows 10 управление реализовано более удобно, чем в 7 и более старых версиях.
Настройка переменных среды Windows в графическом интерфейсе
Чтобы иметь возможность просматривать и редактировать переменные окружения в Windows 10 нужно выполнить следующие действия.
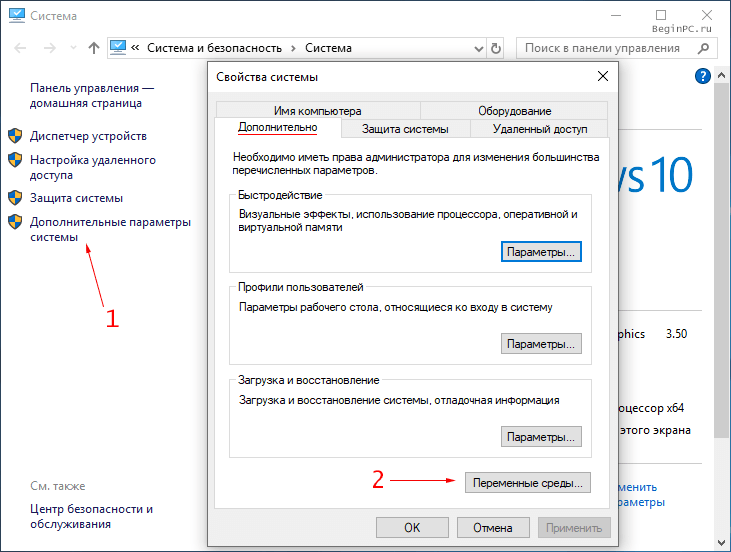
Щелкнуть правой кнопкой мыши по иконке «Этот компьютер» на рабочем столе и выбрать в меню «Свойства» или набрать в поиске на панели задач «Панель управления». Затем в левом столбце нажать на «Дополнительные параметры системы». В новом окне на вкладке «Дополнительно» есть кнопка «Переменные среды». Альтернативный вариант нажать комбинацию клавиш WIN + R и ввести systempropertiesadvanced .
Окно управления состоит из двух частей. В верхней представлены пользовательские переменные, а в нижней системные. Здесь можно просмотреть существующие, а также отредактировать, удалить или создать новые воспользовавшись соответствующими кнопками.
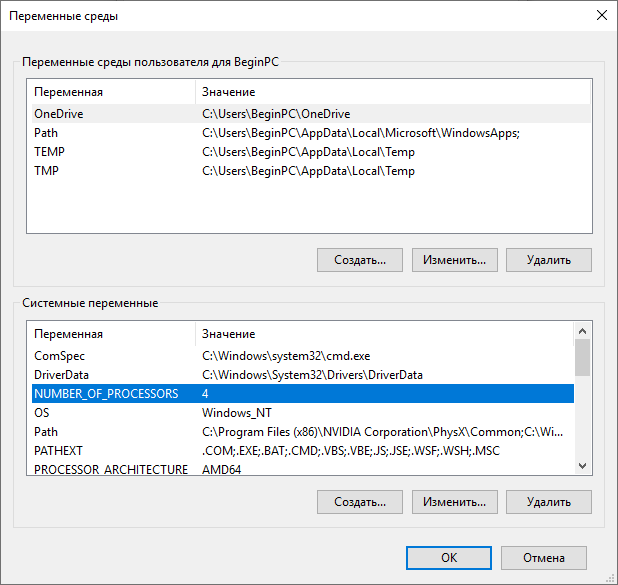
Чтобы создать переменную окружения нажимаем кнопку «Создать» в нужной части окна и вводим ее имя, значение и затем OK. Можно воспользоваться кнопкой «Обзор каталога» чтобы не вводить путь до нужной папки вручную.
Настройка переменных окружения Windows в командной строке
Конечно, есть альтернативный вариант настройки переменных окружения с помощью командной строки Windows. Чтобы cmd правильно понял, о чем идет речь ее нужно обернуть в символы процента вот так, %имя_переменной%. Соответственно, чтобы вывести на экран значение переменной среды команда будет такой: echo %имя_переменной% .
В Windows есть специальные команды, предназначенные для создания и редактирования переменных. Это set и setx принципиальная разница между которыми в том, что первая управляет ими только в текущем окне командной строки, а вторая изменяет их «навсегда» поскольку изменения сохраняются в реестре.
Для просмотра всех существующих переменных и их значений введите set без параметров.
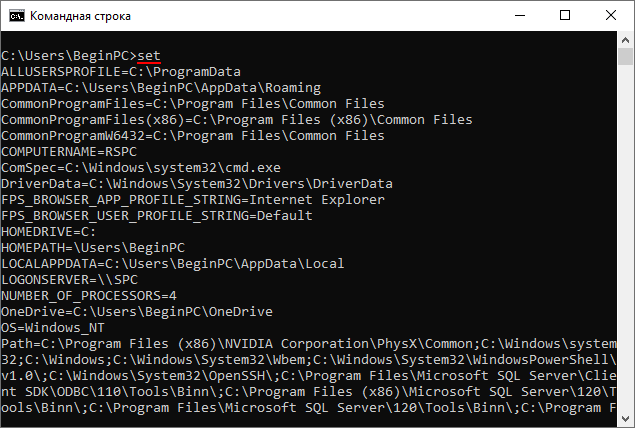
Тут есть важный момент, который нужно понять, переменные среды считываются в момент запуска программы. Поэтому изменения, сделанные в графическом интерфейсе или командой setx не действуют на уже запущенные программы. Их придется закрыть и запустить снова. В то же время команда set влияет только на текущее окно или дочерние процессы.
Чтобы создать пользовательскую переменную среды или отредактировать существующую общий вид команды следующий setx имя значение , использовать кавычки при наличии пробелов. Если переменной с таким именем не существует, то она будет создана, в противном случае значение будет изменено на новое. Для управления системными переменными нужно дополнить команду ключом /m и командная строка должна быть запущена с правами администратора компьютера setx mypc T-800 /m .
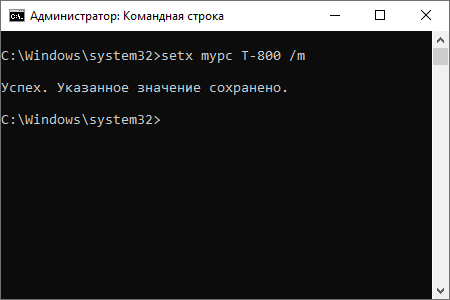
Впрочем, у setx имеется недостаток, с ее помощью нельзя удалить существующую переменную, максимум можно присвоить ей пустое значение setx mypc «» . Хотя при этом она как бы не существует для cmd, но фактически она продолжает оставаться в реестре. Полноценное удаление возможно непосредственно в реестре или с помощью команд, обеспечивающих работу с ним, а также в графическом интерфейсе.
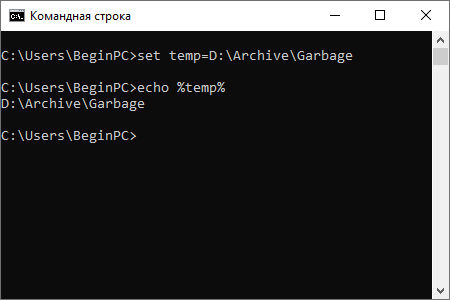
Для работы с сеансовыми переменными используется команда set. Синтаксис несколько отличается set имя=значение . Здесь уже используется знак равенства вместо пробела, при этом не допускается его наличие в имени. Таким образом изменить переменную окружения с именем temp в текущем окне CMD можно командой: set temp=D:\Archive\Garbage .
Использование переменных среды Windows сильно упрощает и ускоряет использование компьютера опытными пользователями. Каким способом их использовать каждый решает самостоятельно.
Поделиться понравившейся статьей: