Анализ данных с помощью pandas. Часть 0: введение, jupyter (ipython)

pandas — это Python библиотека для анализа и обработки данных. Она действительно быстрая и позволяет вам легко исследовать данные.
Цель этого цикла статей — дать конкретные примеры использования pandas.
Быстрый тур в IPython Notebook
Будет полезным повторить это в интерактивном режиме, поэтому лучше установить ipython с помощью pip:
sudo pip3 install jupyter pandas matplotlib После чего можно запустить сеанс ipython просто написав:
jupyter notebook После этого в браузере откроется сервер jupyter. Создадим Python 3 notebook.
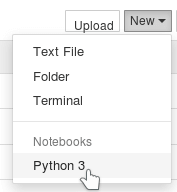
Во-первых, запустим код из ячейки.
Помимо этой кнопки, можно запускать код из ячейки с помощью Ctrl+Enter.
Одна из самых полезных вещей в IPython notebook это автодополнение.
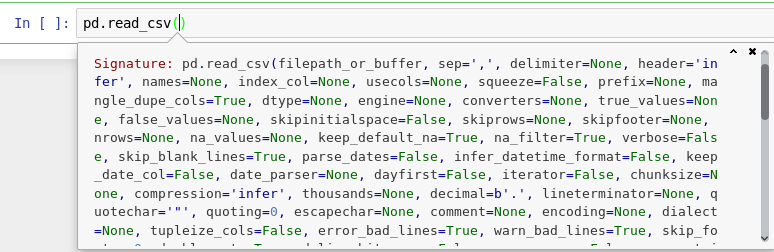
Попробуйте следующее: нажмите в ячейке сразу после read_csv( и нажмите Shift+Tab 4 раза, медленно. Посмотрите, что получится.
Вот что получается после 2 раз:
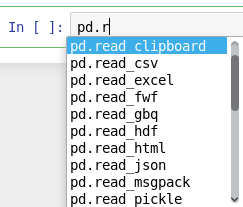
Хорошо, теперь попробуем автодополнение. Введите pd.r (первая буква функции) и посмотрите, какие варианты предлагаются.
Вы должны увидеть следующее:
Написание кода
Написание кода в ячейках абсолютно естественно.
Магические функции
IPython имеет множество магических функций. Далее идёт пример сравнения sum() с генератором списка и с помощью итератора, используя магическую функцию %time .
CPU times: user 20 ms, sys: 0 ns, total: 20 ms Wall time: 18.5 ms
4999950000
CPU times: user 8 ms, sys: 0 ns, total: 8 ms Wall time: 8.34 ms
4999950000
Для вставки кода на Python в комментарий заключайте его в теги
- Модуль csv - чтение и запись CSV файлов
- Создаём сайт на Django, используя хорошие практики. Часть 1: создаём проект
- Онлайн-обучение Python: сравнение популярных программ
- Книги о Python
- GUI (графический интерфейс пользователя)
- Курсы Python
- Модули
- Новости мира Python
- NumPy
- Обработка данных
- Основы программирования
- Примеры программ
- Типы данных в Python
- Видео
- Python для Web
- Работа для Python-программистов
- Сделай свой вклад в развитие сайта!
- Самоучитель Python
- Карта сайта
- Отзывы на книги по Python
- Реклама на сайте
Введение в библиотеку pandas: установка и первые шаги / pd 1
Библиотека pandas в Python — это идеальный инструмент для тех, кто занимается анализом данных, используя для этого язык программирования Python.
В этом материале речь сначала пойдет об основных аспектах библиотеки и о том, как установить ее в систему. Потом вы познакомитесь с двумя структурам данных: series и dataframes . Сможете поработать с базовым набором функций, предоставленных библиотекой pandas, для выполнения основных операций по обработке. Знакомство с ними — ключевой навык для специалиста в этой сфере. Поэтому так важно перечитать материал до тех, пока он не станет понятен на 100%.
А на примерах сможете разобраться с новыми концепциями, появившимися в библиотеке — индексацией структур данных. Научитесь правильно ее использовать для управления данными. В конце концов, разберетесь с тем, как расширить возможности индексации для работы с несколькими уровнями одновременно, используя для этого иерархическую индексацию.
Библиотека Python для анализа данных
Pandas — это библиотека Python с открытым исходным кодом для специализированного анализа данных. Сегодня все, кто использует Python для изучения статистических целей анализа и принятия решений, должны быть с ней знакомы.
Библиотека была спроектирована и разработана преимущественно Уэсом Маккини в 2008 году. В 2012 к нему присоединился коллега Чан Шэ. Вместе они создали одну из самых используемых библиотек в сообществе Python.
Pandas появилась из необходимости в простом инструменте для обработки, извлечения и управления данными.
Этот пакет Python спроектирован на основе библиотеки NumPy. Такой выбор обуславливает успех и быстрое распространение pandas. Он также пользуется всеми преимуществами NumPy и делает pandas совместимой с большинством другим модулей.
Еще одно важное решение — разработка специальных структур для анализа данных. Вместо того, чтобы использовать встроенные в Python или предоставляемые другими библиотеками структуры, были разработаны две новых.
Они спроектированы для работы с реляционными и классифицированными данными, что позволяет управлять данными способом, похожим на тот, что используется в реляционных базах SQL и таблицах Excel.
Дальше вы встретите примеры базовых операций для анализа данных, которые обычно используются на реляционных или таблицах Excel. Pandas предоставляет даже более расширенный набор функций и методов, позволяющих выполнять эти операции эффективнее.
Основная задача pandas — предоставить все строительные блоки для всех, кто погружается в мир анализа данных.
Установка pandas
Простейший способ установки библиотеки pandas — использование собранного решения, то есть установка через Anaconda или Enthought.
Установка в Anaconda
В Anaconda установка занимает пару минут. В первую очередь нужно проверить, не установлен ли уже pandas, и если да, то какая это версия. Для этого введите следующую команду в терминале:
conda list pandas Если модуль уже установлен (например в Windows), вы получите приблизительно следующий результат:
# packages in environment at C:\Users\Fabio\Anaconda: # pandas 0.20.3 py36hce827b7_2 Если pandas не установлена, ее необходимо установить. Введите следующую команду:
conda install pandas Anaconda тут же проверит все зависимости и установит дополнительные модули.
Solving environment: done ## Package Plan ## Environment location: C:\Users\Fabio\Anaconda3 added / updated specs: - pandas The following new packages will be installed: Pandas: 0.22.0-py36h6538335_0 Proceed ([y]/n)? Press the y key on your keyboard to continue the installation. Preparing transaction: done Verifying transaction: done Executing transaction: done Если требуется обновить пакет до более новой версии, используется эта интуитивная команда:
conda update pandas Система проверит версию pandas и версию всех модулей, а затем предложит соответствующие обновления. Затем предложит перейти к обновлению.
Установка из PyPI
Pandas можно установить и с помощью PyPI, используя эту команду:
pip install pandas Установка в Linux
Если вы работаете в дистрибутиве Linux и решили не использовать эти решения, то pandas можно установить как и любой другой пакет.
В Debian и Ubuntu используется команда:
sudo apt-get install python-pandas А для OpenSuse и Fedora — эта:
zypper in python-pandas Установка из источника
Если есть желание скомпилировать модуль pandas из исходного кода, тогда его можно найти на GitHub по ссылке https://github.com/pandas-dev/pandas:
git clone git://github.com/pydata/pandas.git cd pandas python setup.py install Убедитесь, что Cython установлен. Больше об этом способе можно прочесть в документации: (http://pandas.pydata.org/pandas-docs/stable/install.html).
Репозиторий для Windows
Если вы работаете в Windows и предпочитаете управлять пакетами так, чтобы всегда была установлена последняя версия, то существует ресурс, где всегда можно загрузить модули для Windows: Christoph Gohlke’s Python Extension Packages for Windows (www.lfd.uci.edu/~gohlke/pythonlibs/). Каждый модуль поставляется в формате WHL для 32 и 64-битных систем. Для установки нужно использовать приложение pip:
pip install SomePackage-1.0.whl Например, для установки pandas потребуется найти и загрузить следующий пакет:
pip install pandas-0.22.0-cp36-cp36m-win_amd64.whl При выборе модуля важно выбрать нужную версию Python и архитектуру. Более того, если для NumPy пакеты не требуются, то у pandas есть зависимости. Их также необходимо установить. Порядок установки не имеет значения.
Недостаток такого подхода в том, что нужно устанавливать пакеты отдельно без менеджера, который бы помог подобрать нужные версии и зависимости между разными пакетами. Плюс же в том, что появляется возможность освоиться с модулями и получить последние версии вне зависимости от того, что выберет дистрибутив.
Проверка установки pandas
Библиотека pandas может запустить проверку после установки для верификации управляющих элементов (документация утверждает, что тест покрывает 97% всего кода).
Во-первых, нужно убедиться, что установлен модуль nose . Если он имеется, то тестирование проводится с помощью следующей команды:
nosetests pandas Оно займет несколько минут и в конце покажет список проблем.
Модуль Nose
Этот модуль спроектирован для проверки кода Python во время этапов разработки проекта или модуля Python. Он расширяет возможности модуль unittest . Nose используется для проверки кода и упрощает процесс.
Здесь о нем можно почитать подробнее: _http://pythontesting.net/framework/nose/nose-introduction/.
Первые шаги с pandas
Лучший способ начать знакомство с pandas — открыть консоль Python и вводить команды одна за одной. Таким образом вы познакомитесь со всеми функциями и структурами данных.
Более того, данные и функции, определенные здесь, будут работать и в примерах будущих материалов. Однако в конце каждого примера вы вольны экспериментировать с ними.
Для начала откройте терминал Python и импортируйте библиотеку pandas. Стандартная практика для импорта модуля pandas следующая:
>>> import pandas as pd >>> import numpy as np Теперь, каждый раз встречая pd и np вы будете ссылаться на объект или метод, связанный с этими двумя библиотеками, хотя часто будет возникать желание импортировать модуль таким образом:
>>> from pandas import * В таком случае ссылаться на функцию, объект или метод с помощью pd уже не нужно, а это считается не очень хорошей практикой в среде разработчиков Python.
Моя шпаргалка по pandas
Один преподаватель как-то сказал мне, что если поискать аналог программиста в мире книг, то окажется, что программисты похожи не на учебники, а на оглавления учебников: они не помнят всего, но знают, как быстро найти то, что им нужно.
Возможность быстро находить описания функций позволяет программистам продуктивно работать, не теряя состояния потока. Поэтому я и создал представленную здесь шпаргалку по pandas и включил в неё то, чем пользуюсь каждый день, создавая веб-приложения и модели машинного обучения.
Нельзя сказать, что это — исчерпывающий список возможностей pandas , но сюда входят функции, которыми я пользуюсь чаще всего, примеры и мои пояснения по поводу ситуаций, в которых эти функции особенно полезны.
1. Подготовка к работе
Если вы хотите самостоятельно опробовать то, о чём тут пойдёт речь, загрузите набор данных Anime Recommendations Database с Kaggle. Распакуйте его и поместите в ту же папку, где находится ваш Jupyter Notebook (далее — блокнот).
Теперь выполните следующие команды.
import pandas as pd import numpy as np anime = pd.read_csv('anime-recommendations-database/anime.csv') rating = pd.read_csv('anime-recommendations-database/rating.csv') anime_modified = anime.set_index('name') После этого у вас должна появиться возможность воспроизвести то, что я покажу в следующих разделах этого материала.
2. Импорт данных
▍Загрузка CSV-данных
Здесь я хочу рассказать о преобразовании CSV-данных непосредственно в датафреймы (в объекты Dataframe). Иногда при загрузке данных формата CSV нужно указывать их кодировку (например, это может выглядеть как encoding='ISO-8859–1' ). Это — первое, что стоит попробовать сделать в том случае, если оказывается, что после загрузки данных датафрейм содержит нечитаемые символы.
anime = pd.read_csv('anime-recommendations-database/anime.csv') 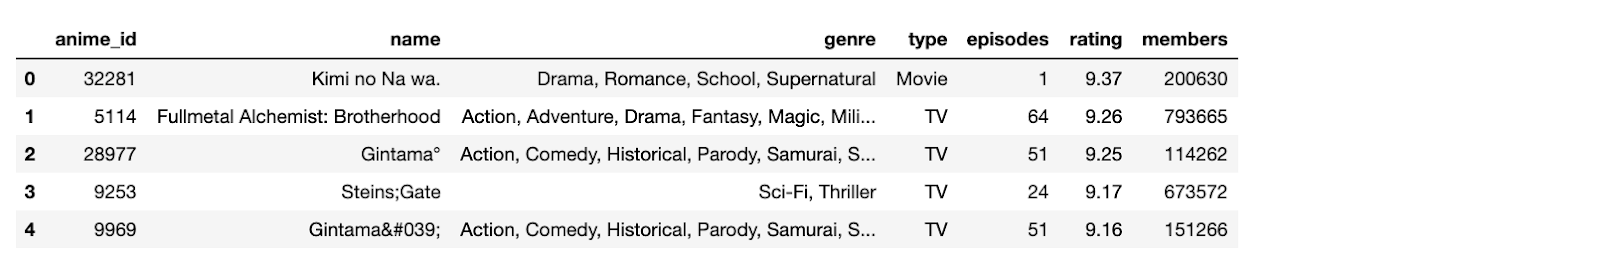
Загруженные CSV-данные
Существует похожая функция для загрузки данных из Excel-файлов — pd.read_excel .
▍Создание датафрейма из данных, введённых вручную
Это может пригодиться тогда, когда нужно вручную ввести в программу простые данные. Например — если нужно оценить изменения, претерпеваемые данными, проходящими через конвейер обработки данных.
df = pd.DataFrame([[1,'Bob', 'Builder'], [2,'Sally', 'Baker'], [3,'Scott', 'Candle Stick Maker']], columns=['id','name', 'occupation']) 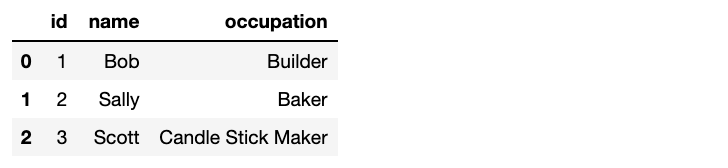
Данные, введённые вручную
▍Копирование датафрейма
Копирование датафреймов может пригодиться в ситуациях, когда требуется внести в данные изменения, но при этом надо и сохранить оригинал. Если датафреймы нужно копировать, то рекомендуется делать это сразу после их загрузки.
anime_copy = anime.copy(deep=True) 
Копия датафрейма
3. Экспорт данных
▍Экспорт в формат CSV
При экспорте данных они сохраняются в той же папке, где находится блокнот. Ниже показан пример сохранения первых 10 строк датафрейма, но то, что именно сохранять, зависит от конкретной задачи.
rating[:10].to_csv('saved_ratings.csv', index=False) Экспортировать данные в виде Excel-файлов можно с помощью функции df.to_excel .
4. Просмотр и исследование данных
▍Получение n записей из начала или конца датафрейма
Сначала поговорим о выводе первых n элементов датафрейма. Я часто вывожу некоторое количество элементов из начала датафрейма где-нибудь в блокноте. Это позволяет мне удобно обращаться к этим данным в том случае, если я забуду о том, что именно находится в датафрейме. Похожую роль играет и вывод нескольких последних элементов.
anime.head(3) rating.tail(1) 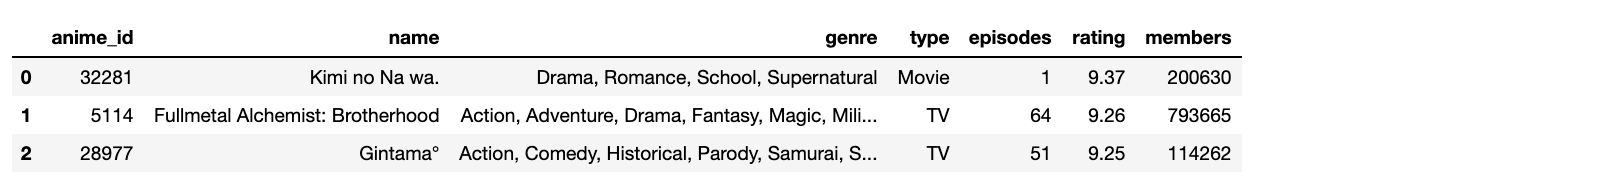
Данные из начала датафрейма

Данные из конца датафрейма
▍Подсчёт количества строк в датафрейме
Функция len(), которую я тут покажу, не входит в состав pandas . Но она хорошо подходит для подсчёта количества строк датафреймов. Результаты её работы можно сохранить в переменной и воспользоваться ими там, где они нужны.
len(df) #=> 3 ▍Подсчёт количества уникальных значений в столбце
Для подсчёта количества уникальных значений в столбце можно воспользоваться такой конструкцией:
len(ratings['user_id'].unique()) ▍Получение сведений о датафрейме
В сведения о датафрейме входит общая информация о нём вроде заголовка, количества значений, типов данных столбцов.
anime.info() 
Сведения о датафрейме
Есть ещё одна функция, похожая на df.info — df.dtypes . Она лишь выводит сведения о типах данных столбцов.
▍Вывод статистических сведений о датафрейме
Знание статистических сведений о датафрейме весьма полезно в ситуациях, когда он содержит множество числовых значений. Например, знание среднего, минимального и максимального значений столбца rating даёт нам некоторое понимание того, как, в целом, выглядит датафрейм. Вот соответствующая команда:
anime.describe() 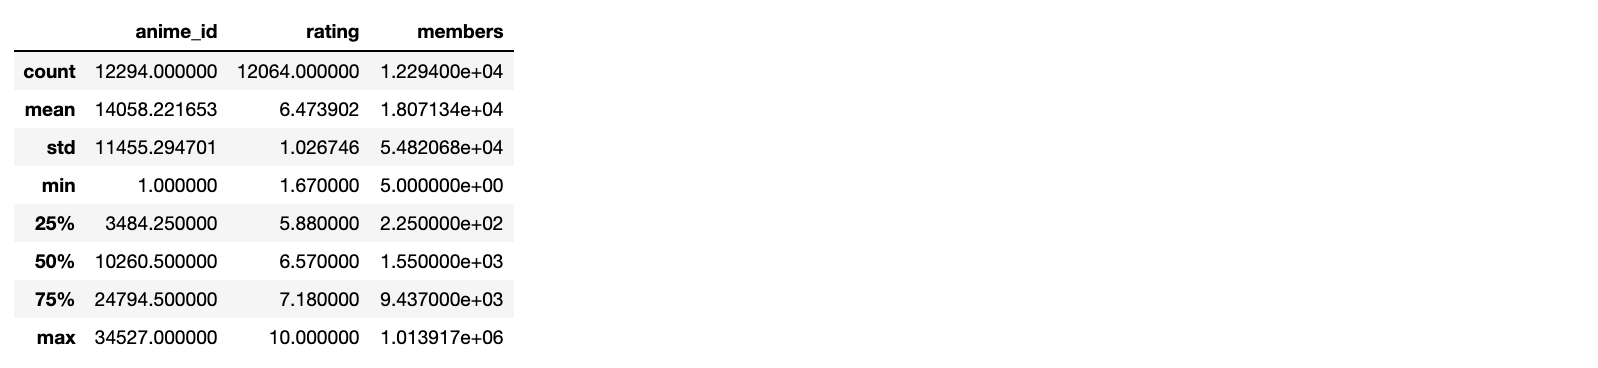
Статистические сведения о датафрейме
▍Подсчёт количества значений
Для того чтобы подсчитать количество значений в конкретном столбце, можно воспользоваться следующей конструкцией:
anime.type.value_counts() 
Подсчёт количества элементов в столбце
5. Извлечение информации из датафреймов
▍Создание списка или объекта Series на основе значений столбца
Это может пригодиться в тех случаях, когда требуется извлекать значения столбцов в переменные x и y для обучения модели. Здесь применимы следующие команды:
anime['genre'].tolist() anime['genre'] 
Результаты работы команды anime['genre'].tolist()

Результаты работы команды anime['genre']
▍Получение списка значений из индекса
Поговорим о получении списков значений из индекса. Обратите внимание на то, что я здесь использовал датафрейм anime_modified , так как его индексные значения выглядят интереснее.
anime_modified.index.tolist() 
Результаты выполнения команды
▍Получение списка значений столбцов
Вот команда, которая позволяет получить список значений столбцов:
anime.columns.tolist() 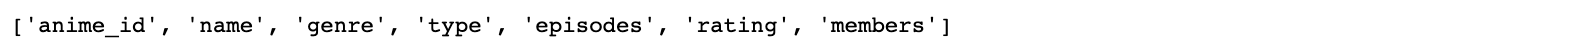
Результаты выполнения команды
6. Добавление данных в датафрейм и удаление их из него
▍Присоединение к датафрейму нового столбца с заданным значением
Иногда мне приходится добавлять в датафреймы новые столбцы. Например — в случаях, когда у меня есть тестовый и обучающий наборы в двух разных датафреймах, и мне, прежде чем их скомбинировать, нужно пометить их так, чтобы потом их можно было бы различить. Для этого используется такая конструкция:
anime['train set'] = True ▍Создание нового датафрейма из подмножества столбцов
Это может пригодиться в том случае, если требуется сохранить в новом датафрейме несколько столбцов огромного датафрейма, но при этом не хочется выписывать имена столбцов, которые нужно удалить.
anime[['name','episodes']] 
Результат выполнения команды
▍Удаление заданных столбцов
Этот приём может оказаться полезным в том случае, если из датафрейма нужно удалить лишь несколько столбцов. Если удалять нужно много столбцов, то эта задача может оказаться довольно-таки утомительной, поэтому тут я предпочитаю пользоваться возможностью, описанной в предыдущем разделе.
anime.drop(['anime_id', 'genre', 'members'], axis=1).head() 
Результаты выполнения команды
▍Добавление в датафрейм строки с суммой значений из других строк
Для демонстрации этого примера самостоятельно создадим небольшой датафрейм, с которым удобно работать. Самое интересное здесь — это конструкция df.sum(axis=0) , которая позволяет получать суммы значений из различных строк.
df = pd.DataFrame([[1,'Bob', 8000], [2,'Sally', 9000], [3,'Scott', 20]], columns=['id','name', 'power level']) df.append(df.sum(axis=0), ignore_index=True) 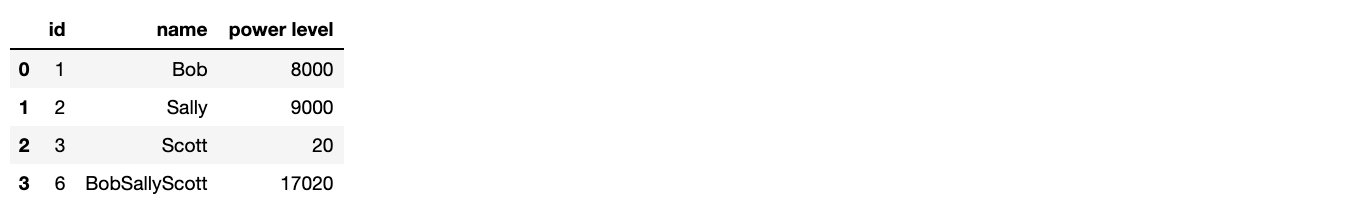
Результат выполнения команды
Команда вида df.sum(axis=1) позволяет суммировать значения в столбцах.
Похожий механизм применим и для расчёта средних значений. Например — df.mean(axis=0) .
7. Комбинирование датафреймов
▍Конкатенация двух датафреймов
Эта методика применима в ситуациях, когда имеются два датафрейма с одинаковыми столбцами, которые нужно скомбинировать.
В данном примере мы сначала разделяем датафрейм на две части, а потом снова объединяем эти части:
df1 = anime[0:2] df2 = anime[2:4] pd.concat([df1, df2], ignore_index=True) 
Датафрейм df1

Датафрейм df2

Датафрейм, объединяющий df1 и df2
▍Слияние датафреймов
Функция df.merge , которую мы тут рассмотрим, похожа на левое соединение SQL. Она применяется тогда, когда два датафрейма нужно объединить по некоему столбцу.
rating.merge(anime, left_on=’anime_id’, right_on=’anime_id’, suffixes=(‘_left’, ‘_right’)) 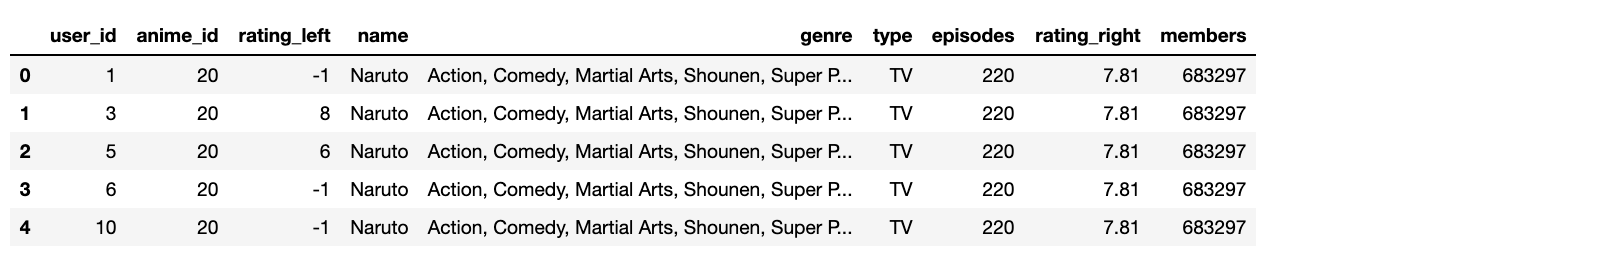
Результаты выполнения команды
8. Фильтрация
▍Получение строк с нужными индексными значениями
Индексными значениями датафрейма anime_modified являются названия аниме. Обратите внимание на то, как мы используем эти названия для выбора конкретных столбцов.
anime_modified.loc[['Haikyuu!! Second Season','Gintama']] 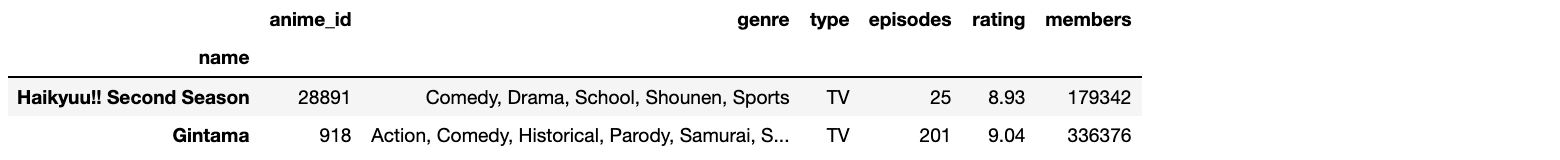
Результаты выполнения команды
▍Получение строк по числовым индексам
Эта методика отличается от той, которая описана в предыдущем разделе. При использовании функции df.iloc первой строке назначается индекс 0 , второй — индекс 1 , и так далее. Такие индексы назначаются строкам даже в том случае, если датафрейм был модифицирован и в его индексном столбце используются строковые значения.
Следующая конструкция позволяет выбрать три первых строки датафрейма:
anime_modified.iloc[0:3] 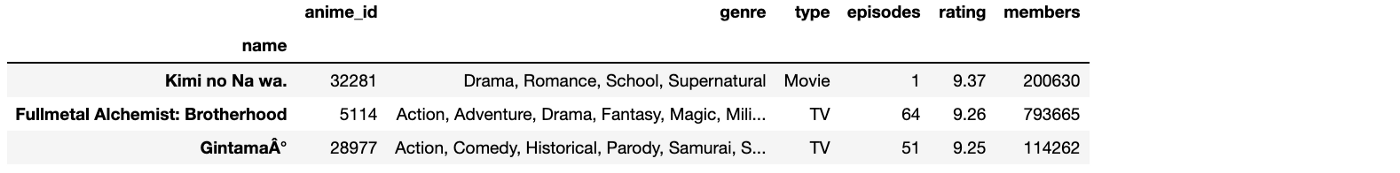
Результаты выполнения команды
▍Получение строк по заданным значениям столбцов
Для получения строк датафрейма в ситуации, когда имеется список значений столбцов, можно воспользоваться следующей командой:
anime[anime['type'].isin(['TV', 'Movie'])] 
Результаты выполнения команды
Если нас интересует единственное значение — можно воспользоваться такой конструкцией:
anime[anime[‘type’] == 'TV'] ▍Получение среза датафрейма
Эта техника напоминает получение среза списка. А именно, речь идёт о получении фрагмента датафрейма, содержащего строки, соответствующие заданной конфигурации индексов.
anime[1:3] 
Результаты выполнения команды
▍Фильтрация по значению
Из датафреймов можно выбирать строки, соответствующие заданному условию. Обратите внимание на то, что при использовании этого метода сохраняются существующие индексные значения.
anime[anime['rating'] > 8] 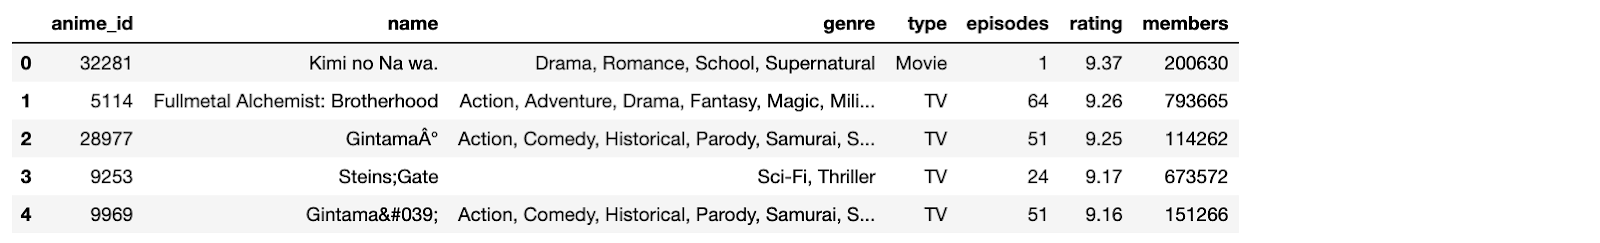
Результаты выполнения команды
9. Сортировка
Для сортировки датафреймов по значениям столбцов можно воспользоваться функцией df.sort_values :
anime.sort_values('rating', ascending=False) 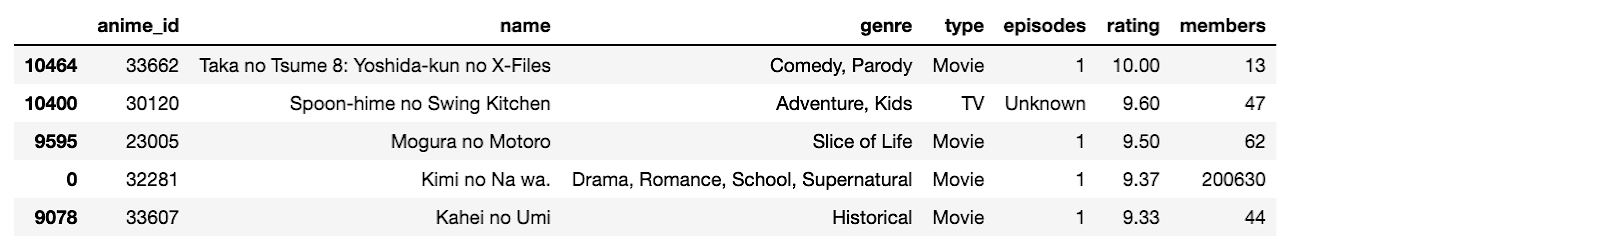
Результаты выполнения команды
10. Агрегирование
▍Функция df.groupby и подсчёт количества записей
Вот как подсчитать количество записей с различными значениями в столбцах:
anime.groupby('type').count() 
Результаты выполнения команды
▍Функция df.groupby и агрегирование столбцов различными способами
Обратите внимание на то, что здесь используется reset_index() . В противном случае столбец type становится индексным столбцом. В большинстве случаев я рекомендую делать то же самое.
anime.groupby(["type"]).agg(< "rating": "sum", "episodes": "count", "name": "last" >).reset_index() ▍Создание сводной таблицы
Для того чтобы извлечь из датафрейма некие данные, нет ничего лучше, чем сводная таблица. Обратите внимание на то, что здесь я серьёзно отфильтровал датафрейм, что ускорило создание сводной таблицы.
tmp_df = rating.copy() tmp_df.sort_values('user_id', ascending=True, inplace=True) tmp_df = tmp_df[tmp_df.user_id < 10] tmp_df = tmp_df[tmp_df.anime_id < 30] tmp_df = tmp_df[tmp_df.rating != -1] pd.pivot_table(tmp_df, values='rating', index=['user_id'], columns=['anime_id'], aggfunc=np.sum, fill_value=0) 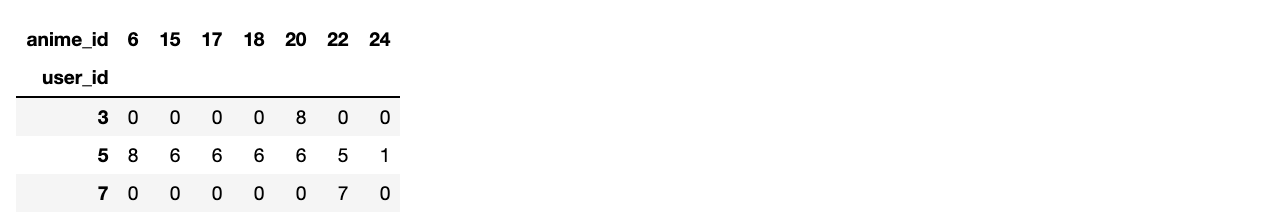
Результаты выполнения команды
11. Очистка данных
▍Запись в ячейки, содержащие значение NaN, какого-то другого значения
Здесь мы поговорим о записи значения 0 в ячейки, содержащие значение NaN . В этом примере мы создаём такую же сводную таблицу, как и ранее, но без использования fill_value=0 . А затем используем функцию fillna(0) для замены значений NaN на 0 .
pivot = pd.pivot_table(tmp_df, values='rating', index=['user_id'], columns=['anime_id'], aggfunc=np.sum) pivot.fillna(0) 
Таблица, содержащая значения NaN
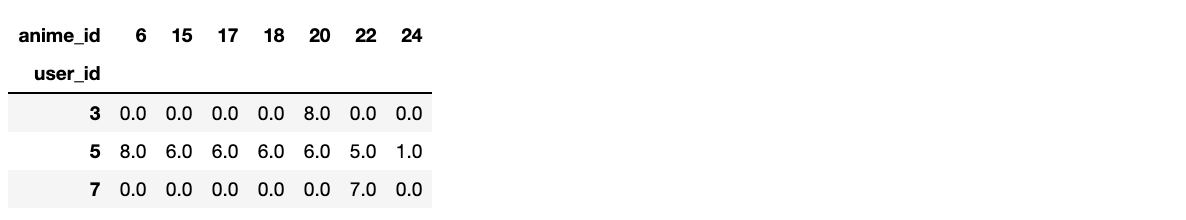
Результаты замены значений NaN на 0
12. Другие полезные возможности
▍Отбор случайных образцов из набора данных
Я использую функцию df.sample каждый раз, когда мне нужно получить небольшой случайный набор строк из большого датафрейма. Если используется параметр frac=1 , то функция позволяет получить аналог исходного датафрейма, строки которого будут перемешаны.
anime.sample(frac=0.25) 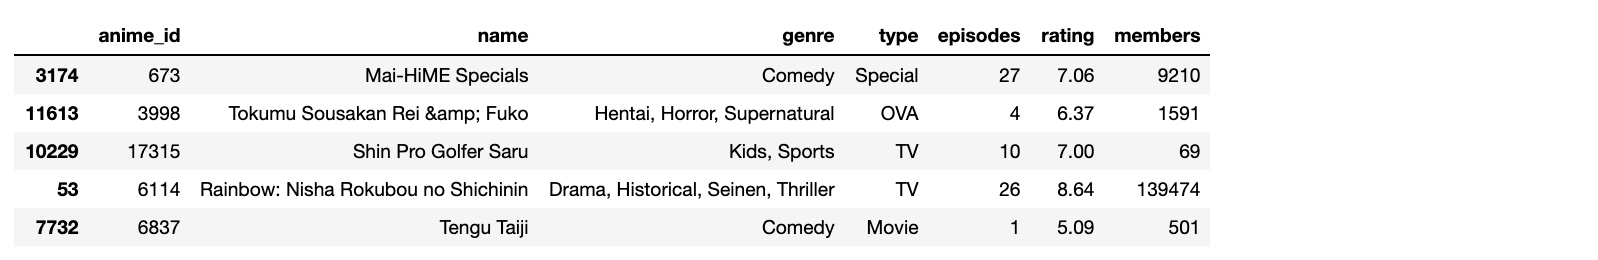
Результаты выполнения команды
▍Перебор строк датафрейма
Следующая конструкция позволяет перебирать строки датафрейма:
for idx,row in anime[:2].iterrows(): print(idx, row) 
Результаты выполнения команды
▍Борьба с ошибкой IOPub data rate exceeded
Если вы сталкиваетесь с ошибкой IOPub data rate exceeded — попробуйте, при запуске Jupyter Notebook, воспользоваться следующей командой:
jupyter notebook — NotebookApp.iopub_data_rate_limit=1.0e10 Итоги
Здесь я рассказал о некоторых полезных приёмах использования pandas в среде Jupyter Notebook. Надеюсь, моя шпаргалка вам пригодится.
Уважаемые читатели! Есть ли какие-нибудь возможности pandas , без которых вы не представляете своей повседневной работы?

- Блог компании RUVDS.com
- Веб-разработка
- Python
Работаем с Pandas: основные понятия и реальные данные
Разбираемся в том, как работает библиотека Pandas и проводим первый анализ данных.

Иллюстрация: Катя Павловская для Skillbox Media
Антон Яценко
Изучает Python, его библиотеки и занимается анализом данных. Любит путешествовать в горах.
Python используют для анализа данных и машинного обучения, подключая к нему различные библиотеки: Pandas, Matplotlib, NumPy, TensorFlow и другие. Каждая из них используется для решения конкретных задач.
Сегодня мы поговорим про Pandas: узнаем, для чего нужна эта библиотека, как импортировать её в Python, а также проанализируем свой первый датасет и выясним, в какой стране самый быстрый и самый медленный интернет.
Для чего нужна библиотека Pandas в Python
Pandas — главная библиотека в Python для работы с данными. Её активно используют аналитики данных и дата-сайентисты. Библиотека была создана в 2008 году компанией AQR Capital, а в 2009 году она стала проектом с открытым исходным кодом с поддержкой большого комьюнити.
Вот для каких задач используют библиотеку:
Аналитика данных: продуктовая, маркетинговая и другая. Работа с любыми данными требует анализа и подготовки: необходимо удалить или заполнить пропуски, отфильтровать, отсортировать или каким-то образом изменить данные. Pandas в Python позволяет быстро выполнить все эти действия, а в большинстве случаев ещё и автоматизировать их.
Data science и работа с большими данными. Pandas помогает подготовить и провести первичный анализ данных, чтобы потом использовать их в машинном или глубоком обучении.
Статистика. Библиотека поддерживает основные статистические методы, которые необходимы для работы с данными. Например, расчёт средних значений, их распределения по квантилям и другие.
Работа с Pandas
Для анализа данных и машинного обучения обычно используются особые инструменты: Google Colab или Jupyter Notebook. Это специализированные IDE, позволяющие работать с данными пошагово и итеративно, без необходимости создавать полноценное приложение.
В этой статье мы посмотрим на Google Colab, облачное решение для работы с данными, которое можно запустить в браузере на любом устройстве: десктопе, ноутбуке, планшете или даже смартфоне.
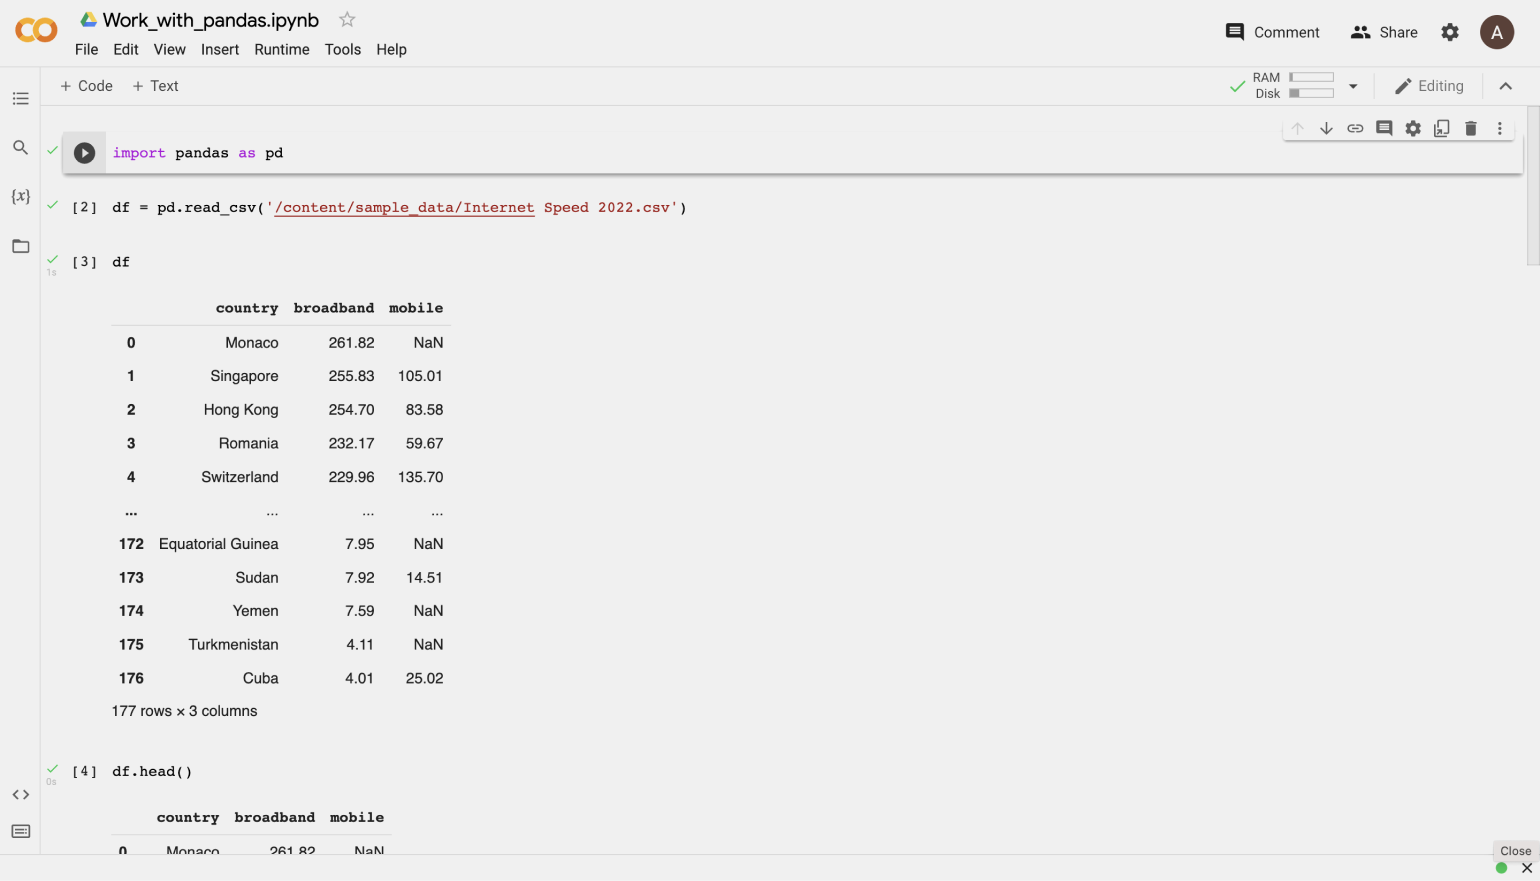
Каждая строчка кода на скриншоте — это одно действие, результат которого Google Colab и Jupyter Notebook сразу демонстрируют пользователю. Это удобно в задачах, связанных с аналитикой и data science.
Устанавливать Pandas при работе с Jupyter Notebook или Colab не требуется. Это стандартная библиотека, которая уже будет доступна сразу после их запуска. Останется только импортировать её в ваш код.
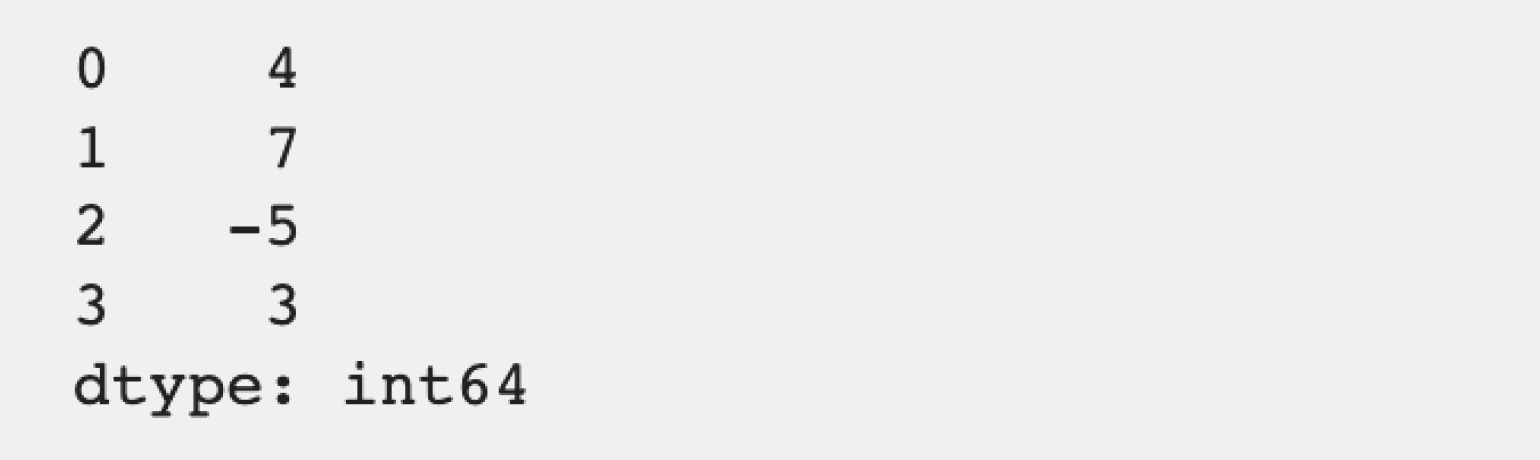
Series отображается в виде таблицы с индексами элементов в первом столбце и значениями во втором.
DataFrame — основной тип данных в Pandas, вокруг которого строится вся работа. Его можно представить в виде обычной таблицы с любым количеством столбцов и строк. Внутри ячеек такой «таблицы» могут быть данные самого разного типа: числовые, булевы, строковые и так далее.
У DataFrame есть и индексы строк, и индексы столбцов. Это позволяет удобно сортировать и фильтровать данные, а также быстро находить нужные ячейки.
Создадим простой DataFrame с помощью словаря и посмотрим на его отображение:
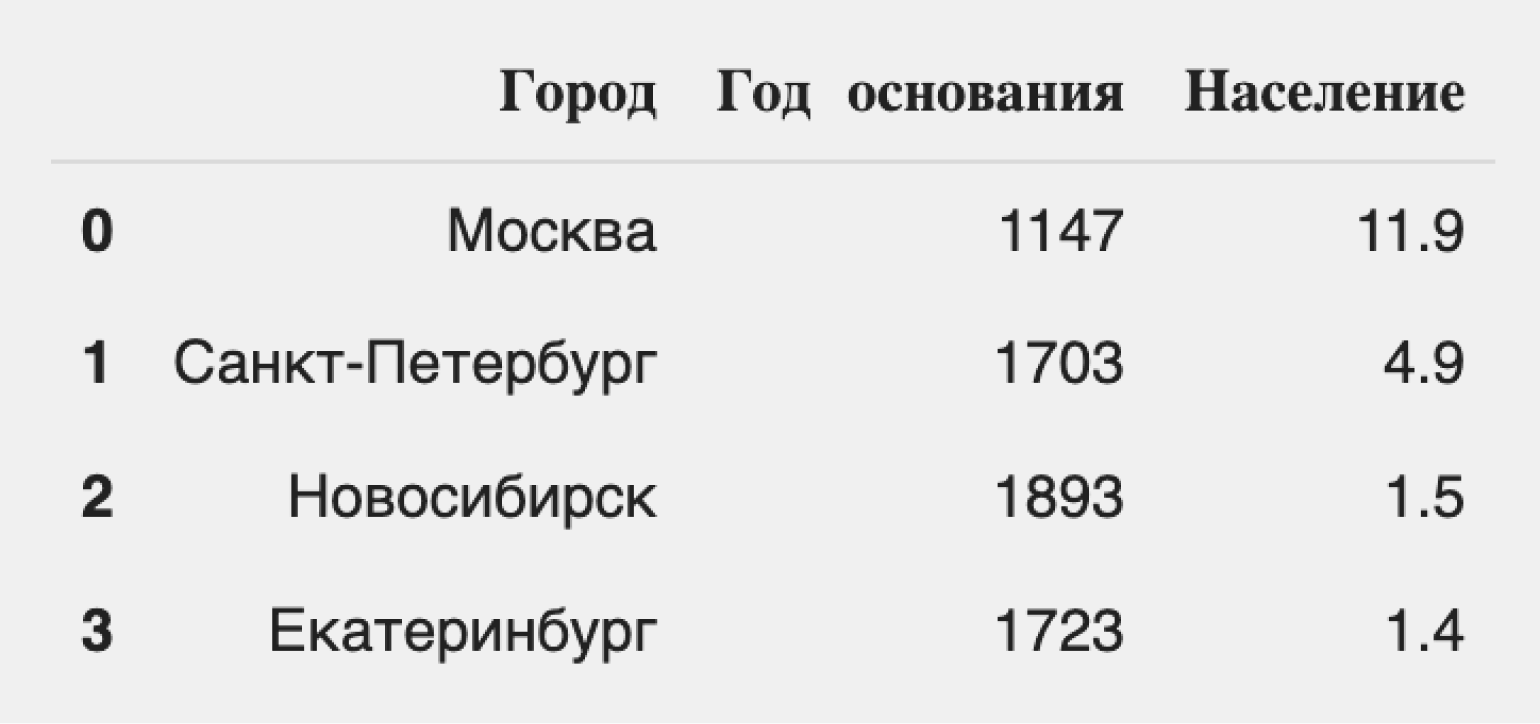
Мы видим таблицу, строки которой имеют индексы от 0 до 3, а «индексы» столбцов соответствуют их названиям. Легко заметить, что DataFrame состоит из трёх Series: «Город», «Год основания» и «Население». Оба типа индексов можно использовать для навигации по данным.
Импорт данных
Pandas позволяет импортировать данные разными способами. Например, прочесть их из словаря, списка или кортежа. Самый популярный способ — это работа с файлами .csv, которые часто применяются в анализе данных. Для импорта используют команду pd.read_csv().
read_csv имеет несколько параметров для управления импортом:
- sep — позволяет явно указать разделитель, который используется в импортируемом файле. По умолчанию значение равно ,, что соответствует разделителю данных в файлах формата .csv. Этот параметр полезен при нестандартных разделителях в исходном файле, например табуляции или точки с запятой;
- dtype — позволяет явно указать на тип данных в столбцах. Полезно в тех случаях, когда формат данных автоматически определился неверно. Например, даты часто импортируются в виде строковых переменных, хотя для них существует отдельный тип.
Подробно параметры, позволяющие настроить импорт, описаны в документации.
Давайте импортируем датасет с информацией о скорости мобильного и стационарного интернета в отдельных странах. Готовый датасет скачиваем с Kaggle. Параметры для read_csv не указываем, так как наши данные уже подготовлены для анализа.
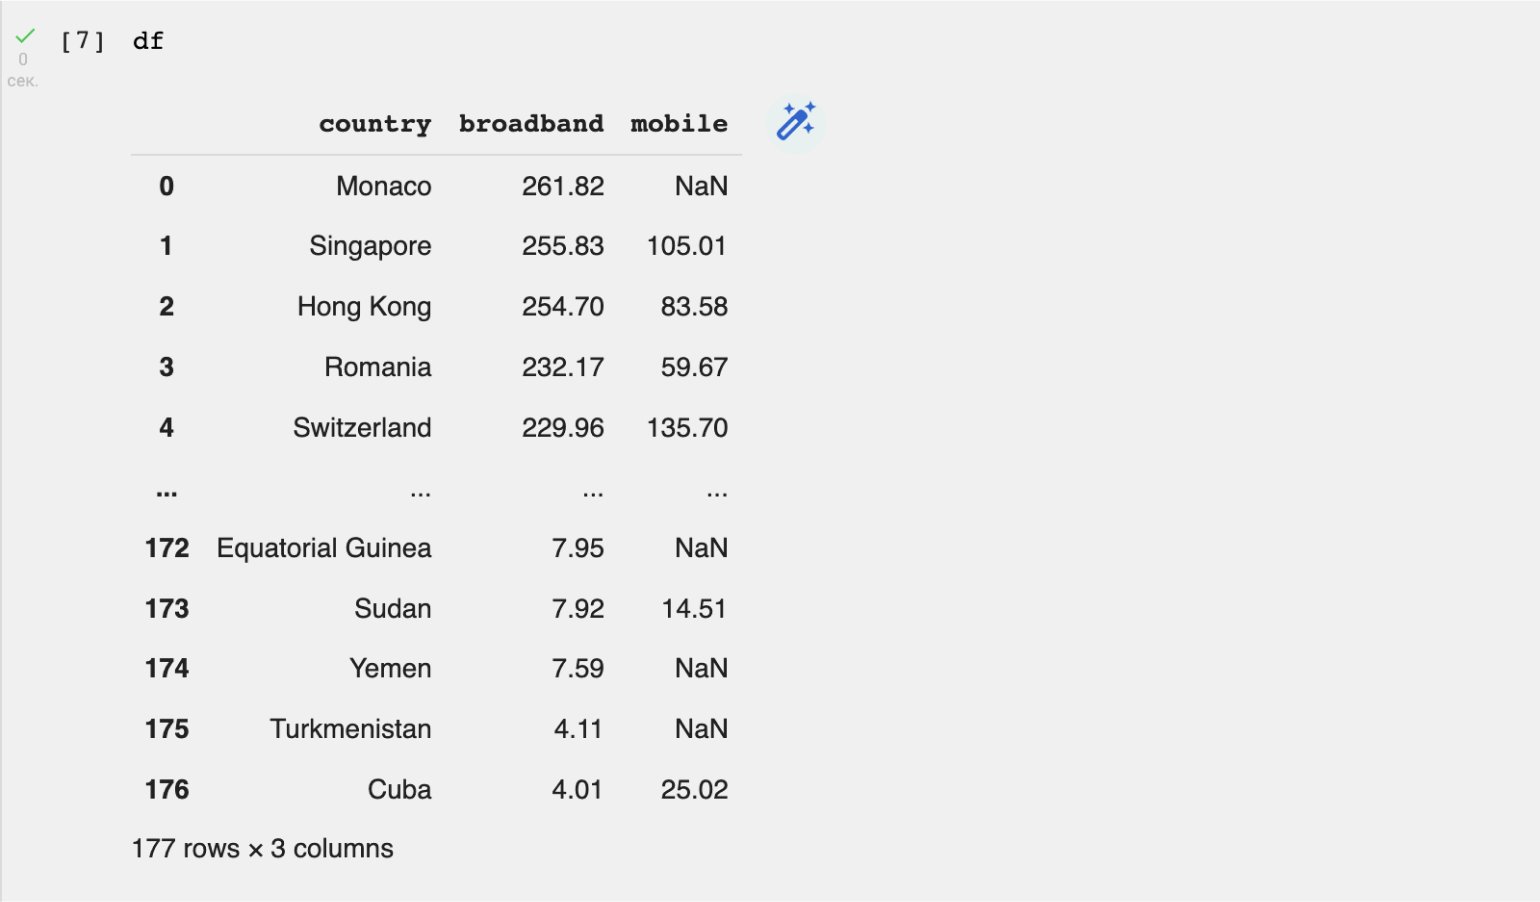
В верхней части таблицы мы видим названия столбцов: country (страна), broadband (средняя скорость интернета) и mobile (средняя скорость мобильного интернета). Слева указаны индексы — от 0 до 176. То есть всего у нас 177 строк. В нижней части таблицы Pandas отображает и эту информацию.
Выводить таблицу полностью необязательно. Для первого знакомства с данными достаточно показать пять первых или пять последних строк. Сделать это можно с помощью df.head() или df.tail() соответственно. В скобках можно указать число строк, которое требуется указать. По умолчанию параметр равен 5.
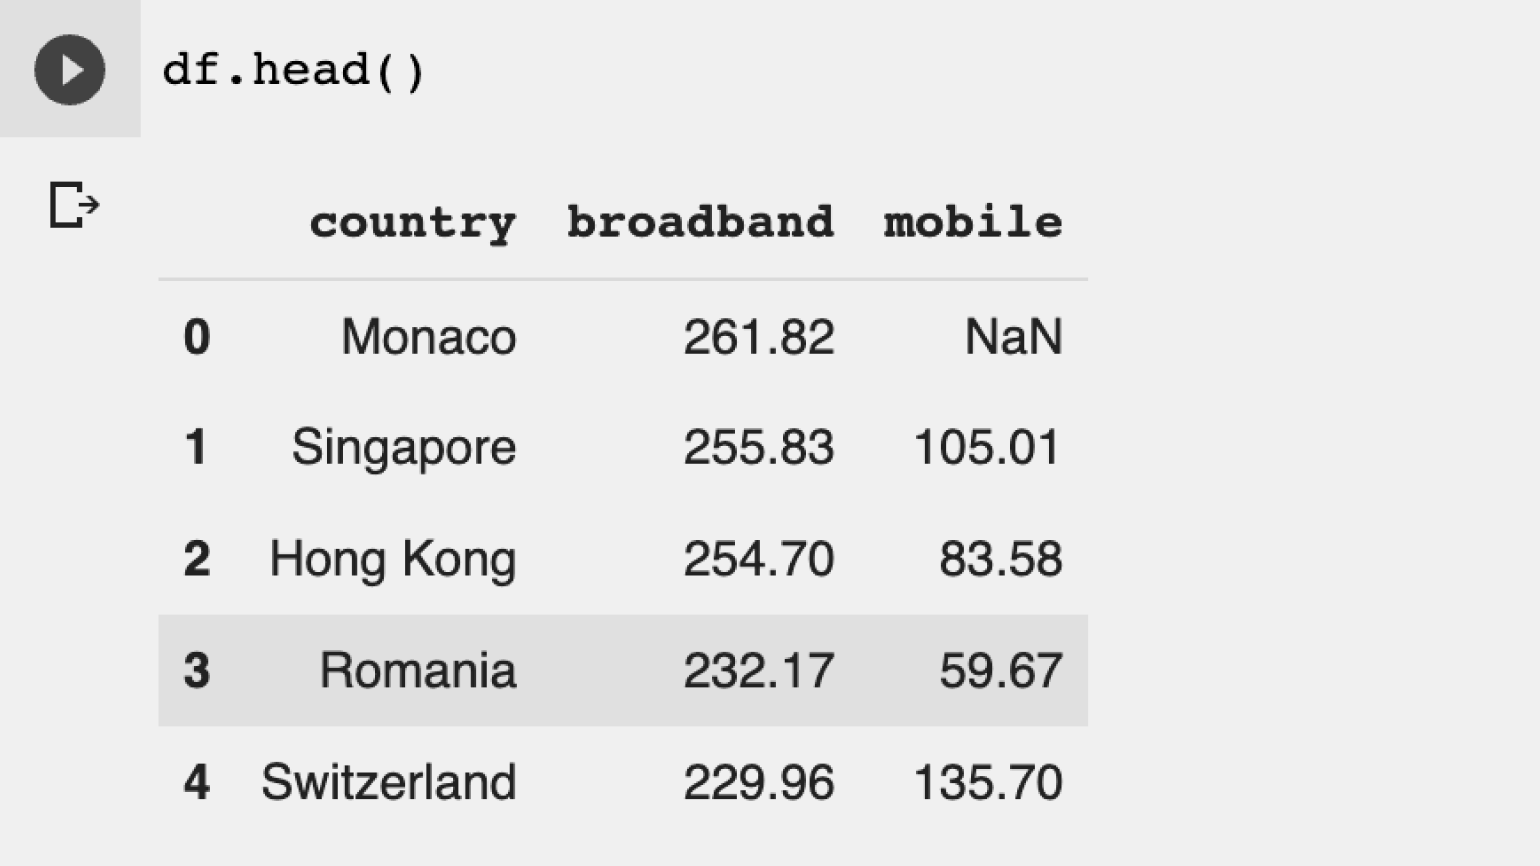
Так намного удобнее. Мы можем сразу увидеть названия столбцов и тип данных в столбцах. Также в некоторых ячейках мы видим значение NaN — к нему мы вернёмся позже.
Изучаем данные и описываем их
Теперь нам надо изучить импортированные данные. Действовать будем пошагово.
Шаг 1. Проверяем тип данных в таблице. Это поможет понять, в каком виде представлена информация в датасете — а иногда и найти аномалии. Например, даты могут быть сохранены в виде строк, что неудобно для последующего анализа. Проверить это можно с помощью стандартного метода:
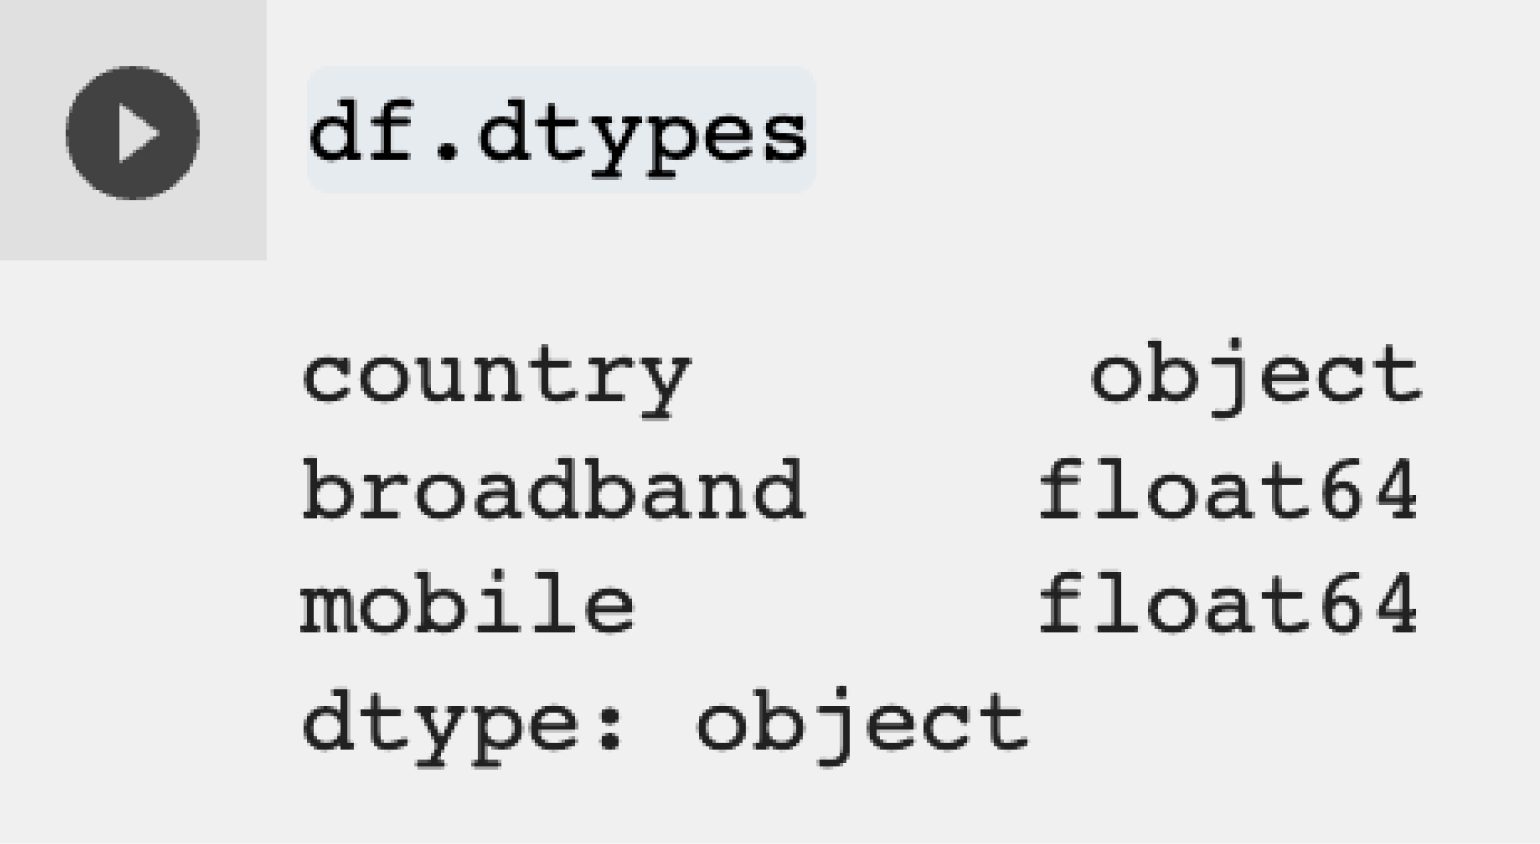
- столбец country представляет собой тип object. Это тип данных для строковых и смешанных значений;
- столбцы broadband и mobile имеют тип данных float, то есть относятся к числам с плавающей точкой.
Шаг 2. Быстро оцениваем данные и делаем предварительные выводы. Сделать это можно очень просто: для этого в Pandas существует специальный метод describe(). Он показывает среднее со стандартным отклонением, максимальные, минимальные значения переменных и их разделение по квантилям.
Посмотрим на этот метод в деле:
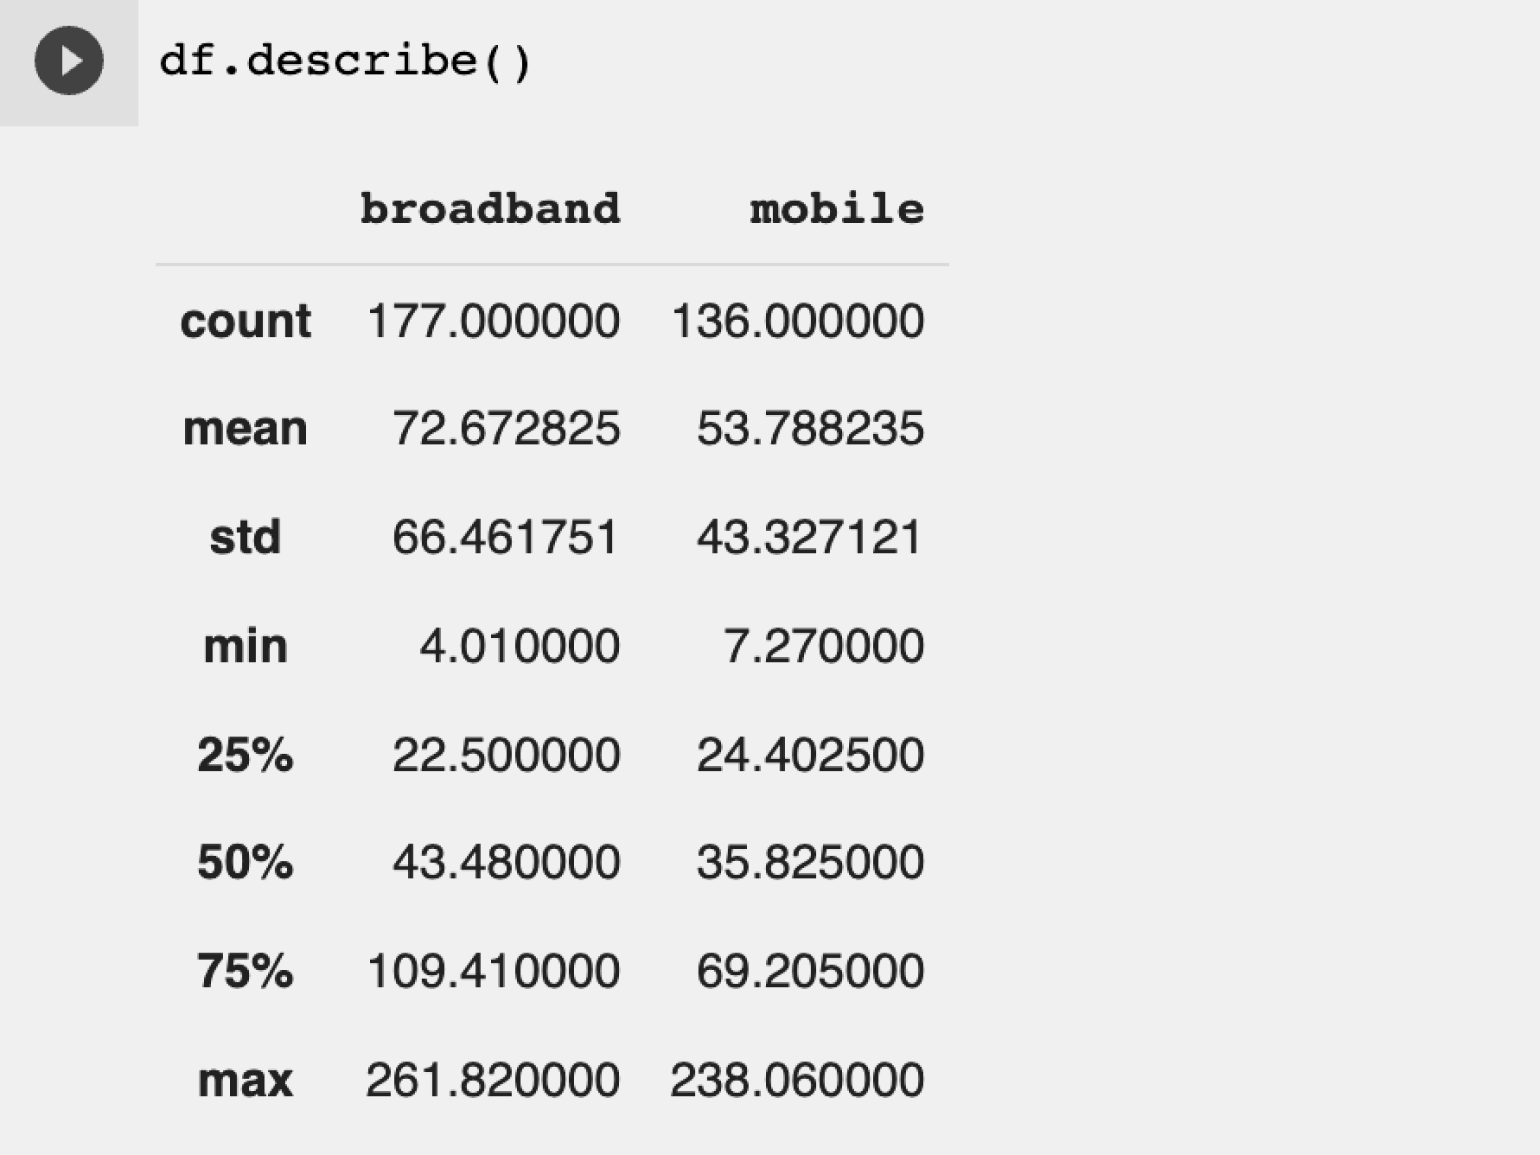
Пройдёмся по каждой строчке:
- count — это количество заполненных строк в каждом столбце. Мы видим, что в столбце с данными о скорости мобильного интернета есть пропуски.
- mean — среднее значение скорости обычного и мобильного интернета. Уже можно сделать вывод, что мобильный интернет в большинстве стран медленнее, чем кабельный.
- std — стандартное отклонение. Важный статистический показатель, показывающий разброс значений.
- min и max — минимальное и максимальное значение.
- 25%, 50% и 75% — значения скорости интернета по процентилям. Если не углубляться в статистику, то процентиль — это число, которое показывает распределение значений в выборке. Например, в выборке с мобильным интернетом процентиль 25% показывает, что 25% от всех значений скорости интернета меньше, чем 24,4.
Обратите внимание, что этот метод работает только для чисел. Информация для столбца с названиями стран отсутствует.
Какой вывод делаем? Проводной интернет в большинстве стран работает быстрее, чем мобильный. При этом скорость проводного интернета в 75% случаев не превышает 110 Мбит/сек, а мобильного — 69 Мбит/сек.
Шаг 3. Сортируем и фильтруем записи. В нашем датафрейме данные уже отсортированы от большего к меньшему по скорости проводного интернета. Попробуем найти страну с наилучшим мобильным интернетом. Для этого используем стандартный метод sort_values, который принимает два параметра:
- название столбца, по которому происходит сортировка, — обязательно должно быть заключено в одинарные или двойные кавычки;
- параметр ascending= — указывает на тип сортировки. Если мы хотим отсортировать значения от большего к меньшему, то параметру присваиваем False. Для сортировки от меньшего к большему используем True.
Перейдём к коду:
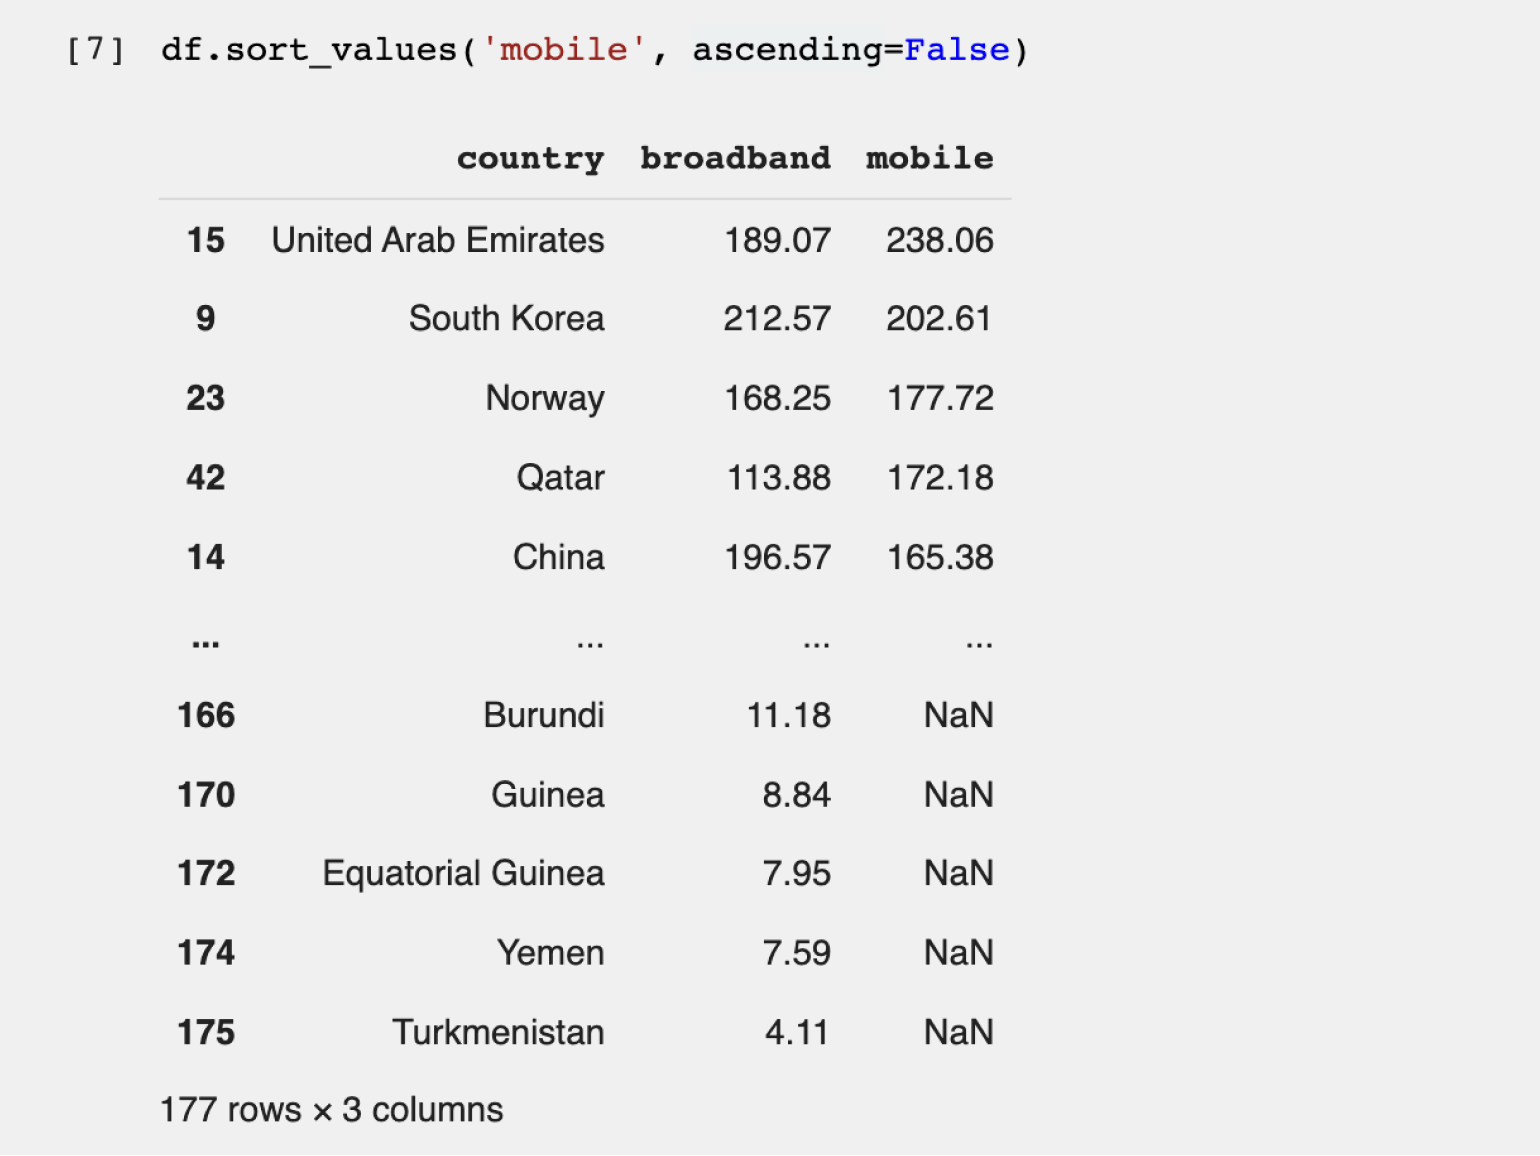
Теперь рейтинг стран другой — пятёрка лидеров поменялась (потому что мы отсортировали данные по другому значению). Мы выяснили, что самый быстрый мобильный интернет в ОАЭ.
Но есть нюанс. Если вернуться к первоначальной таблице, отсортированной по скорости проводного интернета, можно заметить, что у лидера — Монако — во втором столбце написано NaN. NaN в Python указывает на отсутствие данных. Поэтому мы не знаем скорость мобильного интернета в Монако из этого датасета и не можем сделать однозначный вывод о лидерах в мире мобильной связи.
Попробуем отфильтровать значения, убрав страны с неизвестной скоростью мобильного интернета, и посмотрим на худшие по показателю страны (если оставить NaN, он будет засорять «дно» таблицы и увидеть реальные значения по самому медленному мобильному интернету будет сложновато).
В Pandas существуют различные способы фильтрации для удаления NaN. Мы воспользуемся методом dropna(), который удаляет все строки с пропусками. Важно, что удаляется полностью строка, содержащая NaN, а не только ячейки с пропущенными значениями в столбце с пропусками.
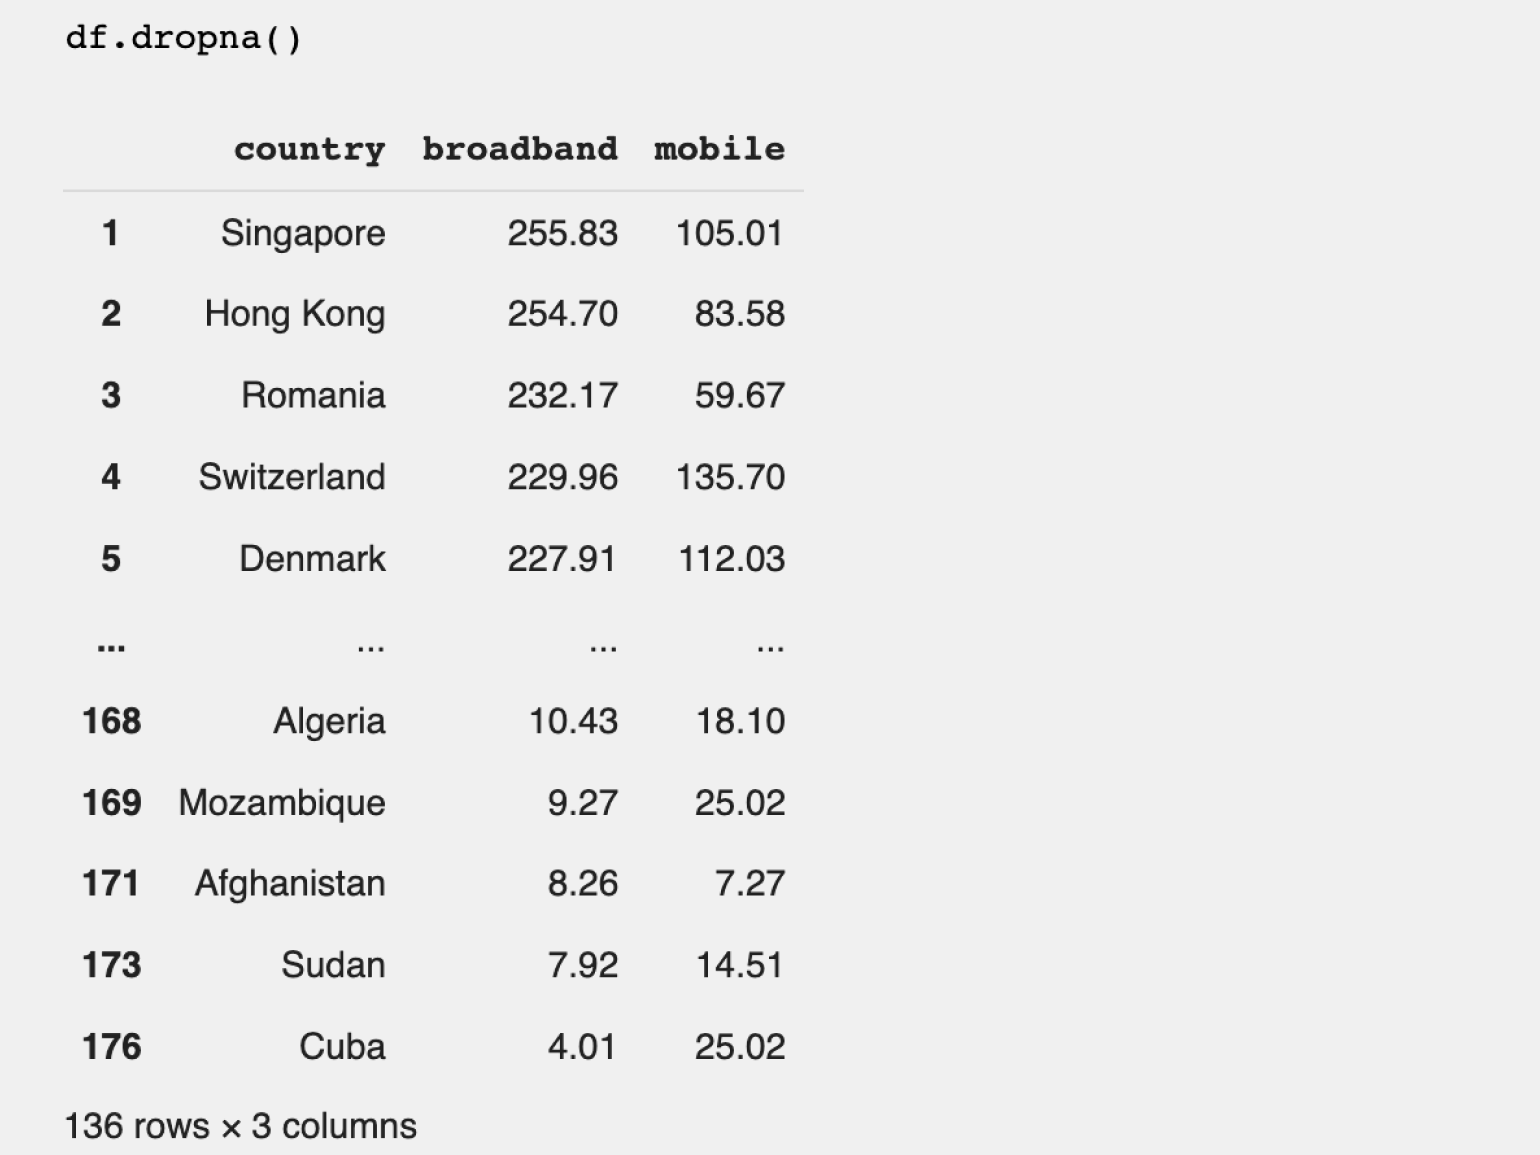
Количество строк в датафрейме при удалении пустых данных уменьшилось до 136. Если вернуться ко второму шагу, то можно увидеть, что это соответствует количеству заполненных строк в столбце mobile в начальном датафрейме.
Сохраним результат в новый датафрейм и назовём его df_without_nan. Изначальный DataFrame стараемся не менять, так как он ещё может нам понадобиться.
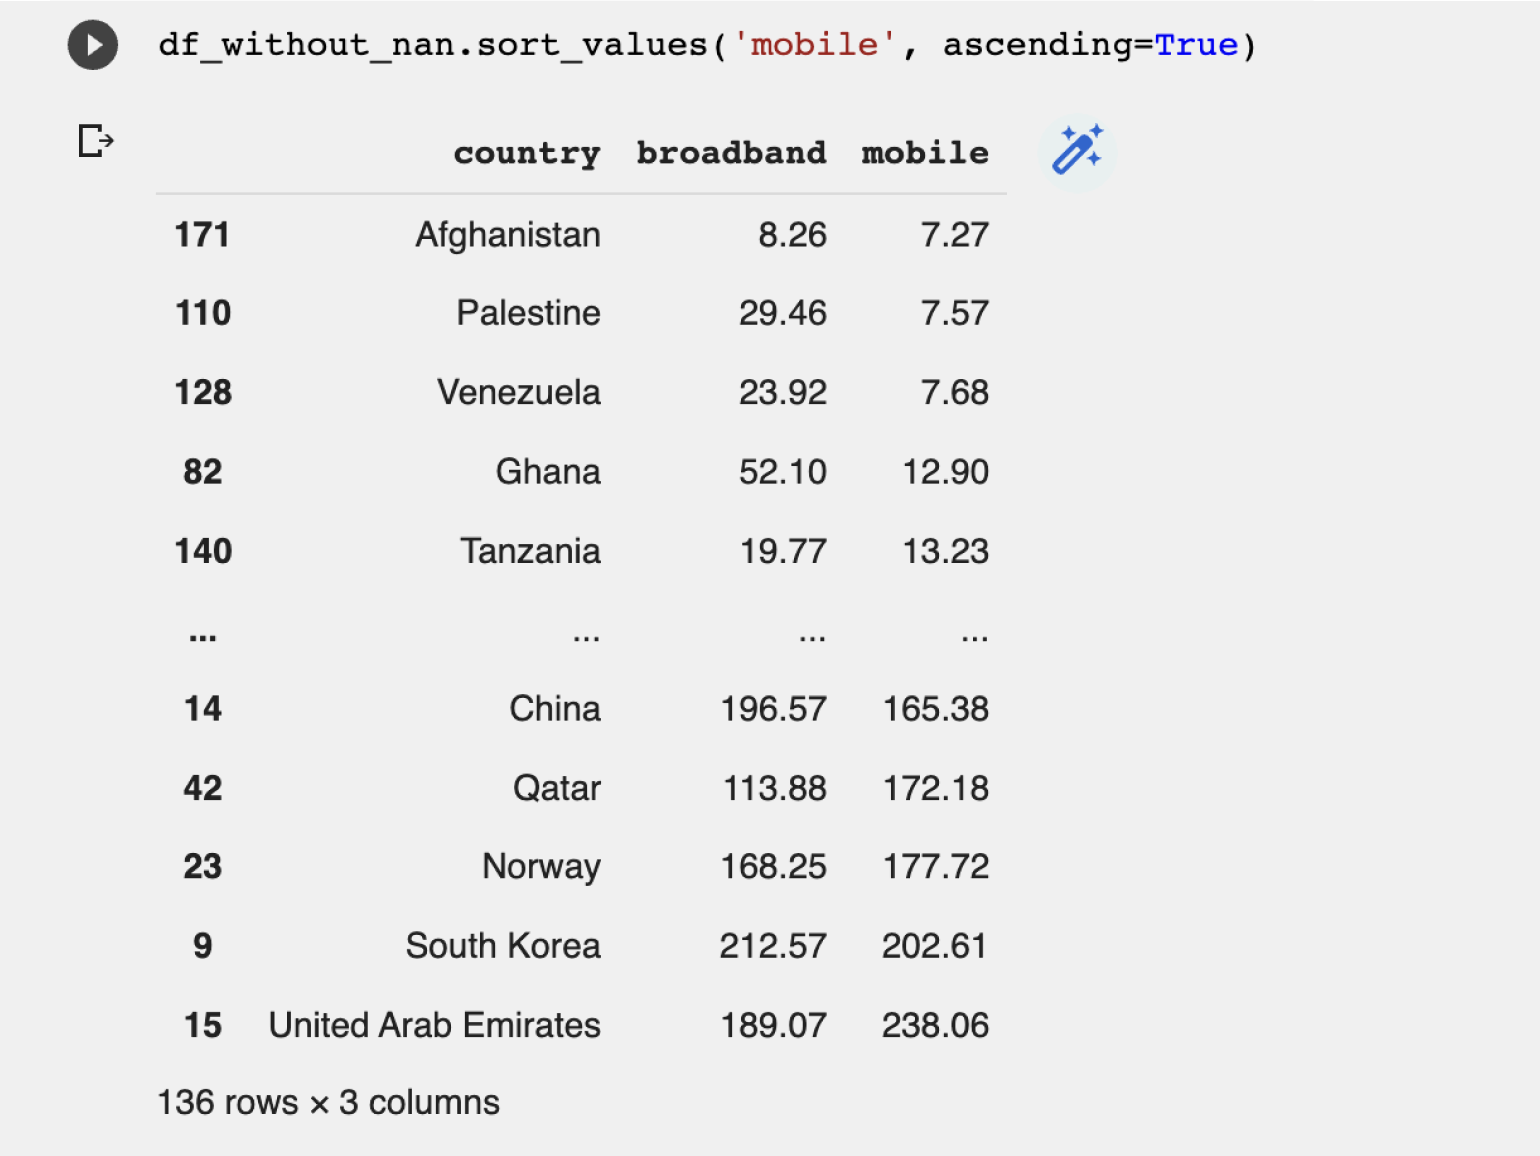
Худший мобильный интернет в Афганистане с небольшим отставанием от Палестины и Венесуэлы.
Что дальше?
Pandas в Python — мощная библиотека для анализа данных. В этой статье мы прошли по базовым операциям. Подробнее про работу библиотеки можно узнать в документации. Углубиться в работу с библиотекой можно благодаря специализированным книгам:
- «Изучаем pandas. Высокопроизводительная обработка и анализ данных в Python» Майкла Хейдта и Артёма Груздева;
- «Thinking in Pandas: How to Use the Python Data Analysis Library the Right Way», Hannah Stepanek;
- «Hands-On Data Analysis with Pandas: Efficiently perform data collection, wrangling, analysis, and visualization using Python», Stefanie Molin.
Читайте также:
- Библиотеки в программировании: для чего нужны и какими бывают
- Тест: угадайте, где эзотерические языки программирования, а где — нет
- Как начать программировать на Python: экспресс-гайд