Обнаружение новизны изображений с помощью Python и библиотеки scikit-learn
В этой статье я расскажу, как с помощью библиотек scikit-learn, opencv, numpy, imutilsс выявить новизну входных изображений. Многие программы требуют наличия возможности решить, принадлежит ли новый объект тому же распределению, что и существующие объекты (это промежуточный результат), или его следует рассматривать как новизну. Часто эта возможность используется для очистки реальных наборов данных.
Для начала установим необходимые библиотеки:
pip install numpy pip install opencv-contrib-python pip install imutils pip install scikit-learnВыявлять новинки будем методом «Обнаружения новинок», используя модуль Isolation Forests.

Одним из эффективных способов обнаружения новизны в наборе данных является использование случайных лесов. Алгоритм изолирует наблюдения, случайным образом выбирая признак, а затем случайным образом выбирая значение разделения между максимальным и минимальным значениями выбранного признака. Стратегия показана выше.
Рассмотрим работу алгоритма на конкретном примере. Пусть перед нами стоит задача – определить изображено ли картинке море.
Обучим модель на датасете фотографий моря.
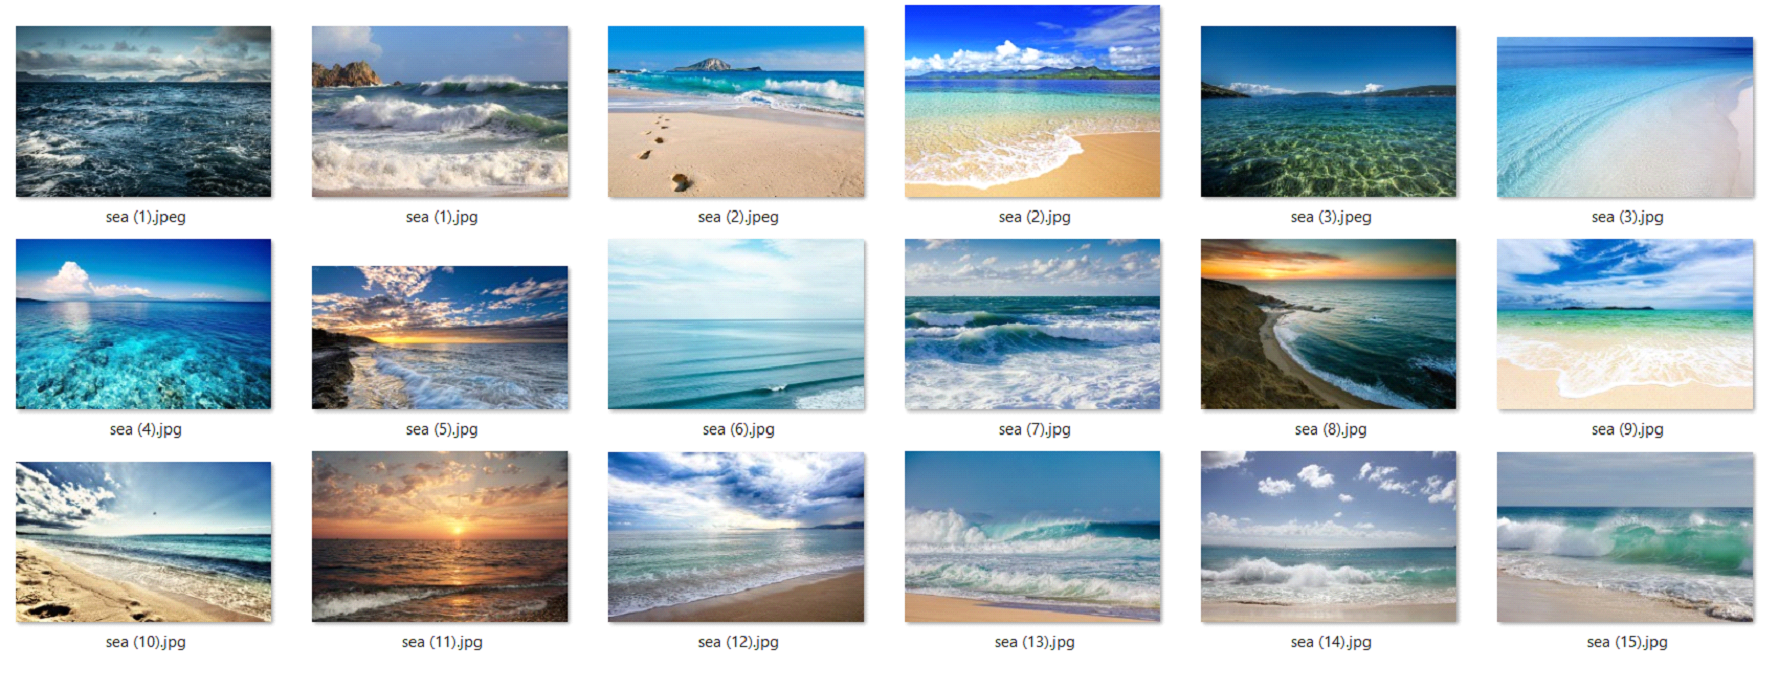
При представлении нового входного изображения наш алгоритм обнаружения новизны должен решить, вписывается ли новое изображение в «многообразие моря» или оно является новинкой, и вернуть либо 1, либо -1. Если возвращается 1, то делаем вывод «Да, это море», иначе «Нет, не похоже на море»
Для оценки нашего алгоритма обнаружения новинок используем 3 тестовых изображения:

Для начала реализуем модуль для извлечения цветовой гистограммы с помощью OpenCV, это необходимо для того, чтобы представить изображение в график пикселей:
from imutils import paths import numpy as np import cv2 def histogram_image(image, bins=(4, 6, 3)): # вычислияем 3D-цветовую гистограмму по изображению и нормализуем ее histogram = cv2.calcHist([image], [0, 1, 2], None, bins, [0, 180, 0, 256, 0, 256]) histogram = cv2.normalize(histogram, histogram).flatten() # Возращаем гистограмму return histogramЗатем загружаем датасет:
def loading_dataset(path_dataset, bins): # пути ко всем изображениям в нашем каталоге набора данных, затем # инициализируйте наши списки изображений path_s_image = list(paths.list_images(path_dataset)) data = [] # цикл по каждому патчу for path in path_s_image: image = cv2.imread(path) image = cv2.cvtColor(image, cv2.COLOR_BGR2HSV) features = quantify_image(image, bins) data.append(features) return np.array(data)Создаем файл Python для обучения модели на загруженном датасете и запускаем выполнение:
from function import loading_dataset from sklearn.ensemble import IsolationForest import pickle print("[ИНФО] подготовка набора данных") data = loading_dataset('sea/', bins=(3, 3, 3)) # обучаем модель print("[INFO] модель обнаружения") model = IsolationForest(n_estimators=100, contamination=0.01, random_state=42) model.fit(data) f = open('detect_anomaly.model', "wb") f.write(pickle.dumps(model)) f.close() Создаем файл test_anomaly для тестирования модели:
from function import histogram_image import pickle import cv2 print("[ИНФО] загрузка модели новизны") model = pickle.loads(open("detect_anomaly.model", "rb").read()) # Загрузка изображения,и конвертация в гистограмму image = cv2.imread('examples\cities.jpg') hsv = cv2.cvtColor(image, cv2.COLOR_BGR2HSV) features = histogram_image(hsv, bins=(3, 3, 3)) preds = model.predict([features])[0] label = "new" if preds == -1 else "normal" color = (0, 0, 255) if preds == -1 else (0, 255, 0) # рисуем фотографию cv2.putText(image, label, (10, 25), cv2.FONT_HERSHEY_SIMPLEX, 0.7, color, 2) # отображаем на экране cv2.imshow("Output", image) cv2.waitKey(0)Тестируем модель на трех фотографиях – город, море и шоссе.
Тест 1. В модель загружаем фото города.
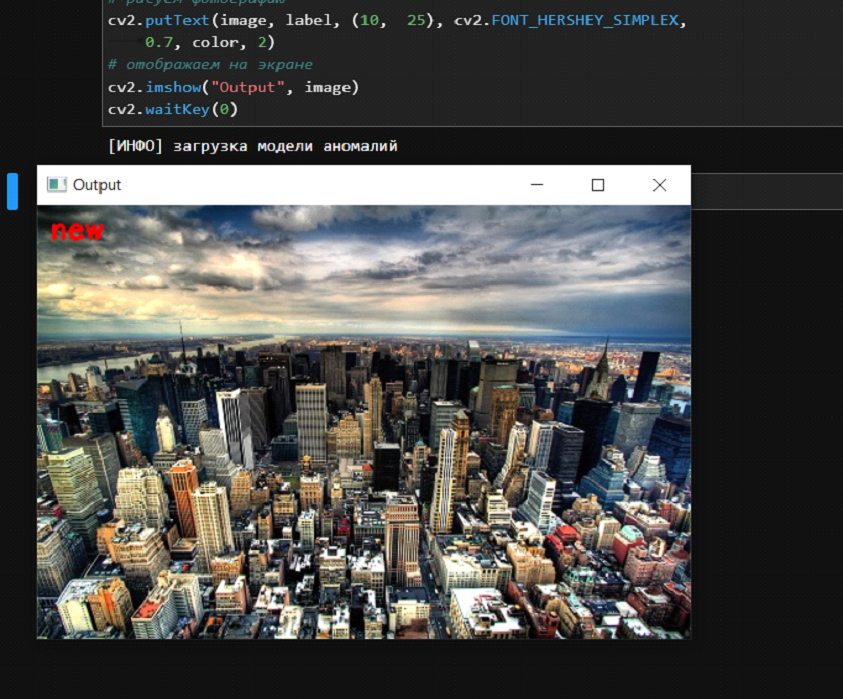
По результату отработки алгоритма видим, что фотографию города модель пометила как новинку.
Тест 2. В модель загружаем фото моря.

Фотографию моря модель пометила как нормальное. То есть на картинки изображено море.
Тест 3. В модель загружаем фото шоссе.
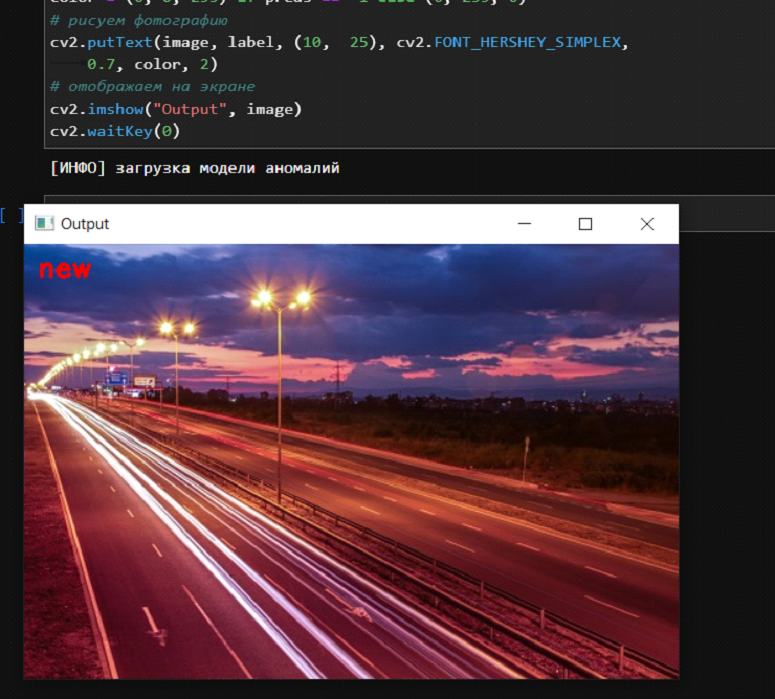
Фотографию шоссе модель пометила как новинку.
В результате, наша обученная модель прошла три из трех тестов, и определила все фотографии верно. Две из которых были новинками и одно фото не являлось новинкой.
Python: распознавание объектов в реальном времени
Чтобы посмотреть, как это делается, откройте новый файл, назовите его real_time_object_detection.py и вставьте следующий код:
# import the necessary packages
from imutils.video import VideoStream
from imutils.video import FPS
import numpy as np
import argparse
import imutils
import time
import cv2
Мы начали с импортирования библиотек (на строках 2-8). Для этого вам необходим imutils и OpenCV .
Пишем код для работы с командной строкой.
Далее анализируем аргументы командной строки:
# construct the argument parse and parse the arguments
ap = argparse.ArgumentParser()
ap.add_argument("-p", "--prototxt", required=True,
help="path to Caffe 'deploy' prototxt file")
ap.add_argument("-m", "--model", required=True,
help="path to Caffe pre-trained model")
ap.add_argument("-c", "--confidence", type=float, default=0.2,
help="minimum probability to filter weak detections")
args = vars(ap.parse_args())
- —prototxt : Путь к prototxt Caffe файлу.
- —model : Путь к предварительно подготовленной модели.
- —confidence : Минимальный порог валидности (сходства) для распознавания объекта (значение по умолчанию — 20%).
Добавляем основные объекты.
Затем мы инициализируем список классов и набор цветов:
# initialize the list of class labels MobileNet SSD was trained to
# detect, then generate a set of bounding box colors for each class
CLASSES = ["background", "aeroplane", "bicycle", "bird", "boat",
"bottle", "bus", "car", "cat", "chair", "cow", "diningtable",
"dog", "horse", "motorbike", "person", "pottedplant", "sheep",
"sofa", "train", "tvmonitor"]
COLORS = np.random.uniform(0, 255, size=(len(CLASSES), 3))
На строках 22-26 мы инициализируем метки CLASS и соответствующие случайные цвета.
Теперь загрузим модель и настроим наш видео поток:
# load our serialized model from disk
print("[INFO] loading model. ")
net = cv2.dnn.readNetFromCaffe(args["prototxt"], args["model"])
# initialize the video stream, allow the cammera sensor to warmup,
# and initialize the FPS counter
print("[INFO] starting video stream. ")
vs = VideoStream(src=0).start()
time.sleep(2.0)
fps = FPS().start()
Загружаем нашу сериализованную модель, предоставляя ссылки на prototxt и модели (строка 30) — обратите внимание, насколько это просто в OpenCV.
Затем инициализируем видео поток (это может быть видеофайл или веб-камера). Сначала запускаем VideoStream (строка 35), затем мы ждём, пока камера включится (строка 36), и, наконец, начинаем отсчёт кадров в секунду (строка 37). Классы VideoStream и FPS являются частью пакета imutils.
Пишем код для работы с кадрами.
Теперь проходим по каждому кадру (чтобы увеличить скорость, можно пропускать кадры).
# loop over the frames from the video stream
while True:
# grab the frame from the threaded video stream and resize it
# to have a maximum width of 400 pixels
frame = vs.read()
frame = imutils.resize(frame, width=400)
# grab the frame dimensions and convert it to a blob
(h, w) = frame.shape[:2]
blob = cv2.dnn.blobFromImage(cv2.resize(frame, (300, 300)),
0.007843, (300, 300), 127.5)
# pass the blob through the network and obtain the detections and
# predictions
net.setInput(blob)
detections = net.forward()
Первое, что мы делаем — считываем кадр (строка 43) из потока, затем заменяем его размер (строка 44).
Поскольку чуть позже нам понадобится ширина и высота, получим их сейчас (строка 47). Затем следует преобразование кадра в blob с модулем dnn (строки 48 и 49).
Теперь к сложному: мы устанавливаем blob как входные данные в нашу нейросеть (строка 53) и передаём эти данные через net (строка 54), которая обнаруживает наши предметы.
«Фильтруем» объекты.
На данный момент, мы обнаружили объекты в видео потоке. Теперь пришло время посмотреть на значения валидности и решить, должны ли мы нарисовать квадрат вокруг объекта и повесить лейбл.
# loop over the detections
for i in np.arange(0, detections.shape[2]):
# extract the confidence (i.e., probability) associated with
# the prediction
confidence = detections[0, 0, i, 2]
# filter out weak detections by ensuring the `confidence` is
# greater than the minimum confidence
if confidence > args["confidence"]:
# extract the index of the class label from the
# `detections`, then compute the (x, y)-coordinates of
# the bounding box for the object
idx = int(detections[0, 0, i, 1])
box = detections[0, 0, i, 3:7] * np.array([w, h, w, h])
(startX, startY, endX, endY) = box.astype("int")
# draw the prediction on the frame
label = "<>: %".format(CLASSES[idx],
confidence * 100)
cv2.rectangle(frame, (startX, startY), (endX, endY),
COLORS[idx], 2)
y = startY - 15 if startY - 15 > 15 else startY + 15
cv2.putText(frame, label, (startX, y),
cv2.FONT_HERSHEY_SIMPLEX, 0.5, COLORS[idx], 2)
Мы начинаем проходить циклами через наши detections, помня, что несколько объектов могут быть восприняты как единое изображение. Мы также делаем проверку на валидность (т.е. вероятность) для каждого обнаружения. Если валидность достаточно велика (т.е. выше заданного порога), отображаем предсказание в терминале, а также рисуем на видео потоке предсказание (обводим объект в цветной прямоугольник и вешаем лейбл).
Давайте разберём по строчкам:
Проходим по detections, получаем значение валидности (строка 60).
Если значение валидности выше заданного порога (строка 64), извлекаем индекс лейбла в классе (строка 68) и высчитываем координаты рамки вокруг обнаруженного объекта (строка 69).
Затем, извлекаем (x;y)-координаты рамки (строка 70), которые будем использовать для отображения прямоугольника и текста.
Делаем текстовый лейбл, содержащую имя из CLASS и значение валидности (строки 73 и 74).
Также, рисуем цветной прямоугольник вокруг объекта, используя цвета класса и раннее извлечённые (x;y)-координаты (строки 75 и 76).
В целом, нужно, чтобы лейбл располагался над цветным прямоугольником, однако, может возникнуть такая ситуация, что сверху будет недостаточно места, поэтому в таких случаях выводим лейбл под верхней стороной прямоугольника (строка 77).
Наконец, мы накладываем цветной текст и рамку на кадр, используя значение ‘y’, которое мы только что вычислили (строки 78 и 79).
Оставшиеся задачи:
- Отображение кадра
- Проверка ключа выхода
- Обновление счётчика FPS
# show the output frame
cv2.imshow("Frame", frame)
key = cv2.waitKey(1) & 0xFF
# if the `q` key was pressed, break from the loop
if key == ord("q"):
break
# update the FPS counter
fps.update()
Код вверху довольно очевиден: во-первых, выводим кадр (строка 82). Затем фиксируем нажатие клавиши (строка 83), проверяя, не нажата ли клавиша «q» (quit). Если условие истинно, мы выходим из цикла (строки 86 и 87).
Наконец, обновляем наш счётчик FPS (строка 90).
Если происходит выход из цикла (нажатие клавиши «q» или конец видео потока), у нас есть вещи, о которых следует позаботиться:
# stop the timer and display FPS information
fps.stop()
print("[INFO] elapsed time: ".format(fps.elapsed()))
print("[INFO] approx. FPS: ".format(fps.fps()))
# do a bit of cleanup
cv2.destroyAllWindows()
vs.stop()
При выходе из цикла, останавливаем счётчик FPS (строка 92) и выводим информацию о конечном значении FPS в терминал (строки 93 и 94).
Закрываем окно программы (строка 97), прекращая видео поток (строка 98).
Если вы зашли так далеко, вероятно, вы готовы попробовать программу на своей веб-камере. Чтобы посмотреть, как это делается, перейдём к следующему разделу.
Часть 2: тестируем распознавание объектов в реальном времени на веб-камере
Чтобы увидеть детектор объектов в реальном времени в действии, убедитесь, что вы скачали исходники и предварительно подготовленную Convolutional Neural Network.
Оттуда открываете терминал и выполняете следующие команды:
$ python real_time_object_detection.py \
--prototxt MobileNetSSD_deploy.prototxt.txt \
--model MobileNetSSD_deploy.caffemodel
[INFO] loading model.
[INFO] starting video stream.
[INFO] elapsed time: 55.07
[INFO] approx. FPS: 6.54
Обнаружение новизны изображений с помощью Python и библиотеки scikit-learn
Всем добрый день! Сегодня расскажу, как с помощью библиотек scikit-learn, opencv, numpy, imutilsс выявить новизну входных изображений.
Многие программы требуют наличия возможности решить, принадлежит ли новый объект тому же распределению, что и существующие объекты (это промежуточный результат), или его следует рассматривать как новизну. Часто эта возможность используется для очистки реальных наборов данных.
Для начала установим необходимые библиотеки:
pip install numpy pip install opencv-contrib-python pip install imutils pip install scikit-learn
Выявлять новинки будем методом «Обнаружения новинок», используя модуль Isolation Forests.
Одним из эффективных способов обнаружения новизны в наборе данных является использование случайных лесов. Алгоритм изолирует наблюдения, случайным образом выбирая признак, а затем случайным образом выбирая значение разделения между максимальным и минимальным значениями выбранного признака. Стратегия показана выше. Рассмотрим работу алгоритма на конкретном примере. Пусть перед нами стоит задача – определить изображено ли картинке море. Обучим модель на датасете фотографий моря.
При представлении нового входного изображения наш алгоритм обнаружения новизны должен решить, вписывается ли новое изображение в «многообразие моря» или оно является новинкой, и вернуть либо 1, либо -1. Если возвращается 1, то делаем вывод «Да, это море», иначе «Нет, не похоже на море». Для оценки нашего алгоритма обнаружения новинок используем 3 тестовых изображения:
Для начала реализуем модуль для извлечения цветовой гистограммы с помощью OpenCV, это необходимо для того, чтобы представить изображение в график пикселей:
from imutils import paths import numpy as np import cv2 def histogram_image(image, bins=(4, 6, 3)): # вычислияем 3D-цветовую гистограмму по изображению и нормализуем ее histogram = cv2.calcHist([image], [0, 1, 2], None, bins, [0, 180, 0, 256, 0, 256]) histogram = cv2.normalize(histogram, histogram).flatten() # Возращаем гистограмму return histogram
Затем загружаем датасет:
def loading_dataset(path_dataset, bins): # пути ко всем изображениям в нашем каталоге набора данных, затем # инициализируйте наши списки изображений path_s_image = list(paths.list_images(path_dataset)) data = [] # цикл по каждому патчу for path in path_s_image: image = cv2.imread(path) image = cv2.cvtColor(image, cv2.COLOR_BGR2HSV) features = quantify_image(image, bins) data.append(features) return np.array(data)
Создаем файл Python для обучения модели на загруженном датасете и запускаем выполнение:
from function import loading_dataset from sklearn.ensemble import IsolationForest import pickle print(«[ИНФО] подготовка набора данных») data = loading_dataset(‘sea/’, bins=(3, 3, 3)) # обучаем модель print(«[INFO] модель обнаружения») model = IsolationForest(n_estimators=100, contamination=0.01, random_state=42) model.fit(data) f = open(‘detect_anomaly.model’, «wb») f.write(pickle.dumps(model)) f.close()
Создаем файл test_anomaly для тестирования модели:
from function import histogram_image import pickle import cv2 print(«[ИНФО] загрузка модели новизны») model = pickle.loads(open(«detect_anomaly.model», «rb»).read()) # Загрузка изображения,и конвертация в гистограмму image = cv2.imread(‘examples\cities.jpg’) hsv = cv2.cvtColor(image, cv2.COLOR_BGR2HSV) features = histogram_image(hsv, bins=(3, 3, 3)) preds = model.predict([features])[0] label = «new» if preds == -1 else «normal» color = (0, 0, 255) if preds == -1 else (0, 255, 0) # рисуем фотографию cv2.putText(image, label, (10, 25), cv2.FONT_HERSHEY_SIMPLEX, 0.7, color, 2) # отображаем на экране cv2.imshow(«Output», image) cv2.waitKey(0)
Тестируем модель на трех фотографиях – город, море и шоссе.Тест 1. В модель загружаем фото города.
По результату отработки алгоритма видим, что фотографию города модель пометила как новинку. Тест 2. В модель загружаем фото моря.
Фотографию моря модель пометила как нормальное. То есть на картинки изображено море. Тест 3. В модель загружаем фото шоссе.
Фотографию шоссе модель пометила как новинку. В результате, наша обученная модель прошла три из трех тестов, и определила все фотографии верно. Две из которых были новинками и одно фото не являлось новинкой.
Распознавание лиц при помощи Python и OpenCV
В этой статье мы разберемся, что такое распознавание лиц и чем оно отличается от определения лиц на изображении. Мы кратко рассмотрим теорию распознавания лиц, а затем перейдем к написанию кода. В конце этой статьи вы сможете создать свою собственную программу распознавания лиц на изображениях, а также в прямом эфире с веб-камеры.
Что такое обнаружение лиц?
Одной из основных задач компьютерного зрения является автоматическое обнаружение объекта без вмешательства человека. Например, определение человеческих лиц на изображении.
Лица людей отличаются друг от друга. Но в целом можно сказать, что всем им присущи определенные общие черты.
Существует много алгоритмов обнаружения лиц. Одним из старейших является алгоритм Виолы-Джонса. Он был предложен в 2001 году и применяется по сей день. Чуть позже мы тоже им воспользуемся. После прочтения данной статьи вы можете изучить его более подробно.
Обнаружение лиц обычно является первым шагом для решения более сложных задач, таких как распознавание лиц или верификация пользователя по лицу. Но оно может иметь и другие полезные применения.
Вероятно самым успешным использованием обнаружения лиц является фотосъемка. Когда вы фотографируете своих друзей, встроенный в вашу цифровую камеру алгоритм распознавания лиц определяет, где находятся их лица, и соответствующим образом регулирует фокус.
Что такое распознавание лиц?
Итак, в создании алгоритмов обнаружения лиц мы (люди) преуспели. А можно ли также распознавать, чьи это лица?
Распознавание лиц — это метод идентификации или подтверждения личности человека по его лицу. Существуют различные алгоритмы распознавания лиц, но их точность может различаться. Здесь мы собираемся описать распознавание лиц при помощи глубокого обучения.
Итак, давайте разберемся, как мы распознаем лица при помощи глубокого обучения. Для начала мы производим преобразование, или, иными словами, эмбеддинг (embedding), изображения лица в числовой вектор. Это также называется глубоким метрическим обучением.
Для облегчения понимания давайте разобьем весь процесс на три простых шага:
Обнаружение лиц
Наша первая задача — это обнаружение лиц на изображении или в видеопотоке. Далее, когда мы знаем точное местоположение или координаты лица, мы берем это лицо для дальнейшей обработки.
Извлечение признаков
Вырезав лицо из изображения, мы должны извлечь из него характерные черты. Для этого мы будем использовать процедуру под названием эмбеддинг.
Нейронная сеть принимает на вход изображение, а на выходе возвращает числовой вектор, характеризующий основные признаки данного лица. (Более подробно об этом рассказано, например, в нашей серии статей про сверточные нейронные сети — прим. переводчика). В машинном обучении данный вектор как раз и называется эмбеддингом.
Теперь давайте разберемся, как это помогает в распознавании лиц разных людей.
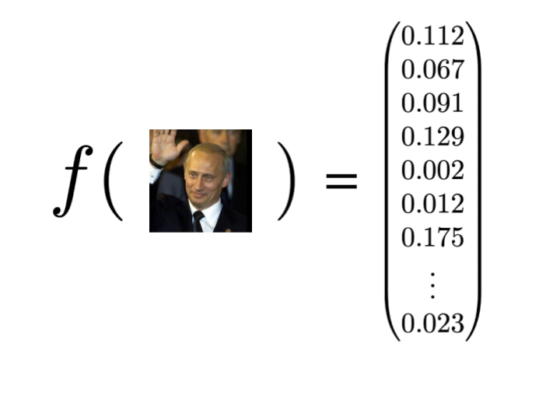
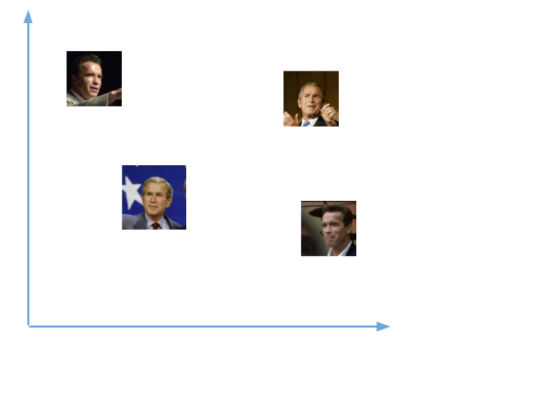
Во время обучения нейронная сеть учится выдавать близкие векторы для лиц, которые выглядят похожими друг на друга.
Например, если у вас есть несколько изображений вашего лица в разные моменты времени, то естественно, что некоторые черты лица могут меняться, но все же незначительно. Таким образом, векторы этих изображений будут очень близки в векторном пространстве. Чтобы получить общее представление об этом, взгляните на график:
Чтобы определять лица одного и того же человека, сеть будет учиться выводить векторы, находящиеся рядом в векторном пространстве. После обучения эти векторы трансформируются следующим образом:
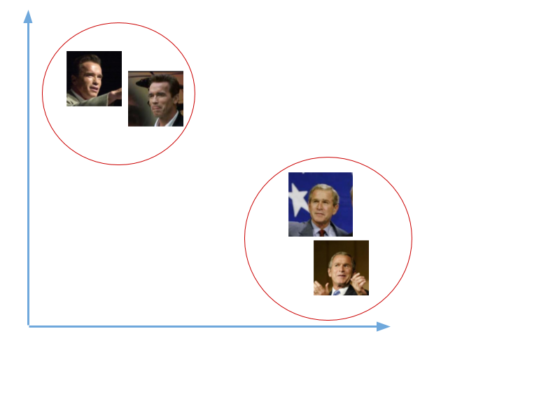
Здесь мы не будем заниматься обучением подобной сети. Это требует значительных вычислительных мощностей и большого объема размеченных данных. Вместо этого мы используем уже предобученную Дэвисом Кингом нейронную сеть. Она обучалась приблизительно на 3000000 изображений. Эта сеть выдает вектор длиной 128 чисел, который и определяет основные черты лица.
Познакомившись с принципами работы подобных сетей, давайте посмотрим, как мы будем использовать такую сеть для наших собственных данных.
Мы передадим все наши изображения в эту предобученную сеть, получим соответствующие вектора (эмбеддинги) и затем сохраним их в файл для следующего шага.
Сравнение лиц
Теперь, когда у нас есть вектор (эмбеддинг) для каждого лица из нашей базы данных, нам нужно научиться распознавать лица из новых изображений. Таким образом, нам нужно, как и раньше, вычислить вектор для нового лица, а затем сравнить его с уже имеющимися векторами. Мы сможем распознать лицо, если оно похоже на одно из лиц, уже имеющихся в нашей базе данных. Это означает, что их вектора будут расположены вблизи друг от друга, как показано на примере ниже:
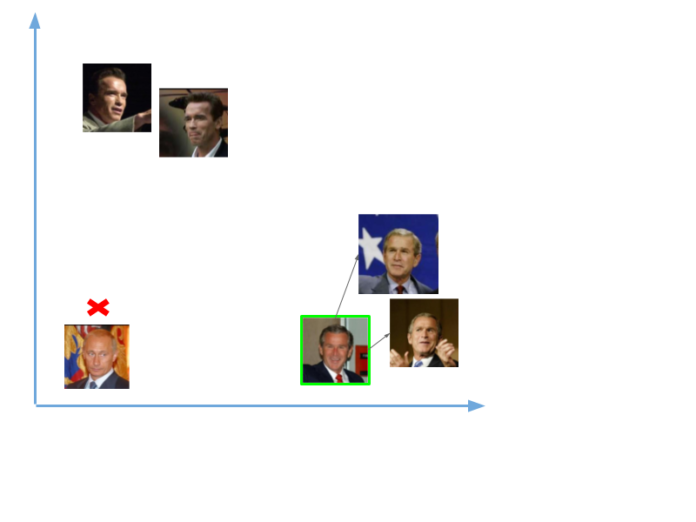
Итак, мы передали в сеть две фотографии, одна Владимира Путина, другая Джорджа Буша. Для изображений Буша у нас были вектора (эмбеддинги), а для Путина ничего не было. Таким образом, когда мы сравнили эмбеддинг нового изображения Буша, он был близок с уже имеющимися векторам,и и мы распознали его. А вот изображений Путина в нашей базе не было, поэтому распознать его не удалось.
Что такое OpenCV?
В области искусственного интеллекта задачи компьютерного зрения — одни из самых интересных и сложных.
Компьютерное зрение работает как мост между компьютерным программным обеспечением и визуальной картиной вокруг нас. Оно дает ПО возможность понимать и изучать все видимое в окружающей среде.
Например, на основе цвета, размера и формы плода мы определяем разновидность определенного фрукта. Эта задача может быть очень проста для человеческого разума, однако в контексте компьютерного зрения все выглядит иначе.
Сначала мы собираем данные, затем выполняем определенные действия по их обработке, а потом многократно обучаем модель, как ей распознавать сорт фрукта по размеру, форме и цвету его плода.
В настоящее время существуют различные пакеты для выполнения задач машинного обучения, глубокого обучения и компьютерного зрения. И безусловно, модуль, отвечающий за компьютерное зрение, проработан лучше других.
OpenCV — это библиотека с открытым программным кодом. Она поддерживает различные языки программирования, например R и Python. Работать она может на многих платформах, в частности — на Windows, Linux и MacOS.
Основные преимущества OpenCV :
- имеет открытый программный код и абсолютно бесплатна
- написана на C/C++ и в сравнении с другими библиотеками работает быстрее
- не требует много памяти и хорошо работает при небольшом объеме RAM
- поддерживает большинство операционных систем, в том числе Windows, Linux и MacOS.
Установка
Здесь мы будем рассматривать установку OpenCV только для Python. Мы можем установить ее при помощи менеджеров pip или conda (в случае, если у нас установлен пакет Anaconda).
1. При помощи pip
При помощи pip процесс установки может быть выполнен с использованием следующей команды:
pip install opencv-python
2. Anaconda
Если вы используете Anaconda, то выполните следующую команду в окружении Anaconda:
conda install -c conda-forge opencv
Распознавание лиц с использованием Python
В этой части мы реализуем распознавание лиц при помощи Python и OpenCV. Для начала посмотрим, какие библиотеки нам потребуются и как их установить:
- OpenCV
- dlib
- Face_recognition
OpenCV — это библиотека обработки изображений и видео, которая используется для их анализа. Ее применяют для обнаружения лиц, считывания номерных знаков, редактирования фотографий, расширенного роботизированного зрения, оптического распознавания символов и многого другого.
Библиотека dlib , поддерживая Дэвисом Кингом, содержит реализацию глубокого метрического обучения. Мы ее будем использовать для конструирования векторов (эмбеддингов) изображений, играющих ключевую роль в процессе распознавания лиц.
Библиотека face_recognition , созданная Адамом Гейтгеем, включает в себя функции распознавания лиц dlib и является по сути надстройкой над ней. С ней очень легко работать, и мы будем ее использовать в нашем коде. Имейте ввиду, что ее нужно устанавливать после библиотеки dlib .
Для установки OpenCV наберите в командной строке:
pip install opencv-python
Мы перепробовали множество способов установки dlib под WIndows и простейший способ это сделать — при помощи Anaconda. Поэтому для начала установите Anaconda (вот здесь подробно рассказано, как это делается). Затем введите в терминале следующую команду:
conda install -c conda-forge dlib
Далее, для установки библиотеки face_recognition наберите в командной строке следующее:
pip install face_recognition
Теперь, когда все необходимые модули установлены, приступим к написанию кода. Нам нужно будет создать три файла.
Первый файл будет принимать датасет с изображениями и выдавать эмбеддинг для каждого лица. Эти эмбеддинги будут записываться во второй файл. В третьем файле мы будем сравнивать лица с уже существующими изображениями. А затем мы сделаем тоже самое в стриме с веб-камеры.
Извлечение признаков лица
Для начала вам нужно достать датасет с лицами или создать свой собственный. Главное, убедитесь, что все изображения находятся в папках, причем в каждой папке должны быть фотографии одного и того же человека.
Затем разместите датасет в вашей рабочей директории, то есть там, где выбудете создавать собственные файлы.
from imutils import paths import face_recognition import pickle import cv2 import os # в директории Images хранятся папки со всеми изображениями imagePaths = list(paths.list_images('Images')) knownEncodings = [] knownNames = [] # перебираем все папки с изображениями for (i, imagePath) in enumerate(imagePaths): # извлекаем имя человека из названия папки name = imagePath.split(os.path.sep)[-2] # загружаем изображение и конвертируем его из BGR (OpenCV ordering) # в dlib ordering (RGB) image = cv2.imread(imagePath) rgb = cv2.cvtColor(image, cv2.COLOR_BGR2RGB) #используем библиотеку Face_recognition для обнаружения лиц boxes = face_recognition.face_locations(rgb,model='hog') # вычисляем эмбеддинги для каждого лица encodings = face_recognition.face_encodings(rgb, boxes) # loop over the encodings for encoding in encodings: knownEncodings.append(encoding) knownNames.append(name) # сохраним эмбеддинги вместе с их именами в формате словаря data = # для сохранения данных в файл используем метод pickle f = open("face_enc", "wb") f.write(pickle.dumps(data)) f.close()
Сейчас мы сохранили все эмбеддинги в файл под названием face_enc . Теперь мы можем их использовать для распознавания лиц на изображениях или во время видеострима с веб-камеры.
Распознавание лиц во время прямой трансляции веб-камеры
Вот код для распознавания лиц из прямой трансляции веб-камеры:
import face_recognition import imutils import pickle import time import cv2 import os # find path of xml file containing haarcascade file cascPathface = os.path.dirname( cv2.__file__) + "/data/haarcascade_frontalface_alt2.xml" # load the harcaascade in the cascade classifier faceCascade = cv2.CascadeClassifier(cascPathface) # load the known faces and embeddings saved in last file data = pickle.loads(open('face_enc', "rb").read()) print("Streaming started") video_capture = cv2.VideoCapture(0) # loop over frames from the video file stream while True: # grab the frame from the threaded video stream ret, frame = video_capture.read() gray = cv2.cvtColor(frame, cv2.COLOR_BGR2GRAY) faces = faceCascade.detectMultiScale(gray, scaleFactor=1.1, minNeighbors=5, minSize=(60, 60), flags=cv2.CASCADE_SCALE_IMAGE) # convert the input frame from BGR to RGB rgb = cv2.cvtColor(frame, cv2.COLOR_BGR2RGB) # the facial embeddings for face in input encodings = face_recognition.face_encodings(rgb) names = [] # loop over the facial embeddings incase # we have multiple embeddings for multiple fcaes for encoding in encodings: # Compare encodings with encodings in data["encodings"] # Matches contain array with boolean values and True for the embeddings it matches closely # and False for rest matches = face_recognition.compare_faces(data["encodings"], encoding) # set name =inknown if no encoding matches name = "Unknown" # check to see if we have found a match if True in matches: #Find positions at which we get True and store them matchedIdxs = [i for (i, b) in enumerate(matches) if b] counts = <> # loop over the matched indexes and maintain a count for # each recognized face face for i in matchedIdxs: # Check the names at respective indexes we stored in matchedIdxs name = data["names"][i] # increase count for the name we got counts[name] = counts.get(name, 0) + 1 # set name which has highest count name = max(counts, key=counts.get) # update the list of names names.append(name) # loop over the recognized faces for ((x, y, w, h), name) in zip(faces, names): # rescale the face coordinates # draw the predicted face name on the image cv2.rectangle(frame, (x, y), (x + w, y + h), (0, 255, 0), 2) cv2.putText(frame, name, (x, y), cv2.FONT_HERSHEY_SIMPLEX, 0.75, (0, 255, 0), 2) cv2.imshow("Frame", frame) if cv2.waitKey(1) & 0xFF == ord('q'): break video_capture.release() cv2.destroyAllWindows()
В данном примере для обнаружения лиц использовался метод cv2.CascadeClassifier() из библиотеки OpenCV. Но вы с таким же успехом можете пользоваться и методом face_recognition.face_locations() , как мы уже делали в предыдущем примере.
Распознавание лиц на изображениях
Код для обнаружения и распознавания лиц на изображениях почти аналогичен тому, что вы видели выше. Убедитесь в этом сами:
import face_recognition import imutils import pickle import time import cv2 import os # find path of xml file containing haarcascade file cascPathface = os.path.dirname( cv2.__file__) + "/data/haarcascade_frontalface_alt2.xml" # load the harcaascade in the cascade classifier faceCascade = cv2.CascadeClassifier(cascPathface) # load the known faces and embeddings saved in last file data = pickle.loads(open('face_enc', "rb").read()) # Find path to the image you want to detect face and pass it here image = cv2.imread(Path-to-img) rgb = cv2.cvtColor(image, cv2.COLOR_BGR2RGB) # convert image to Greyscale for haarcascade gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY) faces = faceCascade.detectMultiScale(gray, scaleFactor=1.1, minNeighbors=5, minSize=(60, 60), flags=cv2.CASCADE_SCALE_IMAGE) # the facial embeddings for face in input encodings = face_recognition.face_encodings(rgb) names = [] # loop over the facial embeddings incase # we have multiple embeddings for multiple fcaes for encoding in encodings: # Compare encodings with encodings in data["encodings"] # Matches contain array with boolean values and True for the embeddings it matches closely # and False for rest matches = face_recognition.compare_faces(data["encodings"], encoding) # set name =inknown if no encoding matches name = "Unknown" # check to see if we have found a match if True in matches: # Find positions at which we get True and store them matchedIdxs = [i for (i, b) in enumerate(matches) if b] counts = <> # loop over the matched indexes and maintain a count for # each recognized face face for i in matchedIdxs: # Check the names at respective indexes we stored in matchedIdxs name = data["names"][i] # increase count for the name we got counts[name] = counts.get(name, 0) + 1 # set name which has highest count name = max(counts, key=counts.get) # update the list of names names.append(name) # loop over the recognized faces for ((x, y, w, h), name) in zip(faces, names): # rescale the face coordinates # draw the predicted face name on the image cv2.rectangle(image, (x, y), (x + w, y + h), (0, 255, 0), 2) cv2.putText(image, name, (x, y), cv2.FONT_HERSHEY_SIMPLEX, 0.75, (0, 255, 0), 2) cv2.imshow("Frame", image) cv2.waitKey(0)
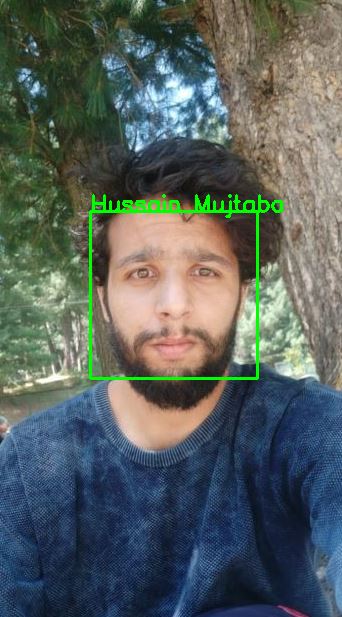
Результат:

На этом наша статья подошла к концу. Мы надеемся, что вы получили общее представление о задачах распознавания лиц и способах их решения.