Regex101 com как пользоваться
Что такое регулярные выражения Regex ?
Точка . : Любые символы
Наборы символов [abc]
Наборы негативных символов [^abc]
Буквенный диапазон [a-z]
Цифровой диапазон [0-9]
Практика: Базовые сходства
Практика: Любые символы
Практика: Наборы символов
Практика: Отрицательные наборы символов
Практика: Диапазон букв
Практика: Диапазон номеров
Фигурные скобки — 1
Фигурные скобки — 2
Фигурные скобки — 3
Практика: Знак плюс +
Практика: Вопросительный знак ?
Практика: Фигурные скобки — 1
Практика: Фигурные скобки — 2
Практика: Фигурные скобки — 3
Круглые скобки () : Группа
Ссылка на группу
Круглые скобки (?:) : Группа без захвата
Знак каретки ^ :
Выбор по началу строки
Знак доллара $ :
Выбор по концу строки
Цифробуквенный \w : буква, число и подчеркивание
Кроме цифробуквенных \W
Числовой символ \d
Кроме символа числа \D
Кроме символа пробела \S
Lookarounds (Позиционные проверки)
Позитивная опережающая проверка: (?=)
Негативная опережающая проверка: (?!)
Позитивная ретроспективная проверка: (?
Негативная ретроспективная проверка: (?
Флаг без учета регистра
Поздравляем, вы прошли все шаги!
Вступление
Regex — это сокращение от Regular Expression (Регулярное выражение) . Это помогает сопоставлять, находить или управлять текстом. Начните с ввода OK (латиницей) в поле Regex, чтобы перейти к первому шагу и получить доступ к более подробному описанию..
Регулярные выражения
Большинство современных языков программирования и текстовых редакторов (по моему личному мнению) поддерживают регулярные выражения. Поддержим их и мы.
/Быть или не быть/ugi 
Синтаксис регулярных выражений прост и логичен. Он разделяется на символ-разделитель (он идёт в начале и конце выражения, обычно это /), шаблон поиска и необязательные модификаторы.
Формальный синтаксис такой:
[разделитель][шаблон][разделитель][модификаторы] Разделителем может быть любой символ, но обычно это / или ~ . Важно лишь то, чтобы шаблон начинался и заканчивался одним и тем же разделителем. В самом конце регулярных выражений идут модификаторы, которые нужны, чтобы менять логику работы шаблонов (например делать регистронезависимый поиск).
Давайте разберём выражение /Быть или не быть/ugi :
/ - начальный символ-разделитель Быть или не быть - шаблон поиска / - конечный символ-разделитель ugi - модификаторы (UTF-8, global, case insensitive) Данное регулярное выражение будет искать текст Быть или не быть не зависимо от регистра по всему тексту неограниченное количество раз. Модификатор u нужен для того, чтобы явно указать, что текст у нас в юникоде, то есть содержит символы, отличные от латиницы. Модификатор i включает регистронезависимый поиск. Модификатор g указывает поисковику идти до победного конца, иначе он остановится после первого удачного совпадения.
«Петя любит Дашу».replace(/Дашу|Машу|Сашу/, «Катю») 
Не трудно догадаться, что результатом работы js-выражения выше будет текст «Петя любит Катю» . Даже, если Петя неровно дышит к Маше или Саше, то результат всё равно не изменится.
Рассмотрим базовые спец. символы, которые можно использовать в шаблонах:
| Символ | Описание | Пример использования | Результат |
|---|---|---|---|
| \ | Символ экранирования или начала мета-символа | /путь\/к\/папке/ | Надёт текст путь/к/папке |
| ^ | Признак начала строки | /^Дом/ | Найдёт все строки, которые начинаются на Дом |
| $ | Признак конца строки | /родной$/ | Найдёт все строки, которые заканчиваются на родной |
| . | Точка означает любой символ, кроме перевода строки | /Петя ..бит Машу/ | Найдёт как Петя любит Машу , так и Петя губит Машу |
| | | Означает ИЛИ | /Вася|Петя/ | Найдёт как Васю, так и Петю |
| ? | Означает НОЛЬ или ОДИН раз | /Вжу?х/ | Найдёт Вжх и Вжух |
| * | Означает НОЛЬ или МНОГО раз | /Вжу*х/ | Найдёт Вжх , Вжух , Вжуух , Вжууух и т.д. |
| + | Означает ОДИН или МНОГО раз | /Вжу+х/ | Найдёт Вжух , Вжуух , Вжууух и т.д. |
Помимо базовых спец. символов есть мета-символы (или мета-последовательности), которые заменяют группы символов:
| Символ | Описание | Пример использования | Результат |
|---|---|---|---|
| \w | Буква, цифра или _ (подчёркивание) | /^\w+$/ | Соответствует целому слову без пробелов, например _Вася333_ |
| \W | НЕ буква, цифра или _ (подчёркивание) | /\W\w+\W/ | Найдёт полное слово, которое обрамлено любыми символами, например @Петя@ |
| \d | Любая цифра | /^\d+$/ | Соответствует целому числу без знака, например 123 |
| \D | Любой символ НЕ цифра | /^\D+$/ | Соответствует любому выражению, где нет цифр, например Петя |
| \s | Пробел или табуляция (кроме перевода строки) | /\s+/ | Найдёт последовательность пробелов от одного и до бесконечности |
| \S | Любой символ, кроме пробела или табуляции | /\s+\S/ | Найдёт последовательность пробелов, после которой есть хотя бы один другой символ |
| \b | Граница слова | /\bдом\b/ | Найдёт только отдельные слова дом , но проигнорирует рядом |
| \B | НЕ граница слова | /\Bдом\b/ | Найдёт только окночние слов, которые заканчиваются на дом |
| \R | Любой перевод строки (Unix, Mac, Windows) | /.*\R/ | Найдёт строки, которые заканчиваются переводом строки |
Нужно отметить, что спец. символы \w, \W, \b и \B не работают по умолчанию с юникодом (включая кириллицу). Для их правильной работы нужно указывать модификатор u . К сожалению, на окончание 2019 года JavaScript не поддерживает регулярные выражения для юникода даже с модификатором, поэтому в js эти мета-символы работают только для латиницы.
Ещё регулярные выражения поддерживают разные виды скобочек:
| Выражение | Описание | Пример использования | Результат |
|---|---|---|---|
| (. ) | Круглые скобки означают под-шаблон, который идёт в результат поиска | /(Петя|Вася|Саша) любит Машу/ | Найдёт всю строку и запишет воздыхателя Маши в результат поиска под номером 1 |
| (. ) | Круглые скобки с вопросом и двоеточием означают под-шаблон, который НЕ идёт в результат поиска | /(?:Петя|Вася|Саша) любит Машу/ | Найдёт только полную строку, воздыхатель останется инкогнито |
| (?P. ) | Задаёт имя под-шаблона | /(?PПетя|Вася|Саша) любит Машу/ | Найдёт полную строку, а воздыхателя запишет в результат под индексом 1 и ‘воздыхатель’ |
| [abc] | Квадратные скобки задают ЛЮБОЙ СИМВОЛ из последовательности (включая спец. символы \w, \d, \s и т.д.) | /^[123]+$/ | Соответствует любому выражению 323323123 , но не 54321 |
| [a-я0-9] | Если внутри квадратных скобок указать минус, то это считается диапазоном | /[A-Za-zА-Яа-яЁё0-9_]+/ | Аналог /\w/ui для JavaScript |
| [abc-] | Если минус является первым или последним символом диапазона, то это просто минус | /[0-9+-]+/ | Найдёт любое целое числое с плюсом или минусом (причём не обязательно, чтобы минус или плюс были спереди) |
| [^. ] | Квадратные скобки с «крышечекой» означают любой символ НЕ входящий в диапазон | /[^a-zа-я0-9 ]/i | Найдёт любой символ, который не является буквой, числом или пробелом |
| [[:class:]] | Квадратные скобки в квадратных скобках задают класс символов (alnum, alpha, ascii, digit, print, space, punct и другие) | /[^[:print:]]+/ | Найдёт последовательность непечатаемых символов |
| Фигурные скобки с одним числом задают точное количество символов | /\w+н\w+/u | Найдёт слово, в котором две буквы н | |
| Фигурные скобки с двумя числами задают количество символов от n до k | /\w+н\w+/u | Найдёт слово, в котором есть одна или две буквы н | |
| Фигурные скобки с одним числом и запятой задают количество символов от n до бесконечности | /\w+н\w+/u | Найдёт слово, в котором н встречается от трёх и более раз подряд |
Как правильно писать регулярные выражения 
Прежде, чем садиться и писать регулярно выраженного кракена, подумайте, что именно вы хотите сделать. Регулярное выражение должно начинаться с мысли «Я хочу найти/заменить/удалить то-то и то-то». Затем вам нужен исходный текст, который содержит как ПРАВИЛЬНЫЕ, так и НЕправильные данные. Затем вы открываете https://regex101.com/, вставляете текст и начинаете писать регулярное выражение. Этот замечательный инструмент укажет и покажет все ошибки, а также подсветит результаты поиска.
Для примера возьмём валидацию ip-адреса. Первая мысль должна быть: «Я хочу валидировать ip-адрес. А что такое ip-адрес? Из чего он состоит?». Затем нужен список валидных и невалидных адресов:
# Валидные адреса 0.0.0.0 0.1.2.3 99.99.99.99 199.199.199.199 255.255.255.255 # Невалидные адреса 01.01.01.01 .1.2.3 1.2.3. 255.0.0.256 Валидный адрес должен содержать четыре числа (байта) от 0 до 255. Если он содержит число больше 255, это уже ошибка. Если бы мы делали валидацию на каком-либо языке программирования, то можно было бы разбить выражение на четыре части и проверить каждое число отдельно. Но регулярные выражения не поддерживают проверки больше или меньше, поэтому придётся делать по-другому.
Для начала упростим задачу: будем валидировать не весь ip-адрес, а только один байт. А байт это всегда есть либо одно-, либо дву-, либо трёхзначное число. Для одно- и двузначного числа шаблон очень простой — любая цифра. А вот для трёхзначного числа первая цифра либо единица, либо двойка. Если первая цифра единица, то вторая и третья могут быть от нуля до девяти. Если же первая цифра двойка, то вторая может быть только от нуля до пяти. Если первая цифра двойка и вторая пятёрка, то третья может быть только от ноля до пяти. Давайте формализуем:
# Валидация байта от 0 до 9 \d от 10 до 99 [1-9]\d от 100 до 199 1\d\d от 200 до 249 2[0-4]\d от 250 до 255 25[0-5] Теперь, зная все диапазоны байта, можно объединить их в одно выражение через вертикальную палочку | (ИЛИ):
\b(\d|[1-9]\d|1\d\d|2[0-4]\d|25[0-5])\b Обратите внимание, что я использовал границу слова \b, чтобы искать полные байты. Пробуем регулярку в деле:
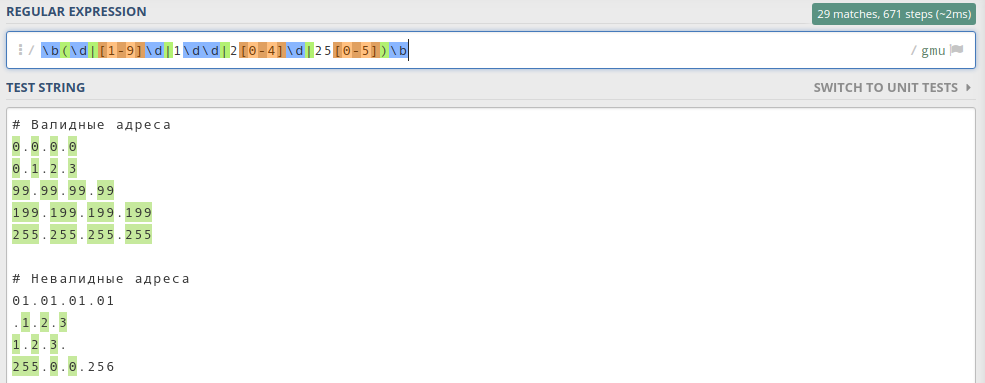
Как видим, все байты стали зелёненькими. Это значит, что мы на верном пути.
Осталось дело за малым: сделать так, чтобы искать четыре байта, а не один. Нужно учесть, что байты разделены тремя точками. То есть мы ищем три байта с точкой на конце и один без точки:
(\b(\d|[1-9]\d|1\d\d|2[0-4]\d|25[0-5])\b\.)\b(\d|[1-9]\d|1\d\d|2[0-4]\d|25[0-5])\b Результат выглядит так:
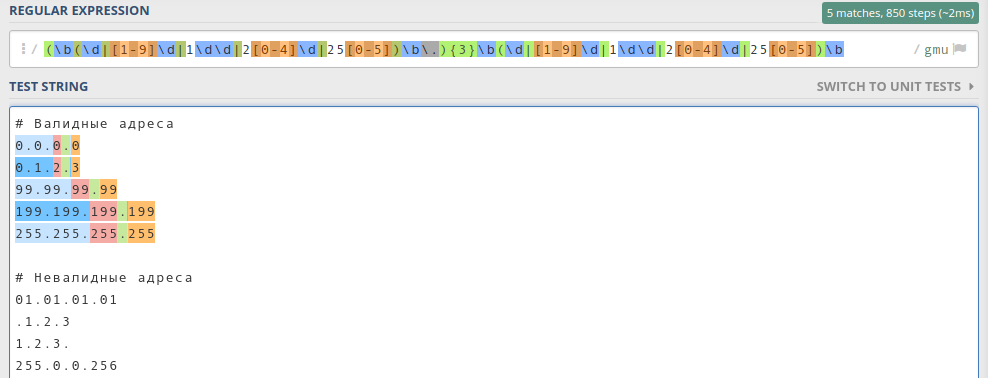
Подсветились только валидные ip-адреса, значит регулярное выражение работает корректно.
Если бы я сразу начал писать валидацию всего адреса, а не отдельного байта, то с большой долей вероятности допустил бы ошибку. Скопления скобочек, палочек и точечек трудно воспринимаются на глаз, поэтому задачу надо обязательно упрощать.
Практическое применение регулярных выражений 
Регулярными выражениями можно пользоваться не только для валидации, но и для обработки данных, например, в блокноте. Вот практический пример такой обработки: скопировать номера регионов и перевести в формат PHP-массива.
Your browser does not support HTML5 video.
Ссылки 
- https://regex101.com/ — сайт для тестирования регулярных выражений.
- https://linux.die.net/man/1/perlre — руководство по регулярным выражениям Perl.
- https://www.php.net/manual/ru/reference.pcre.pattern.syntax.php — регулярные выражения в PHP.
- https://developer.mozilla.org/ru/docs/Web/JavaScript/Reference/Global_Objects/RegExp — регулярные выражения JavaScript.
Как составлять регулярные выражения
Регулярное выражение — это последовательность символов (селекторов). Оно используется для поиска и обработки строк, слов, чисел и других текстовых данных.
Регулярные выражения выручают при решении разных задач. Например, с их помощью легко искать и менять строки в коде. Но чаще всего регулярные выражения используют для валидации форм. Давайте посмотрим, как это делать.
Шаблон регулярного выражения
Создать шаблон можно двумя способами. Выбирайте тот, что больше нравится:
Первый способ — через new RegExp() :
regularExpression = new RegExp("регулярное выражение", "флаги"); Второй способ — через слеши:
regularExpression = /регулярное выражение/флаги; Основные символы в регулярных выражениях
Посмотрим, чем наполнять шаблон регулярного выражения: какие селекторы использовать и что такое флаги.
Символы текста
Буквы и цифры — самые простые символы. Например, регулярное выражение оса найдет совпадение даже в слове «автосалон».
Символы начала и конца строки
Каретка ^ используется для обозначения начала строки, а доллар $ — для конца. К примеру, если мы напишем ^оса$ , то совпадением будет только со словом «оса».
Классы символов
С их помощью указываются диапазоны символов. То есть вы можете уточнить, какие буквы, цифры или знаки могут встречаться в регулярном выражении, а какие нет.
[^] — отрицание диапазона символов. Если коротко, вы можете исключить поиск конкретных символов. Например, [^оса] не найдёт совпадений со словом «оса», а вот с «осадками» совпадение будет.
- [0-9] — любая цифра от нуля до девяти;
- \d — тоже любая цифра, это эквивалент [0-9] .
- [а-яё] — любая буква кириллицы в нижнем регистре;
- [а-яёА-ЯЁ] — любая буква кириллицы в нижнем и верхнем регистре;
- [a-z] — любая буква на латинице в нижнем регистре;
- [a-zA-Z] — любая буква на латинице в нижнем и верхнем регистре;
- \w — любая цифра, латинская буква или знак подчёркивания.
Символы и знаки препинания:
- [. ;?!-] — знаки препинания.
- \s — пробел.
Квантификаторы
Эти селекторы проверяют количество повторений предыдущего символа или группы символов:
- — совпадение с точным количеством, где n — это положительное целое число. Например, конструкция [1-3] будет искать одну цифру от одного до трёх.
- — диапазон совпадений от минимального до максимального. Например, так можно указать минимальное и максимальное количество символов для ввода — . А ещё одно из значений можно пропустить — или .
- — одно или бесконечное количество совпадений. Этот селектор равнозначен записи `.
- + — одно или более повторений. Этот селектор равнозначен записи .
- ? — ни одного или одно повторение. Селектор равнозначен записи .
Модификаторы
Их ещё называют флагами. Это определённые параметры, которые задают настройки для поиска или замены текста.
Модификаторов много, мы перечислим лишь самые популярные:
- i — не учитывать регистр букв;
- g — искать все совпадения;
- u — поддержка юникод-символов.
Альтернация
Проще говоря, это условие. Альтернация обозначается символом | и указывает несколько вариантов, которые могут соответствовать регулярному выражению. Например, регулярное выражение (яблоко|банан) будет искать строки, содержащие либо слово «яблоко», либо «банан».
Символы группируются в скобках. При этом вы можете добавить условие «или» для любого количества символов: (a|b|c|d) .
�� Это лишь часть селекторов. Полный список вы найдёте на сайте MDN.
Как составить регулярное выражение
Сформулируйте условие. Например, вы хотите составить регулярное выражение для проверки логина. Этот логин должен быть длиннее трёх символов. Он может содержать буквы на кириллице и латинице или цифры. Регистр неважен.
Составьте выражение. Наполните шаблон селекторами, подходящими под ваши условия:
- Логин содержит буквы или цифры — /^[a-zа-яё0-9]/ .
- Слово должно быть не короче трёх символов, максимальной длины нет — /^[a-zа-яё0-9]/ .
- Регистр неважен — /^[a-zа-яё0-9]$/i .
Протестируйте регулярное выражение. Напишите собственные тесты или воспользуйтесь одним из онлайн-сервисов, например, regex101.
Регулярные выражения можно составить разными способами — даже два разработчика-коллеги напишут для одной и той же задачи что-то своё. Кому-то важна лаконичность — чем выражение короче, тем лучше. Кто-то хочет предусмотреть все варианты — например, вдруг пользователь введёт в логине нижнее подчёркивание. А кто-то просто хорошо знает возможности регулярок и гибко использует этот инструмент.
Примеры регулярных выражений
Регулярное выражение для номера телефона
Допустим, мы хотим проверить, что пользователь ввёл телефон в формате (XXX) XXX-XXXX . Можно составить следующее регулярное выражение: /^\d-\d-\d$/ . Здесь \d соответствует любой цифре, а фигурные скобки < и >указывают количество повторений.
Такое регулярное выражение будет соответствовать строкам, которые начинаются с открывающей скобки. За скобкой следуют три цифры, затем пробел, ещё три цифры, дефис и четыре цифры. Последним идёт символ конца строки.
✅ При проверке 123-456-7890 будет соответствовать шаблону, а (123) 456 7890 — нет.
Регулярное выражение для электронной почты
Составим регулярное выражение, которое проверяет формат почты username@domain.com — /^\w+([.-]?\w+)@\w+([.-]?\w+)(.\w)$/ . Выражение сложное, поэтому давайте посимвольно разбирать, что здесь происходит:
- ^ — начало строки.
- \w — любая буква, цифра или символ подчёркивания.
- + — указывает, что предыдущий символ (любая буква, цифра или символ подчёркивания) должен повторяться один или более раз.
- ([.-]?\w+)* — группа символов. Она начинается с точки, дефиса или ни одного из них ( ? ). За ними следует одна или более буквы, цифры или символы подчёркивания ( \w+ ). Звёздочка указывает, что эта группа может встречаться нуль или более раз.
- @ — символ собаки, он обязателен в адресе электронной почты.
- \w — любая буква, цифра или символ подчёркивания.
- ([.-]?\w+)* — аналогичная группа символов, как описано выше.
- . — просто точка.
- \w — любые буквы, цифры или символ подчёркивания.
- $ — конец строки.
Если коротко, это регулярное выражение будет соответствовать строкам, которые начинаются с одной или более буквы, цифры или символа подчёркивания. За ними следует символ @ . Затем идёт одна или более группа символов — она состоит из букв, цифр или подчёркивания, разделённых точкой. В конце — буквы, цифры или знак подчёркивания.
✅ При проверке example.email@mail.com будет соответствовать этому шаблону, а example.emailmail.com — нет.
Регулярное выражение для проверки имени человека
Предположим, мы хотим проверить, что введённое имя содержит только буквы и начинается с заглавной буквы. Для этого можно составить такое выражение: /^[А-Я][а-яё]*$/ . Здесь [А-Я] соответствует любой заглавной букве, а [а-яё] — любой букве в нижнем регистре. Звёздочка указывает, что предыдущий символ может повторяться нуль или более раз.
✅ При проверке имя Иван будет соответствовать шаблону, а иван — нет.
Заключение
Мы затронули лишь небольшую часть — основы регулярных выражений. Тема регулярок слишком обширна, чтобы рассказать обо всём в одной статье. Есть другие селекторы, модификаторы, да и сами регулярные выражения могут быть сложнее и интереснее.
�� Чтобы углубиться в тему, пройдите курс «Регулярные выражения для фронтенда». Он научит вас составлять регулярные выражения, чтобы писать меньше кода и работать быстрее.
Материалы по теме
- 3 способа валидации форм
- Зачем фронтендерам React, если есть JavaScript
- Частые ошибки в HTML-коде
«Доктайп» — журнал о фронтенде. Читайте, слушайте и учитесь с нами.
Тест регулярных выражений онлайн
Эта статья содержит краткий обзор сайтов с функцией тестирования регулярных выражений.
Регулярные выражения используются во многих направлениях программирования, но они довольно непросты для анализа и отладки.
Поэтому для упрощения работы с регулярными выражениями лучше пользоваться специальными онлайн инструментами, которые анализируют регулярные выражения, находят ошибки и проверяют выполнение.
regularexpressions101

Это сайт доступен по ссылке https://regex101.com/ и:
- Анализирует регулярное выражение, показывает его составляющие и объяснения. Если найдена ошибка, она подсвечивается.
- Выделяет цветом в тексте найденные строки, также можно посмотреть список ($&\n)
- Проверяет замены по регулярному выражению, показывая результирующий текст
- Выполняет тесты на совпадение или несовпадение
Поддерживаются варианты регулярных выражений
- PCRE2 (PHP >= 7.3)
- PCRE (PHP < 7.3)
- ECMAScript (JavaScript)
- Python 2.7
- Golang
- Java 8
Интерфейс сайта доступен на английском или с локализацией на:
- Голландский
- Китайский
- Немецкий
- Французский
- Шведский
Кроме того, на сайте имеется функция генератора кода для различных языков программирования и командной строки для sed.
RegExr

- Анализирует регулярное выражение, показывает его составляющие и описания. Ошибки подсвечиваются.
- Проверяет поиск по регулярному выражению и выделяет цветом найденные строки в тексте. Имеется вывод списка найденных строк.
- Проверяет замены по регулярному выражению, показывая результирующий текст.
Сайт поддерживает два варианта регулярных выражений:
Заключение
Онлайн инструменты действительно помогают сэкономить время при написании и отладке регулярных выражений, благодаря функциям анализа, проверки и тестирования.
Используя эти инструменты, можно составить регулярное выражение, сразу проверив его на ошибки и проанализировав его состав, затем посмотреть, что именно оно находит, и как происходит замена. После того, как регулярное выражение проверено, уже можно вставлять его в скрипт или программу.
Инструменты обладают удобным интерфейсом со справочной информацией по регулярным выражениям, подсветкой ошибок, выделением найденных строк.
https://regex101.com предлагает больше вариантов для вариаций формата регулярных выражений (6 против 2) и показался мне более удобным в плане интерфейса, хотя разница не такая большая. Для наиболее часто используемых ECMAScript и PCRE подходят оба сайта, поэтому можно пользоваться любым.
Программа nhrt использует ECMAScript, поэтому оба сайта https://regex101.com и https://regexr.com/ рекомендуются для проверки при составлении регулярных выражений для nhrt.
Тест регулярных выражений онлайн
- ← В Asana появился русский язык
- Преобразование html и txt →