Импорт данных из файлов различных типов в таблицы PostgreSQL
Каким образом можно осуществить импорт информации из файлов Excel/Access/CSV/… (список можно продолжить) в базу данных PostgreSQL? Этот вопрос с завидным постоянством появляется на форумах, конференциях и в списках рассылки, посвященных данной СУБД. Ответы на вопросы, касающиеся импорта данных в PostgreSQL, чаще всего содержат рекомендации по использованию различных (зачастую не опробованных на практике) SQL-скриптов, применению технологии ODBC совместно с приложением, в котором исходный файл был создан, или же советы воспользоваться разнообразными программными инструментами для преобразования данных с последующим вызовом утилиты pgsql. Эти рекомендации могут помочь решить задачу, связанную с импортом данных в БД PostgreSQL, но только в том случае, если исходный файл имеет простую структуру, объем импортируемой информации невелик, а пользователи могут подключаться к серверу напрямую.
Но что если исходный файл с информацией имеет формат Word 2007 или HTML? Или это TXT файл, содержащий Unicode данные? Или же CSV файл, размером несколько сотен мегабайт и имеющий достаточно большое число столбцов? В этой ситуации решения, приведенные выше, нередко не могут дать нужного результата – процесс импорта данных заканчивается ошибкой, исходные данные искажены и перенесены не в полном объеме, при этом сама процедура импорта занимает значительное время.
Простое и эффективное решение задачи импорта данных в PostgreSQL
В данной статье мы рассмотрим программный продукт, специально предназначенный для решения основных задач, связанных с импортом информации в PostgreSQL — EMS Data Import for PostgreSQL. Программа позволяет быстро импортировать данные в таблицы PostgreSQL из файлов MS Excel 97-2007, MS Access, DBF, XML, TXT, CSV, RTF, MS Word 2007, ODF и HTML. Пользователю предоставляется широкий набор возможностей, таких как определение разнообразных параметров импорта для каждого исходного файла в отдельности, осуществление импорта данных в одну или несколько таблиц либо представлений (views), расположенных в одной и той же или различных БД, выбор необходимого режима импортирования. Утилита позволяет использовать специальный режим пакетной вставки для максимально быстрого импорта данных, поддерживает Unicode и все последние версии СУБД PostgreSQL, имеет дружественный и гибкий пользовательский интерфейс, оформленный в виде мастера, который проведет Вас через все шаги импорта информации, а также обладает множеством других полезных возможностей.
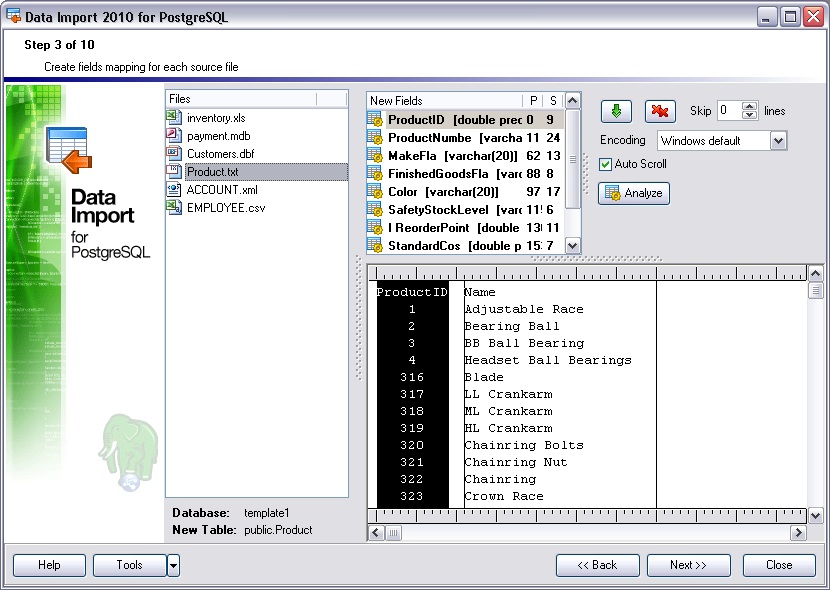
При использовании EMS Data Import for PostgreSQL для импорта данных, у пользователя программы существует возможность указать логическое соответствие между столбцами исходного файла и столбцами целевой таблицы, расположенной в БД PostgreSQL, при этом учитывая формат исходного файла. Более того, для большинства форматов исходных файлов программа способна определить такое соответствие автоматически, в случае если исходный файл и целевая таблица имеют сходный порядок столбцов или строк. При настройке процесса импорта пользователь может указать, если это необходимо, индивидуальный формат для каждого импортируемого поля. Это очень полезная возможность программы, когда требуется, например, определить значения для одного или некоторых исходных столбцов в виде констант или же в процессе импорта следует произвести автоматическую замену фрагмента текста в исходных данных на заданное значение. К другой полезной особенности EMS Data Import for PostgreSQL следует отнести возможность определить набор SQL команд, выполняемых непосредственно до или после процесса импорта.
Data Import for PostgreSQL позволяет полностью настроить пользовательский интерфейс под Ваши потребности, а также обладает многоязыковой поддержкой. В случае если сервер PostgreSQL расположен за сетевым брандмауэром и к нему нет возможности подключиться напрямую, утилита способна использовать для подключения SSH или HTTP туннели, при этом для SSH соединений, если это требуется по соображениям безопасности, можно указать открытый и личный криптографический ключ.
Если требуется выполнять импорт данных из файлов в БД PostgreSQL на периодической основе, то Вам достаточно настроить необходимые параметры в программе всего один раз и сохранить конфигурацию в виде специального файла-шаблона. В дистрибутив Data Import for PostgreSQL, помимо программы с графическим интерфейсом, входит консольная утилита, которую можно вызывать по расписанию, и тем самым автоматизировать процесс импорта. Имя ранее сохраненного файла с конфигурацией передается данной консольной утилите в виде параметра командной строки.
Для решения задач, связанных с импортом информации из файлов различных форматов в таблицы БД PostgreSQL, существует большое количество разнообразных программных продуктов, разработанные как на основе open source, так и коммерческие проекты с закрытым исходным кодом. Однако лишь некоторые из этих программ способны предложить пользователю полный набор функций, необходимых для успешного выполнения процесса импорта. EMS Data Import for PostgreSQL – один из немногих программных инструментов, позволяющий решить все основные вопросы, возникающие при решении задачи по импорту данных в БД PostgreSQL.
Следует заметить, что импорт данных – это малая часть из повседневных задач, с которыми сталкиваются администраторы PostgreSQL в их повседневной работе. EMS SQL Management Studio for PostgreSQL поможет Вам значительно упростить задачи, связанные с разработкой баз данных PostgreSQL, администрированием серверов этой СУБД, созданием эффективных SQL запросов, разграничением доступа к данным, сравнением и синхронизацией данных и схем БД, и многие другие.
Импорт данных с MSSQL на PostgreSQL
В наличии была база данных MSSQL (с которой забираем данные), а также PostgreSQL Pro Enterprise 10.3, развернутая на CentOS 7 (на которую импортируем). Ну и полное отсутствие интернета.
Установка библиотек FreeTDS
- Скачиваем freetds библиотеку (freetds-0.91.tar.gz) из интернета ручками (http://mirrors.ibiblio.org/freetds/stable/)
- По WinSCP перемещаем на postgres сервер в любую доступную папку (У меня /home/myuser/)
- Распаковываем архив tar -zxvf freetds-0.91.tar.gz
- Далее проверяем наличие следующих библиотек: gcc-c++, ncurses-devel (Можете кусаться, но лично у меня без этих библиотек дальнейшие шаги не получались)
- Переходим в папку библиотеки, она появится после распаковки архива и будет называться идентично cd freetds-0.91/
- Выполняем команду конфигурации. Запоминаем директорию, указанную в —prefix (у меня /usr/local/freetds) ./configure —prefix=/usr/local/freetds —enable-msdblib
- Далее выполняем команды make && make install Проверяем, чтобы в конце вывода команды не было ошибок. Если есть, гуглим, исправляем сразу. Если будут ошибки на данном шаге, дальше не установится. На этом шаге мы установили FreeTDS (в папку /usr/local/freetds). Продолжаем настраивать.
- Открываем конфиг-файл командой, либо ручками в WinSCP vim /etc/ld.so.conf
- Дописываем в файл через один пробел путь до lib директории уже установленной библиотеки (/usr/local/freetds/lib/) и сохраняем.
- Далее выполняем команду, чтобы применить эти изменения ldconfig
- Добавим для удобства в переменную PATH путь до bin папки библиотеки PATH=/usr/local/freetds/bin:$PATH
- Проверяем работоспособность tsql сервиса tsql -C Скрипт выведет список настроек
- Указываем конфигурацию MS сервера (к которому будем подключаться) в freetds.conf файле (его расположение выводится в команде выше) в следующем формате [my_server]
host = serverhost
port = serverport
tds version = 7.0 Прописываем хост и порт (по дефолту 1433), запоминаем имя в квадратных скобках, далее мы будем к нему обращаться. - Делаем тест подключение tsql -S myserver -U username -P password В результате успешного подключения откроется консоль
- Делаем тест запрос. Например, запросим список существующих таблиц для определенной базы SELECT TABLE_NAME FROM INFORMATION_SCHEMA.TABLES WHERE TABLE_TYPE = ‘BASE TABLE’ AND TABLE_CATALOG=’dbName’ Для выполнения через консоль, в строке 1> необходимо указать запрос, а в строке 2> написать слово go. А чтобы выйти из консоли MS сервера, пишем quit и нажимаем Enter .
Установка tds_fdw модуля
- Заходим на гит ресурс https://github.com/tds-fdw/tds_fdw.git
- Скачиваем модуль как zip-архив руками
- По WinSCP перемещаем на pg сервер в любую доступную папку (У меня /home/myuser/)
- Распаковываем архив командой unzip tds_fdw-master.zip
- Редактируем Makefile файл в папке с распакованным модулем (у меня /home/myuser/tds_fdw-master/Makefile) Редактируем переменные SHLIB_LINK и PG_CPPFLAGS, используем путь до уже установленной библиотеки freeTDS (путь запоминали в пункте 6 предыдущего блока)
- Выполняем команду make USE_PGXS=1 install Проверяем вывод команды. Ошибок быть не должно. Минутка траблшутинга Если возникает ошибка make: pg_config: Command not found а. Проверить наличие файла pg_config на системе. Можно искать через WinSCP или командой в консоли find / -depth -name «pg_config» b. Если файл отсутствует, проверить наличие пакета postgres\*version\* -devel-\* командой rpm -qa | grep postgres Если пакета нет, его нужно установить. В условиях отсутствия интернета качаем для этого rpm руками, перекидываем на сервер и устанавливаем командой yum localinstall /path/to/rpm/package.rpm c. Проверяем наличие pg_config файла. Он должен появиться
- Находим файл tds_fdw.so и проверяем его зависимые библиотеки ldd /path/to/file/tds_fdw.so Проверяем, что путь до lybsybdb.so.5 указан корректно. Если путь не указан, добавляем линку в папку /usr/lib/ , а затем выполняем ldconfig ln -s /usr/local/freetds/lib/libsybdb.so.5 /usr/lib/libsybdb.so.5 && ldconfig НА ЭТОМ ЭТАПЕ РАБОТА С СЕРВЕРОМ ЗАВЕРШЕНА, ПЕРЕХОДИМ В POSTGRESQL КОНСОЛЬ
Работа со связанным сервером
- Создаем расширение CREATE EXTENSION tds_fdw; Если расширение создалось успешно, значит, мы правильно подключили tds_fdw модуль.
- Создаем объект сервера CREATE SERVER serverName FOREIGN DATA WRAPPER tds_fdw OPTIONS (servername ‘serverName_fromFreetdsConf’, database ‘dbName’, msg_handler ‘notice’); serverName — любое имя связанного сервера, которое мы будем использовать в sql запросах serverName_fromFreetdsConf — имя сервера, конфигурацию которого мы прописывали в freetds.conf файле в блоке 1
- Выполняем маппинг текущего пользователя на созданный сервер CREATE USER MAPPING FOR CURRENT_USER SERVER serverName OPTIONS (username ‘dbUser’, password ‘dbUserPswd’);
- Импортируем схему со связанного сервера IMPORT FOREIGN SCHEMA dbo FROM SERVER serverName INTO localSchema; dbo — имя схемы из MS базы (в MS базах не принято делить на схемы, поэтому используется дефолтная dbo) serverName — имя связанного сервера localSchema — имя схемы в нашей pg базе (должна быть создана до выполнения импорта)
- Радуемся жизни, либо траблшутим проблемы несовместимости баз.
- postgresql
- postgres
- import foreign schema
- foreign tables
- freetds
- foreign data wrapper
- PostgreSQL
- Microsoft SQL Server
- Администрирование баз данных
SQL Базовый №4. Импорт и экспорт данных
Если ваши данные находятся в текстовых CSV-файлах, то их можно разом импортировать в базу данных. В PostgreSQL для этого есть команда COPY. Этой командой можно как импортировать данные, так и экспортировать.
3 шага для импорта данных из CSV:
- Подготовить CSV файл
- Создать таблицу в базе данных
- Выполнить импорт данных из CSV файла в заготовленную таблицу с использованием команды COPY
Работа с CSV-файлами
Многие приложения хранят данные в своих собственных уникальных форматах. Такие форматы сложно прочитать и конвертировать в нужный вам формат. К счастью, большинство программных продуктов позволяют экспортировать данные в формат CSV.
Каждая строка CSV-файла — это строка таблицы. В каждой строке значения столбцов разделены каким-то символом. Это может быть любой символ. В России в роли разделителя чаще всего используется двоеточие. На западе чаще всего применяется запятая.
Обычная строка CSV-файла выглядит примерно так:
1,Assumption Cathedral,Central Administrative District,Tver district,Kremlin,Lenin's Library,Sokolnica line,(495) 695-37-76,assumption-cathedral.kreml.ru,"37,617071","55,751012"Разделители отделяют данные разных столбцов друг от друга. Используется одна запятая без пробела после нее.
Кавычки
Значения разных столбцов разделены запятыми. А что делать, если само значение содержит запятые? Например, в таблице есть столбцы широты и долготы, в которых целые части от дробных отделены запятыми. Если столбец содержит разделитель, то все его значения должны начинаться и заканчиваться специальным символом text qualifier. Чаще всего это двойные кавычки.
При импорте база данных поймет, что значение в кавычках — это одно значение не смотря на то, что оно содержит разделитель. PostgreSQL по умолчанию игнорирует разделители, которые находятся внутри кавычек.
Строка заголовка
В CSV-файле обычно присутствует заголовок. Это строка, в которой перечислены имена столбцов. Выглядит она примерно так:
ID,Name,AdmArea,District,Address,MetroStation,MetroLine,PublicPhone,WebSite,Longitude_WGS84,Latitude_WGS84Некоторые СУБД сверяют имя столбца из файла CSV с названием столбца в таблице базы данных. В PostgreSQL такого функционала нет. Чтобы избежать ошибок нужно пропустить строку заголовка, если такая имеется. Для этого используется ключевое слово HEADER.
Импорт данных с помощью COPY
Чтобы импортировать данные из CSV-файла сначала нужно проверить сам источник, потом создать таблицу в базе данных. Далее нужно выполнить простой код из трех строк.
copy имя_таблицы_в_которую_импортируются_данные from 'путь_к_файлу_из_которого_копируются' with (format CSV, header);После ключевого слова WITH указываются параметры импорта. В данном случае указано, что формат файла источника — это CSV, в первой строке которого находятся заголовки. Параметров бывает много. Чаще всего используются следующие:
- Формат файла. Параметром format имя_формата указывается какой формат файла читается или пишется. Названия форматов: CSV, TXT, BINARY. Чаще всего применятся формат CSV. В файле TXT обычно в роли разделителя выступает табуляция.
- Строка заголовка. Параметр header означает, что в файле в первом столбце находятся заголовки. Этот параметр говорит базе данных, что импортировать данные нужно со второй строки.
- Разделитель. Параметр delimiter ‘символ_разделитель’ указывает какой символ в файле выступает разделителем. Разделителем может быть только 1 символ. Например, если в файле значения столбцов разделяются точкой с запятой, то параметр выглядит так: delimiter ‘;’.
- Символ кавычек. Двойные кавычки говорят о том, что данные между ними нужно считать одним значением. Вместо кавычек в CSV-файле может использоваться другой символ. В таком случае нужно воспользоваться параметром quote ‘символ_quote_qualifier’
Создаем таблицу
Создадим таблицу, в которую загрузим данные из CSV-файла с перечнем всех православных храмов Москвы.
create table religion ( id smallint, church_name varchar(300), adm_area varchar(50), district varchar(50), address varchar(100), metro_station varchar(40), metro_line varchar(40), phone varchar(100), site varchar(200), longitude numeric(8, 6), latitude numeric(8, 6) )copy religion from 'c:\Users\user\Desktop\sql_training\churches.csv' with (format csv, header, delimiter ';', encoding 'WIN1251')Импорт некоторых столбцов
Если в вашем CSV-файле есть данные только для некоторых столбцов вы все равно можете выполнить импорт. Нужно будет указать какие столбцы есть в данных.
Добавим в нашу таблицы данные по мечетям. В CSV-файле с данными о мечетях нет столбцов MetroStation, MetroLine, Longitude, Latitude. Если попытаться импортировать данные из этого файла в таблицу religion, то вернется ошибка SQL Error [22P04]: ОШИБКА: нет данных для столбца «site».
Названия столбцов в CSV-файле не совпадают с названиями столбцов в базе данных. В таком случае импорт делает в несколько шагов:
- Создается временная таблица
- Во временную таблицу импортируются данные из CSV-файла
- Из временной таблицы в основную таблицу с помощью insert into копируются нужные столбцы
- Временна таблица удаляется
-- Создание временной таблицы create temporary table mosques ( id smallint, object_name varchar(300), adm_area varchar(50), district varchar(50), address varchar(100), phone varchar(100), email varchar(40), site varchar(200) ) -- Импортируем данные во временную таблицу copy mosques from 'c:\Users\user\Desktop\sql_training\mosques.csv' with (format csv, header, delimiter ';', encoding 'WIN1251') -- Копирование нужных столбцов из временной таблицы insert into religion (id, object_name, adm_area, district, address, phone, site) select id, object_name, adm_area, district, address, phone, site from mosques; -- Удаляем временную таблицу drop table mosques;Экспорт с помощью COPY
Командой COPY можно не только импортировать данные, но и экспортировать. Разница в том, что теперь вместо ключевого слова FROM используется TO.
Есть 3 варианта экспорта:
- Таблица целиком
- Экспорт отдельных столбцов
- Экспорт результата запроса
-- Экспорт таблицы целиком copy religion to 'c:\Users\user\Desktop\sql_training\full_export.csv' with (FORMAT csv, header, delimiter ';'); -- Экспорт выбранных столбцов copy religion (object_name, district, address) to 'c:\Users\user\Desktop\sql_training\certain_cols_export.csv' with (FORMAT csv, header, delimiter ';'); -- Экспорт результата запроса -- Выбираем столбцы -- Оставляем только храмы из южного района copy (select object_name, district, address, metro_station, metro_line, longitude, latitude from religion where adm_area ilike '%southern%') to 'c:\Users\user\Desktop\sql_training\query_export.csv' with (FORMAT csv, header, delimiter ';');Экспорт с помощью UI
Вся таблица целиком
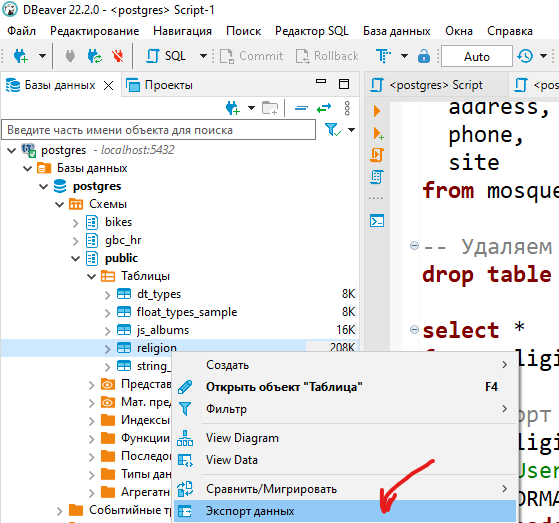
Чтобы экспортировать всю таблицу целиком найдите ее в панели Базы данных — Правый клик — Экспорт данных.
Определенные строки и столбцы
Выполните запрос. Под превью нажмите на кнопку экспорта данных. Далее нужно выбрать удобный вам формат и указать количество строк для экспорта. Если вам нужно сохранить все вернувшиеся строки, то можете предварительно посчитать количество строк с помощью функции COUNT().
Какая команда используется для импорта в postgresql
IMPORT FOREIGN SCHEMA — импортировать определения таблиц со стороннего сервера
Синтаксис
IMPORT FOREIGN SCHEMAудалённая_схема[ < LIMIT TO | EXCEPT >(имя_таблицы[, . ] ) ] FROM SERVERимя_сервераINTOлокальная_схема[ OPTIONS (параметр'значение' [, . ] ) ]
Описание
IMPORT FOREIGN SCHEMA создаёт сторонние таблицы, которые представляют таблицы, существующие на стороннем сервере. Новые сторонние таблицы будут принадлежать пользователю, выполняющему команду, и будут содержать корректные определения столбцов и параметры, соответствующие удалённым таблицам.
По умолчанию импортируются все таблицы и представления, существующие в определённой схеме на стороннем сервере. По желанию список таблиц можно ограничить некоторым подмножеством, или исключить из него конкретные таблицы. Новые сторонние таблицы создаются в целевой схеме, которая должна уже существовать.
Чтобы использовать IMPORT FOREIGN SCHEMA , необходимо иметь право USAGE для стороннего сервера, а также право CREATE в целевой схеме.
Параметры
удалённая_схема
Удалённая схема, из которой будут импортированы объекты. Что именно представляет собой удалённая схема, зависит от применяемой обёртки сторонних данных. LIMIT TO ( имя_таблицы [, . ] )
Импортировать только сторонние таблицы с заданными именами. Другие таблицы, существующие в сторонней схеме, будут проигнорированы. EXCEPT ( имя_таблицы [, . ] )
Исключить из импорта указанные сторонние таблицы. Данная команда импортирует все таблицы, существующие в сторонней схеме, за исключением перечисленных в этом предложении. имя_сервера
Сторонний сервер, с которого импортируется схема. локальная_схема
Схема, в которой будут созданы импортируемые сторонние таблицы. OPTIONS ( параметр ‘ значение ‘ [, . ] )
Параметры, которые должны применяться при импорте. Допустимые имена параметров и их значения зависят от обёртки сторонних данных.
Примеры
Импорт определений таблиц из удалённой схемы foreign_films на сервере film_server с созданием сторонних таблиц в локальной схеме films :
IMPORT FOREIGN SCHEMA foreign_films FROM SERVER film_server INTO films;
Та же операция, но импортируются только таблицы actors и directors (если они существуют):
IMPORT FOREIGN SCHEMA foreign_films LIMIT TO (actors, directors) FROM SERVER film_server INTO films;
Совместимость
Команда IMPORT FOREIGN SCHEMA соответствует стандарту SQL , за исключением параметра OPTIONS , являющегося расширением Postgres Pro .
См. также
| Пред. | Наверх | След. |
| GRANT | Начало | INSERT |