Code Freeze Определение и значение
Когда компания перестает выпускать новый код в определенное время года. Обычно это приходится на праздники или основные мероприятия для компании, и цель состоит в том, чтобы предотвратить снижение продукта или услуги компании, выпустив изменение кода в течение этого времени.
Пример: The company had a code freeze during the holiday season to prevent its website from going down during the peak shopping season.
Использование слова по странам: «Code Freeze»
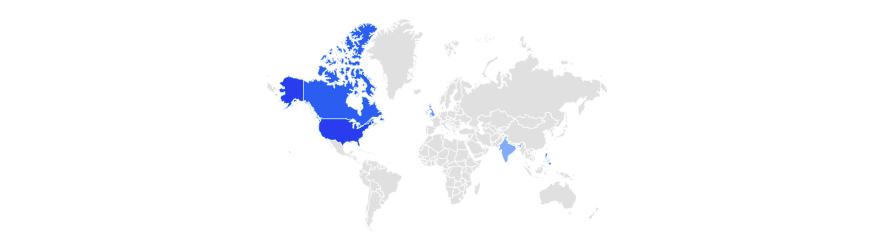
На деловом английском говорят во многих странах мира. Некоторые слова и фразы на веб-сайте понятны везде, где используется деловой английский, но некоторые слова и фразы используются только в определенных странах. На карте ниже показано, где чаще всего используется термин «Code Freeze».
Ниже приведен список популярных слов, фраз и идиом, которые люди искали на этом сайте.
В приведенном ниже списке указаны последние слова и фразы, добавленные на сайт.
Об этом сайте
Jargonism — это словарь делового английского языка. Изучите общие слова и фразы, используемые на рабочем месте.
Заморозка (программное обеспечение)
Замораживание в разработке программного обеспечения (заморозка, англ. freeze ) — момент времени, по достижению которого правила внесения изменений в исходный код ужесточаются. Замораживание помогает произвести выпуск (RTM) — обеспечить стадию разработки, для которой характерна стабильность.
- Анализ
- Проектирование
- Программирование
- Конструирование
- Тестирование
- Отладка
- Развёртывание
- Сопровождение
- Документирование
- Компилятор
- Отладчик
- Профилирование
- GUI-конструктор
- ИСР
- Автоматизация сборки
- Автоматизация релиза
- Инструменты тестирования
Распространённые типы замораживания:
- замораживание функциональных свойств (англ. feature freeze ), когда новые возможности не добавляются, а всё внимание переключается на исправление ошибок и тестирование, что позволяет улучшить стабильность программы перед релизом;
- замораживание кода (англ. code freeze ) [1] — состояние, при котором не разрешаются никакие изменения исходников; в больших проектах небольшие изменения могут сопровождаться ошибками в работе продукта, замораживание кода предотвращает допущение таких ошибок в последний момент, когда они могут быть незамеченными: код, который продолжительное время стабильно работал, попадает в ближайший выпуск; как правило, происходит перед выпуском релиз-кандидатов;
- замораживание требований и замораживание дизайна могут предшествовать стадии разработки [2] .
При разработке программного обеспечения вызванные замораживанием задержки решаются использованием системы управления версиями. Замораживанию подвергается только одна из ветвей (стабильная версия), а новые изменения реализуются в версии для разработчиков.
Oops something went wrong:
Codefreeze и непрерывная поставка
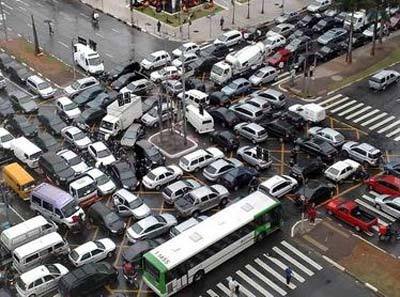
Пробки начинаются на перекрестках, когда транспортные потоки вступают в конфликт. Пока один поток движется, другой вынужден ждать. Что-то похожее происходит при выпуске очередного релиза программного продукта: чтобы выпустить продукт достойного качества, приходится останавливать разработку.
Программ без ошибок не бывает. Делая что-то полезное, мы невольно привносим в код то, что не собирались. Иногда неожиданности возникают на стыке, казалось бы, не связанных друг с другом изменений. Вот чудесный пример, как оптимизация драйвера мыши мешает обновлению адресной книги в Outlook. Поэтому всегда наступает такое время, когда команда сосредоточена исключительно на тестировании и исправлении ошибок. Добавление новых функций в это время запрещено.
Но источники новых требований, пожеланий и прочих хотелок не оскудевают. Пока идет стабилизация релиза, очередь на соседнем светофоре / бэклог продукта только растёт. Получается классическая пробка. Как разрешить этот конфликт?
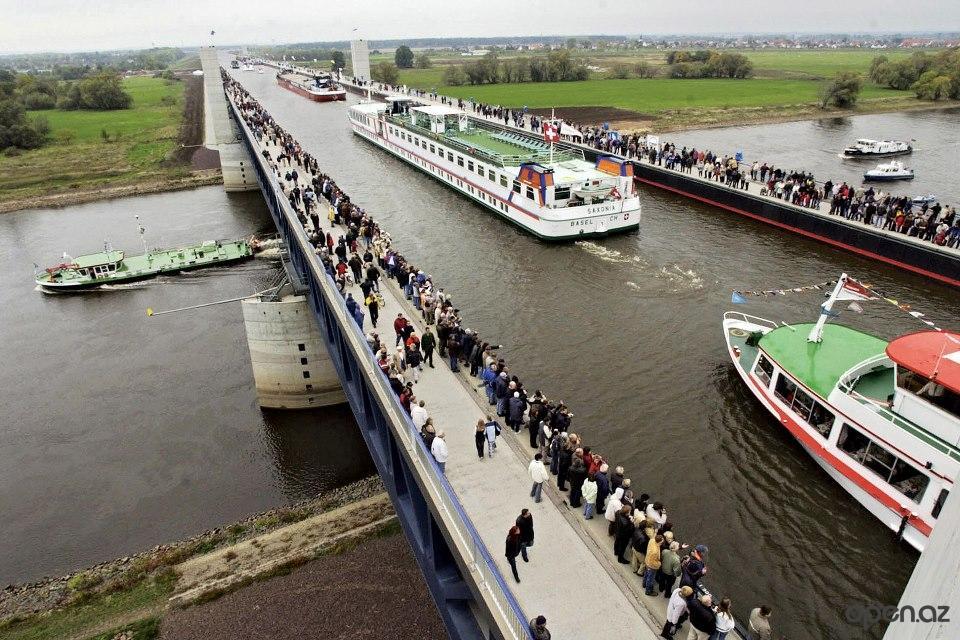
Знаменитый Магдебургский водный мост — впечатляющая демонстрация успешного разрешения конфликта. Корабли движутся по независимым потокам, не мешая друг другу.
Экстремальное программирование предлагает исправлять ошибки по мере их обнаружения, не останавливая разработку. И вообще, программировать надо без ошибок.Классный метод, мне нравится, но, к сожалению, разработчики всё равно программируют с ошибками. Интересно, почемузачем? Надо будет спросить при случае. В общем, пробки в этом случае не возникает, но какое-то количество аварий / досадных ошибок неизбежно просачивается в релиз. Если стоимость исправления просочившейся ошибки невелика, то этот подход вполне оправдан.
Но для программного обеспечения марсохода я бы его рекомендовать не стал.
Другая крайность — это классический Waterfall, который призывает не смешивать одно с другим. Сначала все спроектировать, потом аккуратно реализовать, внимательно протестировать, исправить ошибки и результат передать заказчику.
Подход довольно разумный с точки зрения оптимизации затрат, но часто не очень эффективный в условиях неопределенности. При создании новых продуктов часто нет возможности достоверно узнать, что и как должно быть реализовано. Многое делается «на пробу» и переделывается впоследствии. При последовательном прохождении по фазам от идеи до её проверки проходит слишком много времени.
Продвигаясь по проторенному пути, полному проб и ошибок, мне кажется, нам удалось найти разумный компромисс между этими двумя крайностями – обеспечить гибкость, необходимую при разработке новых продуктов, и при этом сохранить высокий уровень качества. В этой статье я хотел бы поделиться нашим опытом, может, кому-то он будет полезен.
Сначала мы попробовали работать короткими итерациями, в результате которых получается работающая, протестированная версия. Ограниченный скоуп итерации помогает команде сконцентрироваться и не отвлекаться. Чтобы успеть устранить все шероховатости к финишу итерации, принято закладывать некоторое время на стабилизацию кода. В это время серьезные изменения в код не вносятся, только исправляются ошибки.
Период стабилизации необходим, он ограничивает количество изменений в коде и делает процесс сходящимся. На практике оказалось, что значительная часть команды в это время скучает: ошибок на всех не хватает. Конечно, всегда есть работа и за пределами итерации, но вносить изменения нельзя — идет стабилизация. А в начале следующей итерации скучают в ожидании новых ошибок тестировщики… Руководство, видя что что работники простаивают, грозится перевести их на другие проекты.
Следующим шагом стала попытка работать по Канбан-методике. Задачи идут непрерывным потоком, после завершения каждой задачи получается версия. Но надежду на качество разрушает основной закон органической химии: если смешать бочку меда и ложку дерьма — получится бочка дерьма. Ситуацию могло бы спасти полное тестирование версии после каждой задачи, но это оказалось слишком дорого как по трудозатратам, так и по времени.
Казалось бы, ситуация безвыходная… Но кто сказал, что изменения нужно вносить туда же, где идет стабилизация?
Сейчас мы работаем по модели «трех уровней нестабильности»:
- Ветка разработки — слабо контролируемая стабильность. Здесь делаются задачи «на будущее», которые не войдут в текущий релиз.
- Ветка релиза — контролируемое снижение нестабильности. Набор изменений, который будет реализован в этой ветке, ограничен и довольно жестко зафиксирован.
- Стабильная версия — зафиксированное в какой-то момент состояние с допустимым уровнем качества. Изменения вносятся крайне редко и очень небольшие (хотфиксы)
Из продуктового бэклога мы набираем задач на релиз таким образом, чтобы сделать за месяц. Это наш текущий спринт. Команда приступает к реализации релиза, а ближе к его окончанию, когда изменений немного и работы на всех не хватает, начинаются плавные подготовительные работы к следующему спринту. Работы ведутся в отдельной ветке в гите, в отдельном разделе канбан-доски в Джире. Когда скоуп текущего релиза завершен, протестирован и стабилизирован, ветка релиза становится стабильной, ветка разработки становится базовой для следующего спринта, а ветка разработки замирает в ожидании окончания следующего спринта.
Позвольте, скажет кто-то, но тогда в ветке разработки нет актуальных правок. Да и с ошибками неудобно, их приходится править в двух ветках сразу. Чтобы таких проблем не было, мы договорились любую работу в ветке разработки предварять вливанием изменений из релизной ветки. После этой процедуры ветка разработки содержит все актуальные наработки и исправления ошибок.
Изменения из ветки разработки не попадают в релизную до окончания стабилизации. Это даёт возможность завершить релиз и передать стабильную версию в отдел продаж. А перед началом следующего релиза все наработки попадают в релизную ветку.
Теперь у нас есть непрерывный поток задач и неблокирующая процедура стабилизации релиза, которая позволяет нам выпускать качественные версии, не прекращая разработки.
Следующая точка приложения усилий — сокращение срока стабилизации для уменьшения разрыва между ветками и сокращения общего времени TimeToMarket.
Мы же всё протестировали, откуда баги на проде? Разбор от QA с 10+ годами опыта
Это сообщение в рабочем мессенджере, пожалуй, самый страшный сон тестировщика.
Почему они всё-таки могут просочиться на прод? Каков порядок действий? Расскажу коммьюнити dev.by.
Кто пишет: Александра Ерёмина, QA Lead Engineer с опытом работы на 40+ проектах, преподаватель и автор блога «Всё о тестировании и QA».
Если вы хотите поделится необычными практиками, которые вы используете в работе с коммьюнити, пишите на [email protected] .
Дисклеймер. В этой статье рассматриваем ситуации, когда:
- В команде есть тестировщик/QA-специалиста.
- Тестировщик — не стажёр/джун (или джун, но помимо него, в команде тестирования есть еще тестировщики уровня middle и/или выше).
- В команде есть договоренность о том, что тестирование проводится до релиза на прод.
Автоматизация тестирования и баги, связанные с ней, в этот обзор включаться не будут.
Команда решила зарелизить новый или изменить существующий функционал, не поставив в известность тестировщиков
Резонный вопрос: как в принципе это может случиться и кому в здравом уме и трезвой памяти такое может прийти в голову? Ответ: и может, и приходит.
Я не сталкивалась с такими ситуациями на крупных серьёзных проектах в аутсорсе. Проблема больше характерна для стартапов, где не всегда сильные проджект- и продакт-менеджеры, и процессы зачастую отсутствуют или саботируются в силу разных причин.
В одном из таких стартапов я столкнулась с подобной ситуацией. Придя в понедельник на работу, я случайно узнала, что в выходные на проде был обнаружен критичнейший баг: когда пользователь выводил деньги на свой кошелек, с его баланса в нашем приложении эта сумма списывалась. Но на кошелек поступала сумма в 2 раза больше.
Как так могло получиться? Ведь мы ничего нового не релизили, а эта проверка входит в смоук-тест и успешно была пройдена при прошлом релизе. Откуда баг?
Выяснилось, что релиз всё-таки был. Проджект-менеджер договорился с командой разработки залить его на прод в обход команды тестирования.
Команда разработки делала рефакторинг кода. По договоренности с проджект-менеджером задача под это в Jira не заводилась и на общих дейликах это не озвучивалось. Разработчики самостоятельно провели тестирование и подтвердили, что всё работает. В пятницу вечером, по окончании рабочего дня новый код выкатили на прод.
А в субботу утром выяснились две новости.
Хорошая: в приложении произошел внезапный прирост новых пользователей, которые не только успели пополнить свои балансы в приложении, но и опробовали вывод денег с баланса на кошелёк.
Плохая: почему-то при этом в кошельке компании баланс уменьшился на пятизначную сумму. В долларах. И продолжает быстро уменьшаться.
В результате вывод денег заморозили, часть средств компании удалось вернуть, а дев-лид все выходные провел на работе.
На мой вопрос «А зачем вы это сделали?» был ответ: «Если бы мы вам [тестировщикам] сказали о релизе, вы бы его тестили, еще бы и регрессию сделали, нашли баги, релиз бы затормозился, мы бы потеряли время»…
Здесь хочу всем напомнить: задача тестировщика — зарепортать найденные баги, предоставить объективную и подкрепленную фактами информацию о текущем качестве фич/приложения.
Но не тестировщик решает:
- какой приоритет у багов;
- какие баги и в какие сроки должны быть пофикшены;
- может ли фича уйти в релиз с текущими багами или нет.
Это ответственность менеджера, не тестировщика.
Выводы:
- заранее информировать о фичах в релизе всю команду;
- регулярно обновлять статус этих фич;
- если тестирование фичи завершено со статусом «Failed» из-за найденных багов, то «уполномоченное лицо» должно аппрувнуть, какие из багов должны быть пофикшены до релиза, а какие могут быть отложены или отменены;
- регулярно обсуждать и обновлять приоритет/статус багов, найденных в релизных фичах;
- спорные вопросы (например, если тестировщик считает, что продакт-менеджер недооценил критичность бага) должны быть обсуждены на отдельном митинге с привлечением необходимых лиц (например, ВА, дев-лида и т. д.).
Решение о внесении изменений было сделано уже после завершения тестирования
Похожа на предыдущую. Разница в том, что тестировщики об изменениях узнают, когда времени на перепроверку уже не остается. Такая ситуация приключилась со мной на одном из проектов.
Релизили абсолютно новый функционал — менеджер задач. Работали над ним несколько месяцев. Все стори (больше 10) были протестированы, регрессия почти завершена. Релиз запланирован на послезавтра. И под конец регрессии абсолютно случайно замечаю, что одна из новых фич в статусе «Ready for Release» работает неправильно. А именно — находится в том состоянии, в котором нам ее впервые когда-то передали в тестирование: те же баги, функционал нерабочий и к релизу не готов.
Оказалось, что продакт-менеджер попросил разработчиков немного поправить внешний вид одного из полей ввода задачи. Поправили, залили, проверили. И выяснили, что допустили ошибку. Тогда, чтобы не задерживать релиз и не затевать тестирование, решили откатить это последнее изменение. Откатили, снова перепроверили: поле ввода задачи выглядело и работало, как раньше. Тестировщикам ничего говорить не стали.
Но, видимо что-то перепутали: в результате заодно откатились и изменения за последние несколько дней в других фичах. И никто этого не заметил.
Выводы:
- Код фриз (code freeze) — замораживание любых изменений на тестовом окружении, где уже проводится тестирование.
- Нужно обсуждать любые изменения и обязательно ставить в известность команду тестирования.
Баг обнаружен на окружении (браузер, ОС, девайс, разрешение экрана и т. д.), на котором тестирование не проводилось
На одном из крупных проектов я спросила про окружение. Lead Product Manager сбросил список браузеров, ОС и девайсов и даже указал приоритеты окружений.
Но, наблюдая за отчетами службы саппорта, я заметила, что в них довольно часто фигурировали баги, которые не воспроизводились на нашем тестовом окружении. Я решила уточнить, когда последний раз обновлялся список тестового окружения. Оказалось — почти 3 года назад.
Выяснилось, что, например, через десктопный браузер Mozilla FF (под Windows) в нашем приложении работает менее 2% пользователей. А этот браузер по приоритету у нас значился вторым после Google Chrome! Почти 15% юзеров пользовались приложением через мобильный браузер Safari, который вообще не входил в тестовое окружение.
Список тестового окружения актуализировали. С тех пор баги от пользователей мобильного браузера Safari нам больше не приходили.
Выводы:
- На новом проекте всегда спрашивайте про окружение, почему оно выбрано и когда список последний раз актуализировался.
Если заранее оговоренного тестового окружения нет (или на проекте нет продакт-менеджера), попросите того, кто отвечает за развитие продукта, это окружение вам предоставить. В крайнем случае составьте такой список сами и согласуйте с тем, кто отвечает за развитие продукта. - Уточняйте, на каком окружении обнаружен баг и насколько это популярно у пользователей.
- Если список тестового окружения большой и/или текущий проектный треугольник не позволяет постоянно проводить тестирование на всём запланированном окружении, то выберите 2-3 наиболее приоритетных. Остальные окружения вынесите в регулярно проводимую отдельную регрессию (например, 1 окружение 1 раз в месяц или реже).
Баг был обнаружен в той части функционала, которая не была покрыта тестами
Как-то меня попросили подключиться к проекту, где скопилась большая очередь задач на тестирование (больше 1000 задач на 2 тестировщика) и нужно было помочь коллегам эту очередь «расчистить».
На мой вопрос, как так получилось, мне рассказали предысторию.
Жил да был крупный европейский заказчик с интернет-магазином в 20+ странах. И нанял он подрядчика на разработку и поддержку этого интернет-магазина. А подрядчик нанял нашу компанию на работу в shadow mode. Наши тестировщики работали хорошо, а команда ВА+dev подрядчика — не очень, поэтому багов в каждой фиче находилось очень много.
И в какой-то момент европейский заказчик задал вопрос: «А почему это у нас зарепортано так много багов? У нас что, плохие разработчики?»
Подрядчик задумался, да и придумал: сократить количество багов можно… (барабанная дробь) сократив часть команды тестирования.
Но количество новых фич осталось прежним. Пришлось отказаться от глубокого и широкого тестового покрытия.
Плюсы: по результатам тестирования зарепортанных багов теперь, действительно, резко стало меньше.
Минусы: зато теперь больше багов стали находить пользователи. На проде.
А «бонусом» проектная команда получила еще и bottleneck в тестировании новых фич. И теперь уже к тестированию пришлось подключать самих разработчиков. Естественно, качество тестирования таких фич стало еще хуже.
И вот уже европейский заказчик пришёл с новым вопросом: «А как так получается, что у нас выросло количество багов на проде?»
Подрядчик снова задумался… и вот так на проекте временно появилась я.
Выводы:
- Заранее и честно информируйте проджект-менеджера и команду о том, в какие реальные сроки может быть протестирован принятый скоуп задач при широком и глубоком тестовом покрытии.
Если сроки и скоуп меняться не будут, то:
- Согласуйте, насколько глубоко и широко можно успеть протестировать все фичи за утвержденный срок силами текущей команды тестирования. Например, будет проведен только смоук-тест, а тест критического пути и расширенное тестирование проводиться не будут.
Чек-лист проверок нужно пошарить на всех ключевых членов команды: проджект-менеджер, продакт-менеджер/ВА, лида команды разработки, — и попросить их в течение какого-то разумного срока указать те критичные проверки, которые необходимо добавить вместо существующих (или в дополнение к ним). И согласовать, иначе ваш чек-лист будет считаться аппрувнутым по умолчанию. - Если первый вариант не подходит, согласуйте, какие именно фичи целиком может проверить команда тестирования, а тестирование каких фич целиком могут взять на себя другие члены проектной команды.
- Если на проектах постоянно не хватает рук, то имеет смысл написать краткую тест-стратегию и зафиксировать в ней договоренность о глубине/ширине тестирования, а также о том, кто будет в нем участвовать.
- Если на проекте ведётся детализированная документация, можно всей командой тестировать одну фичу. Например, смоук-тест проводят разработчики, тест критического пути — QA, а расширенное тестирование — BA.
Тестовые данные отличаются от реальных данных с прода
История из жизни. И снова крупный заказчик. На этот раз в сфере консалтинга. Приложение работает с огромными массивами данных ритейл-компаний.
Понимая, что данные могут быть весьма специфичными, согласовываем с заказчиком возможность генерации похожих данных. Заказчик соглашается и предоставляет данные, по его словам, похожие на данные с прода (к проду команда доступа не имела).
После каждого релиза с прода приходят баги, которые не воспроизводятся на точно таком же тестовом окружении. Анализируем, оказывается, что проблема в данных: на проде они реальные и поэтому образуют такие комбинации, существование которых команда просто не может предугадать. Не говоря уже об их проверке при разработке и тестировании.
Заказчику были предложены варианты:
- Передать для тестирования данные с прода, изменив или удалив информацию о компаниях, датах и прочую информацию, по которой можно было бы «вычислить» компании, людей, счета и т. д.
- Дать доступ к проду хотя бы кому-то из команды разработки и/или тестирования (даже с подписанием дополнительного договора о неразглашении).
- Включить в команду представителя компании-заказчика, который мог бы проверять тестовые сценарии на предмет добавления дополнительных проверок исходя из возможных особенностей в текущих продовских данных.
Заказчик отверг все варианты. Понимая причину появления багов на проде, заказчик согласился, что эти баги допустимые и будут исправляться по мере фидбэка от пользователей.
Мы по мере обнаружения новых багов обновляли и дополняли свои тестовые данные. Приблизительно через полгода количество багов, которые обнаруживали пользователи на проде из-за разницы между сгенерированными и реальными данными, существенно уменьшилось.
Выводы:
- Всегда согласовывайте с продакт-менеджером или другим лицом, отвечающим за развитие продукта, откуда команда может брать данные для тестирования и разработки; насколько они соответствуют реальным бизнес- и пользовательским данным и какие специфичные наборы данных могут быть в реальности.
- По мере обнаружения багов, связанных с разницей в данных на тестовом стенде и проде, обновляйте и дополняйте свои тестовые данные, а также добавляйте чек-проверки или тест-кейсы для них.
Этот список неполный, моя коллекция причин состоит из примерно 20 пунктов. Если статья понравится коммьюнити dev.by, с удовольствием напишу продолжение.
Делитесь в комментариях, почему же баги могут возникать на проде.
Первоначально этот текст был опубликован на habr.ru. Публикуем его с незначительными изменениями.
Мнение автора может не совпадать с мнением редакции.
dev.by, как и другим честным медиа, сегодня очень сложно: редакция работает за пределами страны, а наши рекламные доходы сократились в несколько раз. Но мы справляемся — с вашей помощью. Это вы делитесь с нами инфоповодами, мнениями, опытом, временем и вниманием. А 220 читателей поддерживают нас донатами.
В 2023 году мы хотим собрать 1000 читателей-подписчиков.
Что ещё почитать про тестирование:
- Тестирование — это не «простая точка входа в ИТ». Мифы разрушает Артём Русов;
- Как научиться тестировать самому и найти работу в трудные времена;
- Найдёт код, сымитирует собес, поможет с английским. 19 нейросеток для учёбы и работы (не ChatGPT);