В чём разница LVM и Динамический LVM?
При установке CentOS возник вопрос, какие бонусы нам даёт динамический LVM в отличии от обычного? Сам LVM том в последствии используется для всех папок кроме boot и другая группа томов под виртуалки.
Hi ★
04.09.15 11:51:18 MSK
Если речь про thin provisioning, то не резервируется место для тома, он растет по мере наполнения даными. Но, вроде как, это экспериментальный режим работы lvm.
King_Carlo ★★★★★
( 04.09.15 11:54:27 MSK )
Ответ на: комментарий от King_Carlo 04.09.15 11:54:27 MSK
Еще скорость записи на тонкие снимки гораздо выше чем на обычные.
anonymous
( 04.09.15 12:22:40 MSK )
Ответ на: комментарий от anonymous 04.09.15 12:22:40 MSK
Да, с активными снапшотами быстро работает. Но, я бы не рискнул пользоваться экспериментальными технологиями.
King_Carlo ★★★★★
( 04.09.15 12:35:35 MSK )
Ответ на: комментарий от King_Carlo 04.09.15 12:35:35 MSK
Решил посмотреть на Динамический LVM, отпишу как полёт в эту тему.
Hi ★
( 04.09.15 13:17:32 MSK ) автор топика
24 января 2016 г.
Ответ на: комментарий от Hi 04.09.15 13:17:32 MSK
И как полёт? Заинтересовался этой темой. Нужны не замедляющие работу снапшоты, сейчас пользуюсь где-то btrfs, где-то zol. Вроде пишут что thin snapshot на lvm стали не такими тормозами, как были у простого LVM. За счет чего ускорение, пока не пойму, если уровень LVM ничего не знает об фс.
Viper ★
( 24.01.16 22:18:55 MSK )
Ответ на: комментарий от Viper 24.01.16 22:18:55 MSK
На десктопе разницы работоспособности не заметил. На серваке использую обычный lvm.
LVM — это просто!
Собственно, хочется просто и доступно рассказать про такую замечательную вещь как Logical Volume Management или Управление Логическими Томами.
Поскольку уже давно пользуюсь LVM-ом, расскажу что он значит именно для меня, не подглядывая в мануалы и не выдёргивая цитаты из wiki, своими словами, чтобы было понятно именно тем кто ничего о нем не знает. Постараюсь сразу не рассказывать о всяческих «продвинутых» функциях типа страйпов, снапшотов и т.п.
LVM — это дополнительный слой абстракции от железа, позволяющий собрать кучи разнородных дисков в один, и затем снова разбить этот один именно так как нам хочется.
есть 3 уровня абстракции:
1. PV (Physical Volume) — физические тома (это могут быть разделы или целые «неразбитые» диски)
2. VG (Volume Group) — группа томов (объединяем физические тома (PV) в группу, создаём единый диск, который будем дальше разбивать так, как нам хочется)
3. LV (Logical Volume) — логические разделы, собственно раздел нашего нового «единого диска» ака Группы Томов, который мы потом форматируем и используем как обычный раздел, обычного жёсткого диска.
это пожалуй вся теория. 🙂 теперь практика:
для работы нужны пакеты lvm2 и возможность работать с привелегиями root поэтому:
$ sudo bash
# apt-get install lvm2
допустим у нас в компе есть жёсткий диск на 40Гб и нам удалось наскрести немного денег и наконец-то купить себе ТЕРАБАЙТНИК! :))) Система уже стоит и работает, и первый диск разбит одним разделом (/dev/sda1 как / ), второй — самый большой, который мы только подключили — вообще не разбит /dev/sdb…
Предлагаю немножко разгрузить корневой диск, а заодно ускорить (новый диск работает быстрее старого) и «обезопасить» систему с помощью lvm.
Можно делать на втором диске разделы и добавлять их в группы томов (если нам нужно несколько групп томов),
а можно вообще не делать на диске разделы и всё устройство сделать физическим разделом (PV)
root@ws:~# pvcreate /dev/sdb
Physical volume «/dev/sdb» successfully created
Создаём группу томов с говорящим названием, например по имени машины «ws», чтобы когда мы перетащим данный диск на другую машину небыло конфликтов с именами групп томов:
root@ws:~# vgcreate ws /dev/sdb
Volume group «vg0» successfully created
желательно внести с корневого раздела такие папки как /usr /var /tmp /home, чтобы не дефрагментировать лишний раз корневой раздел и ни в коем случае его не переполнить, поэтому создаём разделы:
root@ws:~# lvcreate -n usr -L10G ws # здесь мы создаём раздел с именем «usr», размером 10Gb
Logical volume «usr» created
по аналогии делаем то же для /var, /tmp, /home:
root@ws:~# lvcreate -n var -L10G ws
root@ws:~# lvcreate -n tmp -L2G ws
root@ws:~# lvcreate -n home -L500G ws
у нас ещё осталось немного свободного места в группе томов (например для будущего раздела под бэкап)
посмотреть сколько именно можно командой:
root@ws:~# vgdisplay
информацию по созданным логическим томам
root@ws:~# lvdisplay
информацию по физическим томам
root@ws:~# pvdisplay
разделы что мы создали появятся в папке /dev/[имя_vg]/, точнее там будут ссылки на файлы,
lrwxrwxrwx 1 root root 22 2009-08-10 18:35 swap -> /dev/mapper/ws-swap
lrwxrwxrwx 1 root root 21 2009-08-10 18:35 tmp -> /dev/mapper/ws-tmp
lrwxrwxrwx 1 root root 21 2009-08-10 18:35 usr -> /dev/mapper/ws-usr
lrwxrwxrwx 1 root root 21 2009-08-10 18:35 var -> /dev/mapper/ws-var
и т.д…
дальше lvm уже почти кончается… форматируем наши разделы в любимые файловые системы:
root@ws:~# mkfs.ext2 -L tmp /dev/ws/tmp
root@ws:~# mkfs.ext4 -L usr /dev/ws/usr
root@ws:~# mkfs.ext4 -L var /dev/ws/var
root@ws:~# mkfs.ext4 -L home /dev/ws/home
кстати, не плохо было бы сделать раздел подкачки:
root@ws:~# lvcreate -n swap -L2G ws
root@ws:~# mkswap -L swap /dev/ws/swap
root@ws:~# swapon /dev/ws/swap
создаём папку и подключая по очереди новообразовавшиеся тома, копируем в них нужное содержимое:
root@ws:~# mkdir /mnt/target
root@ws:~# mount /dev/ws/home /mnt/target
копируем туда всё из папки /home своим любимым файловым менеджером (с сохранением прав доступа), например так ;):
root@ws:~# cp -a /home/* /mnt/target/
root@ws:~# umount /mnt/target/
кстати, для папки temp необходимо только поправить права, копировать туда что-либо необязательно:
root@ws:~# mount /dev/ws/tmp /mnt/target && chmod -R a+rwx /mnt/target && umount /mnt/target/
добавляем нужные строчки в /etc/fstab, например такие:
/dev/mapper/ws-home /home ext4 relatime 0 2
/dev/mapper/ws-tmp /tmp ext2 noatime 0 2
/dev/mapper/ws-swap none swap sw 0 0
и перезагружаемся… (продвинутые господа могут обойтись без перезагрузки ;))
На вкусное, хочу предложить более продвинутую штуку:
допустим у нас есть система с разделом на LVM, а жёсткий диск начал сбоить, тогда мы можем без перезагрузки переместить всю систему на другой жёсткий диск/раздел:
# On-line добавление/удаление жёстких дисков с помощью LVM (пример)
root@ws:~# pvcreate /dev/sda1 # наш эмулятор сбойного диска
Physical volume «/dev/sda1» successfully created
root@ws:~# pvcreate /dev/sdb1 # наш эмулятор спасательного диска
Physical volume «/dev/sdb1» successfully created
root@ws:~# vgcreate vg0 /dev/sda1 # создаю группу томов vg0
Volume group «vg0» successfully created
root@ws:~# lvcreate -n test -L10G vg0 #создаю раздел для «важной» инфы
Logical volume «test» created
root@ws:~# mkfs.ext2 /dev/vg0/test # создаю файловую систему на разделе
root@ws:~# mount /dev/mapper/vg0-test /mnt/tmp/ #монтирую раздел
… # заполняю его информацией, открываю на нем несколько файлов и т.п.
root@ws:~# vgextend vg0 /dev/sdb1 # расширяю нашу групу томов на «спасательный» диск
Volume group «vg0» successfully extended
root@work:~# pvmove /dev/sda1 /dev/sdb1 #передвигаю содержимое с «умирающего» диска на «спасательный»
/dev/sda1: Moved: 0.9%
/dev/sda1: Moved: 1.8%
…
/dev/sda1: Moved: 99.7%
/dev/sda1: Moved: 100.0%
root@work:~# vgreduce vg0 /dev/sda1 # убираю «умирающий» диск из группы томов.
Removed «/dev/sda1» from volume group «vg0»
Итого:
Я создал логический раздел, отформатировал его, примонтировал и заполнил нужными данными, затем переместил его с одного устройства на другое, при этом раздел остался примонтирован и данные всё время оставались доступны!
Подобным образом мне удавалось без перезагрузки перенести всю систему с умирающего диска на рэид-массив. 🙂
А это моя любимая ссылка по LVM: xgu.ru/wiki/LVM
P.S. Прошу простить за опечатки, меня постоянно отвлекали =))
P.P.S. Ах, да. Самое главное и самый большой минус LVM — он не читается grub’ом
поэтому раздел /boot должен находиться вне LVM на отдельном разделе жёсткого диска,
иначе система не загрузится.
Создание СХД с томами «тонкой» настройки на базе дистрибутива Linux
The concept creating a thin provisioning of data storage on based distribution Linux. The «Thin provisioning» is a popular creation technology for the data storage. The concept of «thin provisioning» is based on «over-allocation» or «over-subscription» mechanism of dynamically allocated data blocks in a two-level model data storage. On the first level a thin pool is formed which includes the «data pool» and «meta pool». The second level consists of virtual volumes for the user space. The full size of virtual volumes can be several times large than the capacity of the thin pool. In the Linux distribution the «Device mapper» module exists acting as a provider of a thin volumes data storage. You can use the «dmsetup» utility or «Logical Volume Management 2» (LVM2) to create and manage the thin provisioning data storage pool and the virtual volumes.
Общее описание, модель хранения данных, основные переменные, пример расчета для СХД с томами «тонкой» настройки на базе дистрибутива Linux.
Тома с «тонкой» настройкой 1 или «подготовкой» (thin provisioning) это виртуальная абстракция устройства хранения данных с заранее определенными параметрами, но имеющим изначально относительно небольшой размер и поддерживающим технологию динамического распределения блоков для хранения данных из общего хранилища.
Они широко применяются в системах хранения данных (СХД) и виртуализации для эффективного использования доступного дискового пространства между пользователями ресурсов с учетом их потребностей.
Данное решение базируется на концепции избыточного распределения, и разработанных на ее основе технологий и механизмов для создания СХД с использованием виртуальной абстракции устройства (файл или блочное устройство).
При этом, формат файла, как виртуальной абстракции устройства хранения данных, содержит в себе полную структуру и содержимое сходную с форматом жёсткого диска, а его размер может быть фиксированным (определено максимальное его значение) или динамическим (размер файла изменяется по мере его заполнения данными до максимального заданного значения).
Если в качестве виртуальной абстракции используется блочное устройство, то, может использоваться одноуровневая или двухуровневая модель хранения данных.
При одноуровневой модели создается виртуальное блочное устройство большой емкости, при начальной инициализации содержащий небольшое количество блоков для хранения данных, дополнительные блоки добавляются из хранилища по мере необходимости (максимальное количество блоков которое может быт добавлено в устройство определяется переменной).
При двухуровневой модели (рисунок 1) создаются две виртуальные абстракции: общий пул хранения данных и виртуальные логические тома для пользователей.
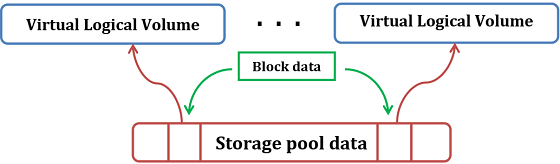
Рисунок 1. Двухуровневая модель.
Распределением блоков для хранения данных из общего пула между виртуальными логическими томами управляет программа-менеджер. В случае необходимости новые блоки для хранения данных добавляются в общий пул, и в автоматическом режиме распределяются между виртуальными логическими томами, исключая необходимость проводить дополнительные манипуляции с ними (например, изменения размера файловой системы). При этом реальный размер каждого виртуального логического томам может превосходить суммарный объем общего пула хранения данных.
В ядре Linux абстракции виртуальных блочных устройств реализуются с помощью модуля «Device mapper» 2 , а начиная с версии ядра 3.2 в него добавлена поддержка динамического выделения места в хранилище данных (thin provisioning) с возможностью реализации двухуровневой модели хранения данных.
При создании СХД с использование томов с «тонкой» настройкой (thin provisioning) 3 на базе дистрибутива Linux необходимо учитывать версию ядра, возможности поддержки требуемого функционала с помощью дополнительных модулей, и расширения общего пула хранения данных с учетом возрастающих потребностей.
Типовая структурная схема включает в себя два основных компонента: пул устройств (или том с “тонкой” настройкой thin pool) объединяющий вместе том метаданных (meta pool) и том данных (data pool) и виртуальные тома (virtual volume) для пространства пользователя. В случае использования менеджера логических томов LVM2 4 , создание пулов томов с “тонкой” настройкой (thin pool) осуществляется в пределах одной Volume Group (VG) (рисунок 2).
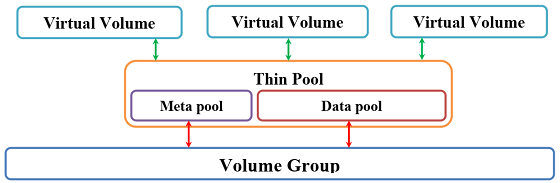
Рисунок 2. Типовая структурная схема СХД с томами “тонкой” настройки
При этом несмотря на это ограничение использование LVM2 более предпочтительно так как позволяет использовать дополнительные возможности:
- подключение внешнего хранилища, доступного в режиме только для чтения в качестве основы для создания типовых LVM -разделов, при котором все обращения на чтение не изменённых данных прозрачно транслируются к базовому эталонному хранилищу, а все изменённые или новые данные обрабатываются в отдельном слое в режиме чтения-записи;
- поддержку динамической агрегации метаданных при помощи демона lvmetad;
- поддержку технологии LVM Cache для общих пулов хранения данных;
- работы со снапшотами.
Перед созданием СХД необходимо определить параметры каждого виртуального тома, их суммарный общий объем (переменная $data_dev_size_max), текущий доступный объем для тома данных (переменная $data_dev_size), возможность использования дополнительных накопителей для тома с метаданными (включая возможность резервирования), выбрать программу-менеджер для управления и используя формулы приведенные ниже определить значения ключевых переменных, при этом, для утилиты dmsetup модуля «Device mapper» все значения указываются в количестве блоков, для LVM2 в байтах или других представлениях единиц измерений.
Размер виртуальных томов (virtual volume)
Размер виртуальных томов (virtual volume) для пространства пользователей определяет администратор на основании технического задания или иных предпочтений, однако, при этом суммарный размер виртуальных томов не должен превышать предельно допустимые физические параметры системы хранения данных в целом, в случае необходимости должна быть реализована возможность их расширения с учетом возрастающих потребностей.
Размер фрагмента выделения (chunk size)
$data_block_size=$dev_min_block_size * $count_block, где
$dev_min_block_size – минимальный размер блока данных на устройстве, как правило, это значение равно 512 байт.
$count_block – количество блоков данных которые можно использовать при раздаче, как правило от 128 до 2097152 для обычных томов данных, для сложной структуры 128, для снапшотов от 8 до 1048576.
Размер тома с метаданными
$metadata_dev_size = 48 * $data_dev_size_max / $data_block_size, где
$data_dev_size_max – полный размер тома данных;
$data_block_size – размер фрагмента выделения.
При этом необходимо учитывать, что размер тома для хранения метаданных не может быть меньше 2Мб, и больше 16Гб, рекомендуемое значение по умолчанию 1Гб. Если по итогам расчетов размер тома для хранения метаданных превышает значение 16Гб, рекомендуется создавать несколько пулов хранения данных.
К размещению метаданных тонких томов стоит относится аккуратно, так как, если данное пространство будет исчерпано, то пул будет выдавать ошибки ввода-вывода до тех пор, пока пул не будет переведен в автономный режим, и не будет выполнено восстановление для устранения потенциальных несоответствий. Поэтому, рекомендуется для пространства метаданных использовать отдельное выделенное устройство или несколько устройств с возможностью резервирования (например, объединить их в raid 1), а для повышения производительности использовать твердотельные накопители.
Определение значения переменной $low_water_mark
$low_water_mark = $count_block_sign_error * $data_block_size,
$count_block_sign_error — значение количества свободных блоков в пуле данных при достижении которого выдать сигнал об исчерпании места;
$data_block_size — текущее значение размера блока распределения.
Значение переменной $count_block_sign_error определяется системным администратором исходя из размера пула и критичности его оперативного расширения. Значение переменной $low_water_mark используется для генерации однократного сигнала предупреждения при достижении низкого уровня свободного места в пуле хранения данных.
После выполнения расчета и анализа результатов, если необходимо провести корректировку значения $data_dev_size, определить устройства для хранения данных и метаданных и выполнить первичную сборку и настройку СХД.
Условие:
Необходимо создать хранилище данных для 100 виртуальных машин с томами размером по 50GB для каждой, при наличии физического дискового пространства в 200GB и одного накопителя sdd емкостью 128GB.
- Определим значение переменной $data_dev_size_max:
$data_dev_size_max=100*50*1073741824=5 368 709 120 000 байт - Определим значение переменной $data_dev_size, установив его значение в 98% от максимально возможного (рекомендовано):
$data_dev_size=(200*1073741824)*0.98=210 453 397 504 байт - Определим размер фрагмента выделения значением по умолчанию в 128 блоков по 512 байт:
$data_block_size = 128 * 512 =65 536 байт - Определим размер тома для хранения метаданных:
$metadata_dev_size = 48 * 5 368 709 120 000/65 536 = 3 932 160 000 байт или примерно 3,67GB - Повторим предыдущие два вычисления, изменив исходные данные.
Определим размер фрагмента выделения значением в 256 блоков по 512 байт:
$data_block_size = 256 * 512 = 131 072 байт
Определим размер тома для хранения метаданных:
$metadata_dev_size = 48 * 5 368 709 120 000/131 072 = 1 966 080 000 байт или примерно 1,83GB
Как видно, чем больше размер фрагмента выделения, тем меньше будет необходим том для хранения метаданных. - Определим значения переменной $low_water_mark, установив, ее значение равной 1024 блока:
$low_water_mark = 1024 * 131 072 = 134 217 728 байт или примерно 128МБ
Если это значение критично, то может его увеличить, например до 65 536 блоков:
$low_water_mark = 65 536 * 131 072 = 8 589 934 592 байт или примерно 8ГБ. - Сопоставим полученные результаты с исходными данными и выберем оптимальный вариант для создания пула с “тонкой” настройкой.
Ссылки
4 Logical Volume Manager 2 (LVM2) LVM2
Abstract licensed under Creative Commons Attribution-ShareAlike 3.0 license
Динамический lvm linux что это
LVM — (Logical Volume Manager — менеджер логических дисков) средство гибкого управления дисковым пространством. Позволяет динамически менять размер логических разделов на лету, создавать снимки (снапшоты) и т.д.
- 1 Дисклеймер/отмазка
- 2 Зачем нужен LVM
- 3 Терминология
- 4 Примечание по названиям утилит LVM
- 5 Создание
- 6 Увеличение логических томов
- 7 Уменьшение логических томов
- 8 Увеличение и уменьшение группы томов
- 9 Снапшоты/Снимки
- 10 Замена сбойного диска в RAID
- 11 Известные ошибки
- 11.1 Persistent log is not supported on segment-by-segment mirroring
Дисклеймер/отмазка
LVM это ОЧЕНЬ(. ) мощный инструмент, который требует аккуратного с собой обращения. Любая самодеятельность с ним может обернуться потерей всей(. ) информации на диске. Поэтому прежде, чем использовать LVM на рабочих машинах (и уж тем более на «боевых» серверах), следует потренироваться на кошках. Лучше всего это делать на виртуальных машинах. Начинать использовать LVM следует ТОЛЬКО (и только. ) тогда, как почувствуете уверенность и понимание принципов его работы.
Зачем нужен LVM
Установка системы прямо на разделы диска зачастую приводит к следующей проблеме. Нужно каким-то образом «правильно» разбить жесткий диск. Слово «правильно» стоит в кавычках, потому что «правильного» разбиения диска для всех возможных ситуаций и применений не существует. В сети есть много советов по данному поводу, но они не учитывают потребностей конкретного пользователя (в случае настольной системы) или конкретного администратора (в случае сервера). Обычно рекомендуют разделы /home, /var, /usr, какие-то еще выносить на отдельные разделы диска. Но если разбивающий ошибется в размерах этих разделов, возникает очень нехорошая ситуация — на одних разделах место подходит к концу, в то время как на остальных места еще много. Приехали! Дисковое пространство нужно переразмечать. Для этого есть много способов:
- Тотальный backup, затем переустановка системы с переразбиением диска.
- Переразметка с помощью parted с риском потерять данные.
- Изначальная установка системы на LVM, который позволяет изменять размеры своих разделов прямо на работающей системе.
Терминология
LVM предусматривает три логических уровня работы с дисковым пространством:
1. Самый нижний — физические тома (physical volumes). Это собственно физические диски. Это могут быть диски целиком (/dev/sda, /dev/sdb и т.д.) или отдельные разделы (/dev/sda1, /dev/sdb5 и т.п.).
2. Группы томов — volume groups. В группы томов объединяются физические тома. Таким образом группы томов представляют собой пул дискового пространства, необходимый для следующего уровня. Группы томов могут иметь человеческие названия, говорящие администратору системы об их предназначении: system, sales, database и т.д.
3. Логические тома (logical volumes) — это аналог разделов физического диска и то, ради чего вообще существуют диски — именно на них хранятся данные. Пользователи (и процессы) системы работают только с логическими томами. Таким образом LVM создает для них всех слой абстракции, скрывая, с какими именно физическими дисками они в данный момент работают. Администратор системы может добавлять физические тома в LVM и удалять их из него (см. ниже), но процессы (и пользователи) об этом знать не будут.
Примечание по названиям утилит LVM
Следует запомнить сразу — названия утилит для работы с разными уровнями LVM совпадают. Различие только в первых двух буквах этого названия. Это:
- pv* — для работы с физическими томами;
- vg* — для работы с группами томов;
- lv* — для работы с логическими томами.
Не стоит также пытаться зазубрить названия этих утилит и их ключи. Действовать стоит так:
1. Думаете, с каким уровнем LVM надо работать — физические тома, группы томов или логические тома.
2. Выбираете в зависимости от этого первые буквы названия: pv, vg или lv, соответственно.
3. Набираете их в консоли и нажимаете два раза TAB. Срабатывает автодополнение, которое показывает команды, начинающиеся с указанных букв.
4. Выбираете команду по ее названию, например, pvcreate для создания физических томов. Если вы ее запустите с ключом --help , она вам покажет все возможные ключи. За более подробной информацией стоит залезть в man конкретной команды.
По мере набора опыта работы с LVM нужда в такой последовательности отпадет. Необходимые команды и их опции запомнятся сами собой.
Создание
Я буду рассматривать создание LVM на уже установленной системе. Знание терминологии и принципов работы с ним в дальнейшем позволит найти в инсталляторе нужные пункты для создания логических томов на этапе установки системы.
Первый этап — это создание правильных разделов. Это такие разделы, которые LVM признает за свои и сможет при загрузке их корректно инициализировать. В случае таблицы разделов MBR «родной» тип разделов для LVM — 8E «Linux LVM». В случае LVM версии 1 все, что будет дальше, не будет работать, если при создании разделов не указать приведенный корректный тип. Если используете таблицу разделов GPT, в parted задайте разделу флаг «lvm».
Вообще говоря, можно использовать в качестве физического тома неразмеченный диск. LVM2 распознаёт физические тома LVM по сигнатуре. Это сэкономит мегабайт на диске. Несмотря на это, имеет смысл создать таблицу разделов и в ней раздел с типом или флагом lvm, чтобы не ошибиться самому в дальнейшем: диск, целиком использованный для физического тома LVM, можно случайно принять за пустой. (Но всегда можно проверить это командой file -s /dev/sd? или pvscan.) Кроме того, если LVM используется в виртуальной машине, диск, полностью занятый PV LVM, будет виден программам LVM в хост-системе, что не всегда приемлемо.
Итак, создаем несколько разделов типа 8E с помощью любимого средства разбиения диска:
[root@localhost ~]# fdisk -l /dev/sdb Disk /dev/sdb: 2147 MB, 2147483648 bytes 255 heads, 63 sectors/track, 261 cylinders Units = cylinders of 16065 * 512 = 8225280 bytes Sector size (logical/physical): 512 bytes / 512 bytes I/O size (minimum/optimal): 512 bytes / 512 bytes Disk identifier: 0x00000000
Device Boot Start End Blocks Id System /dev/sdb1 1 61 489951 8e Linux LVM /dev/sdb2 62 261 1606500 5 Extended /dev/sdb5 62 122 489951 8e Linux LVM /dev/sdb6 123 261 1116486 8e Linux LVM
Еще раз. Пример я привожу с виртуальной машины, чего и вам советую на этапе обучения.
Я создал три раздела для работы с LVM. Сколько их создавать и какого размера решает сам администратор. Например, никто не мешает отдать целиком весь диск (/dev/sdb в данном случае) под власть LVM. В том, как это сейчас сделал я, смысла искать не стоит :). Мой пример преследует только цели демонстрации работы с LVM.
ВНИМАНИЕ! Форматировать созданные разделы НЕ надо! Иначе программа pvcreate откажется записывать свои метаданные на том.
Следующее, что мы должны сделать — это инициализировать созданные разделы как физические тома:
[root@localhost ~]# pvcreate /dev/sdb1 Physical volume "/dev/sdb1" successfully created [root@localhost ~]# pvcreate /dev/sdb5 Physical volume "/dev/sdb5" successfully created [root@localhost ~]# pvcreate /dev/sdb6 Physical volume "/dev/sdb6" successfully created
Если нет сообщений об ошибках, можно смело шагать вперед.
Следующий шаг — это создание группы томов. Делается это командой vgcreate (еще раз подчеркиваю похожесть названия утилит для работы с LVM). Самое трудное тут — это придумать имя группы томов, которое будет отражать ее назначение:
[root@localhost ~]# vgcreate fileserver /dev/sdb1 /dev/sdb5 Volume group "fileserver" successfully created
Аргументы vgcreate это название группы томов (fileserver) и те физические тома, которые мы включаем в эту группу. В данном случае я включил в нее только /dev/sdb1 и /dev/sdb5, что нам и покажет утилита pvscan:
[root@localhost ~]# pvscan PV /dev/sdb1 VG fileserver lvm2 [476.00 MiB / 476.00 MiB free] PV /dev/sdb5 VG fileserver lvm2 [476.00 MiB / 476.00 MiB free] PV /dev/sdb6 lvm2 [1.06 GiB]
Здесь мы видим созданные нами физические тома, их размер и к какой группе томов они относятся. Последний физический том (/dev/sdb6) у нас пока сам по себе. Для обнаружения наличия групп томов LVM (это нужно, например, если вы загрузились с Live CD, который не активирует LVM по умолчанию) есть аналогичная команда — vgscan:
[root@localhost ~]# vgscan Reading all physical volumes. This may take a while. Found volume group "fileserver" using metadata type lvm2
Активировать неработающий LVM можно командой vgchange -ay:
[root@localhost ~]# vgchange -ay 0 logical volume(s) in volume group "fileserver" now active
Это все для того же примера с LiveCD. Сейчас это делать было не обязательно. Вывод приведенной команды показывает наличие отсутствия логических томов, значит сейчас самое время создать их :). Для создания логических томов используется команда lvcreate:
[root@localhost ~]# lvcreate -L 300M -n samba fileserver Logical volume "samba" created
Вуаля! Вы только что создали свой первый логический том. Синтаксис команды прост до безобразия:
- ключ -L указывает размер создаваемого тома. Поддерживаются суффиксы K (килобайты), M (мегабайты), G (гигабайты);
- ключ -n указывает название для тома (samba в данном случае);
- последний аргумент fileserver указывает группу томов, в которой мы создаем логический том (теоретически, групп может быть несколько).
Что важно — логические тома именуются системой следующим образом: /dev/имя_группы_томов/имя_тома. В действительности это симлинк, удобный для адресации устройства — он ссылается на что-то вроде /dev/dm-11, номер в котором может отличаться после перезагрузки. Очевидно, что /dev/группа/том гораздо нагляднее и предупреждает ошибки.
В нашем примере это:
[root@localhost ~]# lvscan ACTIVE '/dev/fileserver/samba' [300.00 MiB] inherit
Одно только это — хороший аргумент для использования LVM. Ведь не надо помнить что находится на /dev/sda3, /dev/sdb5 и т. п. Имена логических томов имеют вполне человеческое название (если их правильно назвать).
Еще несколько замечаний. В группе томов можно создать столько томов, сколько будет нужно. Но не больше, чем есть дискового пространства в этой группе томов. Посмотреть, сколько его у нас есть (и самое главное сколько его еще осталось) можно командой vgdisplay:
[root@localhost ~]# vgdisplay fileserver --- Volume group --- VG Name fileserver System ID Format lvm2 Metadata Areas 2 Metadata Sequence No 2 VG Access read/write VG Status resizable MAX LV 0 Cur LV 1 Open LV 0 Max PV 0 Cur PV 2 Act PV 2 VG Size 952.00 MB PE Size 4.00 MB Total PE 238 Alloc PE / Size 75 / 300.00 MB Free PE / Size 163 / 652.00 MB VG UUID SZLgLK-b9V8-RiZV-gH5i-N0pA-2ppf-axLqfO
Сейчас для нас тут самое ценное — это VG Size 952.00 MB (общий размер дискового пространства группы томов), Alloc PE / Size 75 / 300.00 MB (уже выделенное для создания логических томов дисковое пространство), Free PE / Size 163/652.00 MB (свободное и еще не распределенное дисковое пространство — наш резерв).
PE тут — это физические экстенты. Они представляют собой нечто вроде кусков дискового пространства, на которые LVM «нарезает» физические тома. Все размеры логических томов всегда содержат целое число этих физических экстентов и всегда кратны их размеру (как видно из приведенных цифр размер экстента — 4Мб).
Теперь созданный том можно отформатировать и примонтировать:
[root@localhost ~]# mkdir /mnt/data [root@localhost ~]# mkfs.ext4 /dev/fileserver/samba [root@localhost ~]# mount /dev/fileserver/samba /mnt/data/ [root@localhost ~]# df -h Filesystem Size Used Avail Use% Mounted on /dev/mapper/fileserver-samba 291M 11M 266M 4% /mnt/data
Как мы видим, наш логический том готов к использованию!
Увеличение логических томов
Самая мощная возможность LVM — это то, что размеры логических томов можно менять на лету. Правда, чтобы их уменьшить, «полет» придется прервать (об этом ниже), а вот увеличение размеров томов — это практически безопасная операция.
Предположим, что нам перестало хватать места на нашем физическом томе /dev/fileserver/samba.
Последовательность действий такая:
1. Сначала нужно убедиться в наличии необходимого нам дискового пространства в группе томов. Делается это командой vgdisplay. Допустим, мы хотим добавить к нашему логическому тому еще 300 Мб. Как мы видим (см. вывод команды vgdisplay выше), у нас еще достаточно свободного места в группе.
2. Увеличиваем логический том командой lvextend:
[root@localhost ~]# lvextend -L +200M /dev/fileserver/samba Extending logical volume samba to 500.00 MB Logical volume samba successfully resized
Новый размер тома (ключ -L) можно указывать и в относительных единицах (как в примере), и в абсолютных.
3. Если мы теперь посмотрим на вывод команды df -h мы увидим, что пока ничего не изменилось:
[root@localhost ~]# df -h Filesystem Size Used Avail Use% Mounted on /dev/mapper/fileserver-samba 291M 11M 266M 4% /mnt/data
несмотря на то, что lvscan показывает верный размер:
[root@localhost ~]# lvscan ACTIVE '/dev/fileserver/samba' [500.00 MB] inherit
Это произошло потому, что мы увеличили размер логического тома, но пока «забыли» сказать об этом файловой системе, расположенной «этажом выше». Давайте же изменим размер файловой системы. Делается это командной resize2fs (для ext2/ext3/ext4) или resize_reiserfs для одноименной файловой системы:
[root@localhost ~]# resize2fs /dev/fileserver/samba resize2fs 1.41.5 (23-Apr-2009) Filesystem at /dev/fileserver/samba is mounted on /mnt/data; on-line resizing required old desc_blocks = 2, new_desc_blocks = 2 Performing an on-line resize of /dev/fileserver/samba to 512000 (1k) blocks. The filesystem on /dev/fileserver/samba is now 512000 blocks long.
Теперь все правильно:
[root@localhost ~]# df -h Filesystem Size Used Avail Use% Mounted on /dev/mapper/fileserver-samba 485M 11M 450M 3% /mnt/data
Обратите внимание, что все показанное производилось на смонтированной файловой системе. То есть, все операции не требуют остановки серверов, приостановки работы пользователей и т.п.
Уменьшение логических томов
Уменьшение размера логического тома уже не такая тривиальная операция. Она требует специального подхода, четкой последовательности действий и размонтирования файловой системы (по крайней мере на момент написания).
ВНИМАНИЕ! Шаги 2 и 3 очень часто путают местами, что приводит к потере данных, хранящихся на логическом томе.
Делается это все так:
1. Размонтируем файловую систему: umount /dev/fileserver/samba
2. Уменьшаем размер файловой системы. Для этого сначала сделаем проверку самой файловой системы. Утилита resize2fs не даст изменить размер до выполнения проверки. Конечно, у нее есть ключ -f, который заставит ее это сделать, но лучше перестраховаться и все-таки выполнить проверку:
[root@localhost ~]# fsck.ext4 -f /dev/fileserver/samba e2fsck 1.41.5 (23-Apr-2009) Pass 1: Checking inodes, blocks, and sizes Pass 2: Checking directory structure Pass 3: Checking directory connectivity Pass 4: Checking reference counts Pass 5: Checking group summary information /dev/fileserver/samba: 11/127512 files (0.0% non-contiguous), 26603/512000 blocks [root@localhost ~]# resize2fs /dev/fileserver/samba 300M resize2fs 1.41.5 (23-Apr-2009) Resizing the filesystem on /dev/fileserver/samba to 307200 (1k) blocks. The filesystem on /dev/fileserver/samba is now 307200 blocks long
3. ТОЛЬКО после корректного выполнения двух предыдущих шагов уменьшаем размер логического тома:
[root@localhost ~]# lvreduce -L 300M /dev/fileserver/samba WARNING: Reducing active logical volume to 300.00 MB THIS MAY DESTROY YOUR DATA (filesystem etc.) Do you really want to reduce samba? [y/n]: y Reducing logical volume samba to 300.00 MB Logical volume samba successfully resized
В качестве размера тома (ключ -L), как и в случае с lvextend можно указывать и абсолютные и относительные единицы. Здесь мы также видим страшное предупреждение о потере данных. Несмотря на это (если вы не используете тестовые версии программ), ваши данные будут в целости и сохранности (скорее всего 🙂 , 100% гарантии вам все равно никто не даст).
После этого монтируем файловую систему и смотрим что поменялось:
[root@localhost ~]# mount /dev/fileserver/samba /mnt/data/ [root@localhost ~]# df -h Filesystem Size Used Avail Use% Mounted on /dev/mapper/fileserver-samba 291M 11M 266M 4% /mnt/data
Итак, если вы все делаете в указанной последовательности, вашим данным скорее всего ничего не грозит. Но лучше перед уменьшением тома все-таки сделать его резервную копию. Я сам многократно уменьшал физические тома без каких-либо потерь данных, но наличие резервной копии — это наличие резервной копии :).
Увеличение и уменьшение группы томов
Следующая возможность LVM — это возможность дополнять группу томов новыми физическими томами (например, если уже не хватает имеющихся) и выводить из группы не нужные больше физические тома (например, скорая поломка диска или замена оборудования). Лично я видел на форумах, что некоторые таким образом даже переносят работающую систему с одного диска на другой.
Давайте вернемся к нашему примеру. Допустим нам перестало хватать места в нашей группе томов и мы ее хотим дополнить новыми физическими томами. Делается это командой vgextend:
[root@localhost ~]# vgextend fileserver /dev/sdb6 Volume group "fileserver" successfully extended [root@localhost ~]# vgdisplay fileserver --- Volume group --- VG Name fileserver System ID Format lvm2 Metadata Areas 3 Metadata Sequence No 5 VG Access read/write VG Status resizable MAX LV 0 Cur LV 1 Open LV 1 Max PV 0 Cur PV 3 Act PV 3 VG Size 1.99 GB PE Size 4.00 MB Total PE 510 Alloc PE / Size 75 / 300.00 MB Free PE / Size 435 / 1.70 GB VG UUID SZLgLK-b9V8-RiZV-gH5i-N0pA-2ppf-axLqfO
Как мы видим (выделено), пул дискового пространства, которым мы располагаем, увеличился. Теперь его тоже можно использовать для увеличения существующих логических томов данной группы и для создания новых.
Следующая операция, которую тоже можно делать с LVM — это уменьшение группы томов. Прежде чем вывести физический том из группы — его необходимо освободить от данных. Первое, что тут следует сделать в данном случае — это убедиться, что дискового пространства, которое останется в группе, хватит для размещения этих данных. Разработчики LVM пока не владеют методами размещения данных в астральном пространстве, но работа над этим ведется :). Итак, посмотреть это можно командой pvscan:
[root@localhost ~]# pvscan PV /dev/sdb1 VG fileserver lvm2 [476.00 MB / 176.00 MB free] PV /dev/sdb5 VG fileserver lvm2 [476.00 MB / 476.00 MB free] PV /dev/sdb6 VG fileserver lvm2 [1.06 GB / 1.06 GB free]
Здесь мы видим, что реально сейчас используется только первый физический том — /dev/sdb1. И еще мы тут видим один интересный аспект работы LVM: если какой-то логический том можно разместить на отдельном физическом целиком — LVM выберет именно этот путь. Кстати, под словом free команда pvscan подразумевает не свободное от данных пространство, а пространство не выделенное в логические тома. Итак, для освобождения физических томов от данных и размещения их на других физических томах той же группы есть команда pvmove:
[root@localhost ~]# pvmove /dev/sdb1 /dev/sdb1: Moved: 100.0%
По умолчанию данная программа требует только одного аргумента — имени освобождаемого тома. Также ей можно указать (вторым аргументом) имя тома, на который нужно поместить данные.
В случае, когда на физическом томе располагаются части зеркального логического тома, обязательно указывайте, на какой физический их нужно переместить, иначе может оказаться, что все «зеркала» окажутся на одном физическом томе.
Вывод команды pvscan теперь выглядит вот так:
[root@localhost ~]# pvscan PV /dev/sdb1 VG fileserver lvm2 [476.00 MB / 476.00 MB free] PV /dev/sdb5 VG fileserver lvm2 [476.00 MB / 476.00 MB free] PV /dev/sdb6 VG fileserver lvm2 [1.06 GB / 788.00 MB free]
Как мы видим, теперь наш логический том «уехал» на другой раздел диска. Причем этот том смонтирован и с ним в этот момент могут работать пользователи.
Убрать освобожденный том из группы можно командой vgreduce:
[root@localhost ~]# vgreduce fileserver /dev/sdb1 Removed "/dev/sdb1" from volume group "fileserver" [root@localhost ~]# pvscan PV /dev/sdb5 VG fileserver lvm2 [476.00 MB / 476.00 MB free] PV /dev/sdb6 VG fileserver lvm2 [1.06 GB / 788.00 MB free] PV /dev/sdb1 lvm2 [478.47 MB]
Теперь мы видим, что наш физический том /dev/sdb1 «осиротел» и больше не принадлежит ни одной группе.
Снапшоты/Снимки
Следующая полезная возможность LVM — это снапшоты или снимки. Снимок — это как бы фотография дискового пространства оригинального тома. После выполнения снимка все изменения, происходящие на томе-оригинале, никак не видны на снимке. Все программы будут продолжать работать с оригинальным томом как ни в чем не бывало.
Сферы применения снапшотов могут быть самыми разнообразными. Например, резервное копирование базы данных. Если не использовать LVM — базу данных необходимо останавливать, копировать ее файлы куда-нибудь для последующего резервного копирования, а затем запускать ее заново. То есть делать это придется в нерабочее время. С LVM все проще — следует сделать снимок раздела с файлами базы данных и уже можно начинать делать резервную копию. Остановка базы данных не нужна, достаточно сделать блокировку всех баз на время создания снапшота (это несколько секунд).
Самая интересная особенность LVM при работе со снимками — это то, что снимок может занимать меньше дискового пространства, чем оригинал. Для этого используется режим Copy-on-Write, при котором реальное использование дискового пространства начинается только при изменении данных на томе-оригинале. То есть при попытке модификации блока на томе-оригинале неизменённый блок сначала сохраняется на томе-снимке, а уж затем модифицируется.
ВНИМАНИЕ! При заполнении тома-снимка до конца, происходит его уничтожение. То есть том продолжает существовать, но ни смонтировать его, ни просмотреть его содержимое (если он был смонтирован до этого) уже не получится. Эту особенность следует обязательно учитывать при задании размера тома-снимка в момент его создания.
Создание снимка делается хорошо известной командой lvcreate:
[root@localhost ~]# lvcreate -s -L 100M -n backup /dev/fileserver/samba Logical volume "backup" created
Ключ -s указывает, что создаем мы именно снапшот, -n указывает имя создаваемого тома, а /dev/fileserver/samba показывает с какого именно тома мы делаем снимок.
Команда lvscan покажет нам, что мы создали снапшот:
[root@localhost ~]# lvscan ACTIVE Original '/dev/fileserver/samba' [300.00 MB] inherit ACTIVE Snapshot '/dev/fileserver/backup' [100.00 MB] inherit
Теперь можете убедиться в том, что изменения, происходящие с оригиналом, никак не повлияют на снапшот.
Замена сбойного диска в RAID
При сбое жесткого диска:
# lvs -a -o +devices Couldn't find device with uuid X0Rlv9-DOJT-3KFg-ejN3-6Rcq-vVD8-gZehkn. LV VG Attr LSize Pool Origin Data% Meta% Move Log Cpy%Sync Convert Devices root_sys vg00 rwi-aor-p- 10,00g 100,00 root_sys_rimage_0(0),root_sys_rimage_1(0) [root_sys_rimage_0] vg00 iwi-a-r-p- 10,00g [unknown](0) [root_sys_rimage_1] vg00 iwi-aor--- 10,00g /dev/sda2(2562) [root_sys_rmeta_0] vg00 ewi-a-r-p- 4,00m [unknown](5121) [root_sys_rmeta_1] vg00 ewi-aor--- 4,00m
Один из способов, в замену сбойного диска, добавить в группу томов ещё одно устройство, по объёму не уступающему размеру зеркала:
#vgextend vg00 /dev/sdb2И выполнить восстановление:
lvconvert --repair /dev/vg00/root_sys
После вывести сбойное устройство из группы томов:
# vgreduce vg00 --removemissingИзвестные ошибки
Persistent log is not supported on segment-by-segment mirroring
LVM до версии 2.02.111 выдаёт ошибку при попытке удалить из группы томов сломавшийся диск, если на нём располагались части зеркального тома RAID1.
Выглядит это так:# pvs PV VG Fmt Attr PSize PFree /dev/sdb3 DATA lvm2 a-- 7,27t 5,31t /dev/sdc3 DATA lvm2 a-- 7,27t 6,27t /dev/sdd3 DATA lvm2 a-- 7,27t 2,19t # vgreduce --removemissing DATA Couldn't find device with uuid 1kelDC-lGQY-VzCf-mZtc-Xmkd-uPbB-WFxSP3. WARNING: Partial LV SRV needs to be repaired or removed. WARNING: Partial LV SRV_rmeta_1 needs to be repaired or removed. WARNING: Partial LV SRV_rimage_1 needs to be repaired or removed. There are still partial LVs in VG DATA. To remove them unconditionally use: vgreduce --removemissing --force. # vgreduce --removemissing --force DATA Couldn't find device with uuid 1kelDC-lGQY-VzCf-mZtc-Xmkd-uPbB-WFxSP3. Persistent log is not supported on segment-by-segment mirroring
В результате с группой томов невозможно ничего сделать.
Исправление этого следующее:
- Сохраняем данные из оставшихся частей зеркальных томов. Все части зеркального тома видны в системе как /dev/ГРУППА/ТОМ_rimage_?, в выводе vgreduce —removemissing видно, какие из них утеряны. Берём оставшуеся часть зеркала и копируем командой dd в новый файл или в раздел того же размера.
- Ставим новый диск на замену неисправного. желательно, чтобы имя устройства было тем же самым.
- В таблице разделов создаём раздел с тем же номером того же размера, что и прежний. Обязательное условие — размер, расположение может отличаться, хотя лучше соблюсти и это условие.
- Форматируем раздел в физический том LVM командой pvcreate —u UUID_старого_тома —restorefile /etc/lvm/archive/дата_до_сбоя_диска.vg РАЗДЕЛ.
Если получим ошибку, используем команду pvcreate —u UUID_старого_тома —norestorefile РАЗДЕЛ. - Добавляем физический том в группу томов командой vgextend —restoremissing ГРУППА РАЗДЕЛ
- Из логических томов удаляем зеркала, расположенные на поддельном физическом томе
- Из группы томов удаляем поддельный физический том.
- Теперь с группой томов можно работать обычным образом.
Полезные советы для работы с LVM
- В руководстве по администрированию RHEL встретился один замечательный совет. При использовании LVM не следует стараться распределить все имеющееся дисковое пространство в логические тома. Гораздо лучше другой путь. При распределении дискового пространства следует сделать это по своему опыту, ориентируясь на минимально необходимые потребности пользователей системы или работающих сервисов. Оставшееся в группе пространство будет «горячим» резервом, который администратор сможет добавить при нехватке места. Как было видно выше — добавление дискового простраства (увеличение логических томов) операция легкая и быстрая, в отличие от уменьшения.
- Избегайте создавать один логический том на разных физических. Соображения такие же, как и для массивов RAID-0: сделав том на нескольких физических дисках, при поломке одного из дисков потеряете всю инфромацию с такого логического тома. Если необходим именно том большего размера, чем физический диск, берите много дисков, создавайте зеркальный том и мониторьте состояние дисков (например, демоном smartd), а при подозрении на скорую поломку заменяйте диск.
Полезные источники:
- СайтXgu.ru
- RHEL6 Logical_Volume_Manager_Administration