Учимся парсить сайты на C#: часть 1
Данная статья первая из цикла «Парсим сайты на C#». В ней мы научимся непосредственно подключаться к выбранному серверу, скачивать страничку, разбирать её исходный код, а также выводить на экран первоначальный результат. Эта программа только для тестов – для реальной работы я рекомендую использовать готовые библиотеки. Однако даже без библиотек, встроенными средствами NET несложно сделать настоящее приложение — парсер для сайтов самостоятельно.
Итак, начнем мы с того, что научимся получать страничку. В данном случае пациентом выступает рейтинг топ лиру, конкретно страница с адресом «https://www.liveinternet.ru/?upread.ru» — именно в этом ареале в настоящий момент обитает мой блог. Эту страницу мы скачиваем, ищем на ней адрес «upread.ru» (парсим) и выводим место, на котором данный сайт находится. На выходе будет примерно такая картинка.
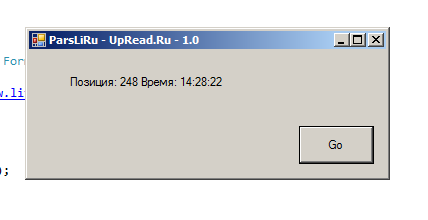
А вот и сам код программы:
using System; using System.Collections.Generic; using System.ComponentModel; using System.Data; using System.Drawing; using System.Linq; using System.Text; using System.Threading.Tasks; using System.Windows.Forms; using System.Net; using System.IO; using System.Text.RegularExpressions; namespace ParsLiRu < public partial class Form1 : Form < string url = "https://www.liveinternet.ru/?upread.ru"; public Form1() < InitializeComponent(); >private void button1_Click(object sender, EventArgs e) < backgroundWorker1.RunWorkerAsync(); >private void backgroundWorker1_DoWork(object sender, DoWorkEventArgs e) < using (WebClient client = new WebClient()) < client.Encoding = System.Text.Encoding.UTF8; ServicePointManager.SecurityProtocol = SecurityProtocolType.Tls12 | SecurityProtocolType.Tls11 | SecurityProtocolType.Tls; var htmlData = client.DownloadData(url); string htmlCode = Encoding.UTF8.GetString(htmlData); var parts1 = Regex.Split(htmlCode, "nick=upread.ru\">"); var parts2 = Regex.Split(parts1[1], " "); int numberPosition = Convert.ToInt32(Regex.Replace(parts2[0], @"[^\d]+", "")); this.Invoke(new MethodInvoker(delegate < label1.Text = Convert.ToString("Позиция: " + numberPosition + " Время: " + System.DateTime.Now.ToLongTimeString()); >)); > > > >
Несколько комментариев по коду выше. В строке 32 создаем WebClient; далее 34 — здесь задается кодировка скачиваемой страницы. В строке 35 включаем поддержку защищенного протокола (https). 37-38 – получаем данные страницы и конвертим их в string, учитывая кодировку.
Сам разбор страницы происходит в строках 40-42 – с помощью регулярных выражений убираем все до вхождения подстроки upread.ru, далее получаем второй элемент массива (сплит по коду пробела) и в конце опять же с помощью регулярок оставляем только число.
Вот так мы создали простейший парсер страниц на си шарп. Повторюсь, что для реальной работы лучше использовать готовые библиотеки. Вот например, Как парсить сайты с помощью CsQuery.
Автор этого материала — я — Пахолков Юрий. Я оказываю услуги по написанию программ на языках Java, C++, C# (а также консультирую по ним) и созданию сайтов. Работаю с сайтами на CMS OpenCart, WordPress, ModX и самописными. Кроме этого, работаю напрямую с JavaScript, PHP, CSS, HTML — то есть могу доработать ваш сайт или помочь с веб-программированием. Пишите сюда.
статьи IT, си шарп, интернет, парсинг
- Как парсить сайты с помощью CsQuery
- Парсинг с CsQuery: время ожидания операции истекло
- Пример парсинга сайта с помощью Java
Оставить комментарий
Отправляя сообщение я подтверждаю, что ознакомлен и согласен с политикой конфиденциальности данного сайта.
unixforum.org
недавно занимаюсь программированием, понадобилось написать парсер html страниц на предмет некой инфы(не ссылок), подскажите с помощью каких библиотек это можно реализовать.
Заранее спасибо!
Спасибо сказали:
luncher Сообщения: 84 ОС: mandriva 2008 spring
Re: парсер html на C++
Сообщение luncher » 12.07.2009 22:56
да и желательно чтобы для этих библиотек была документация нормальная, нето библиотеки нахожу, а документации нету 🙂
Спасибо сказали:
RasenHerz Сообщения: 1341 ОС: Arch Linux amd64
Re: парсер html на C++
Сообщение RasenHerz » 13.07.2009 01:05
ну если надо просто что-то найти в тексте, думаю Qt тут прекрасно подойдет. Именно парсеров(разбор текста) я не знаю — но думаю под конкретные нужды его не составит труда написать.
Спасибо сказали:
luncher Сообщения: 84 ОС: mandriva 2008 spring
Re: парсер html на C++
Сообщение luncher » 13.07.2009 01:31
13.07.2009 01:05
ну если надо просто что-то найти в тексте, думаю Qt тут прекрасно подойдет. Именно парсеров(разбор текста) я не знаю — но думаю под конкретные нужды его не составит труда написать.
есть специальные либы, точно есть, самому трудно такое написать, тем более опыта в этом нет, поэтому и спрашиваю про библиотеки, есть проблема в том, что те что я нашел почти не документированы
Спасибо сказали:
Denjs Сообщения: 1685 ОС: SuSe 10.2
Re: парсер html на C++
Сообщение Denjs » 13.07.2009 04:14
гм. вы можете попытаться проанализировать часть источника заданий в моем OTDP.
он разбирает HTML-подобный исходник и создает из него XML-дерево. (несколько не так как было-бы напрямую из xhtml)
гм. мой парсер тоже несколько недокументирован, но все что есть — то по русски. в исходниках и немногочисленных доках.
Ну ещё я могу что-то подсказать.
. имхо. если знаете что такое машина состояний — там это самое сложное — то разберетесь. Ну ещё может доки по XML-классам в QT надо будет почитать. А остальное все достаточно простое.
Оно конечно там не самого лучшего вида (это было первое что я написал серьезного на QT c сигнал-слотами), но работает.
И на «реальном HTML» я его не гонял. но смотря что вам разбирать — может оно и пригодится.
QDroid — Среда исполнения и фреймворк для QtScript.
OTPD — Открытые драйвера промышленных принтеров чеков и этикеток (кроссплатформенная подсистема печати).
Спасибо сказали:
svary Сообщения: 49 ОС: Linux FC-9
Re: парсер html на C++
Сообщение svary » 13.07.2009 05:59
12.07.2009 22:43
написать парсер html страниц.
Вообще-то в *nix системах давным-давно существуют средства для таких задач.
В первую очередь : flex и jacc/bison :
FLEX(1) User Commands FLEX(1) NAME flex - the fast lexical analyser generator BISON(1) BISON(1) NAME bison - GNU Project parser generator (yacc replacement)ну, если совсем лень разбираться. можно awk попробовать :
GAWK(1) Utility Commands GAWK(1) NAME gawk - pattern scanning and processing languageЭто все утилиты, которые генерируют ИСХОДНЫЙ ТЕКСТ НА С. но, я так понял. что именно это Вам и надо ?
Спасибо сказали:
Portnov Модератор Сообщения: 1786 Статус: Матёрый линуксоид ОС: Debian testing/unstable Контактная информация:
Re: парсер html на C++
Сообщение Portnov » 13.07.2009 08:40
Ну у HTML грамматика довольно сложная, с кучей всяких «опциональных» частей (можно не закрывать многие теги итп), так что писать парсер даже на flex/bison весьма трудоёмко. Знатоки C/C++, неужели для этих языков нет готовых решений этой задачи!?
Для xml (и, соответственно, xhtml) даже я решение знаю — libxml. А для html.
Что-то здесь пошла речь про c/c++, хотя автор не указал, на каком языке пишет. На python, например, есть даже несколько парсеров html, на java афаик тоже.
UPD. Ой, в название темы-то не посмотрел 🙂 Ну ладно, пусть будет c++.
Парсинг сайтов на c#. Часть 1. Использование WebBrowser
Парсинг сайтов — это получение интересующей информации с веб-страниц. Автор попытался сделать пошаговое руководство, начиная с основ парсинга с помощью компонента WebBrowser и заканчивая темами такими как выполнение логина и поддержания сессий через HTTPWebRequest.
Компонент WebBrowser
Этот контрол обеспечивает встроенный полноценный браузер в вашем приложении. Он позволяет пользователю перемещаться по веб-страницам внутри формы.
Пример: WebBrowser Download Event (событие загрузки)
- Добавьте контрол WebBrowser на форму. И выставите свойству Dock значение «Fill»
- Добавьте следующие события и код:
private void webBrowser1_DocumentCompleted(object sender, WebBrowserDocumentCompletedEventArgs e) < this.Text +=" a"; >private void Form1_Load(object sender, EventArgs e) < webBrowser1.Navigate("http://jobtools.ru"); >

List hist = new List(); private void webBrowser1_DocumentCompleted(object sender, WebBrowserDocumentCompletedEventArgs e) < if (hist.Contains(webBrowser1.Url.ToString())) return; this.Text +=" a"; hist.Add(webBrowser1.Url.ToString()); >private void Form1_Load(object sender, EventArgs e) < webBrowser1.Navigate("http://jobtools.ru"); >
Пример: Навигация по сайту
- Перед тем как создавать свой парсер сайтов, кликер-бота и т.п. необходимо разобраться с макетом документа, как искать и находить нужные блоки в документе
- Найдите на странице интересующий вас элемент
- Найдите id этого элемента на странице
HtmlElement he = webBrowser1.Document.GetElementById("menu-item-1469"); HtmlElementCollection hec = he.GetElementsByTagName("a");webBrowser1.Navigate(hec[0].GetAttribute("href"));Пример: Навигация по всем ссылкам на странице
- Для начала мы должны найти и сохранить все ссылки на странице, давайте не все ссылки а только те, что находятся в меню (id=menu-glavnaya). Для этого заведем список из строк, в который будем сохранять все значения атрибута href (сам адрес у ссылки):
List urls = new List();
HtmlElement he = webBrowser1.Document.GetElementById("menu-glavnaya"); HtmlElementCollection hec = he.GetElementsByTagName("a"); foreach (HtmlElement a in hec) < string href = a.GetAttribute("href"); if (href != "http://jobtools.ru") < if (!urls.Contains(href)) urls.Add(href); >>if(urls.Count > 0) < string u = urls[0]; urls.RemoveAt(0); webBrowser1.Navigate(u); this.Text = "Всего ссылок" + urls.Count.ToString(); >else
Пример: Заполняем и отправляем форму входа Yahoo
- Заходим на сайт http://mail.yahoo.com/;
- Находим ID формы ввода логина и пароля;
- Добавляем кнопку на форму и прописываем код в событии onClick
htmlElement hu = webBrowser1.Document.GetElementById("username"); hu.Focus(); hu.SetAttribute("Value","userName"); HtmlElement hp = webBrowser1.Document.GetElementById("passwd"); hp.Focus(); hp.SetAttribute("Value", "password");HtmlElement hf = webBrowser1.Document.GetElementById("login_form"); hf.InvokeMember("submit");Пример: Установка значений для Referrer и User-Agent
webBrowser1.Navigate("url", "_blank", null, "Referrer: sample user agent");Пример: Сохранить все изображения на странице
- Добавьте ссылку using mshtml;
- И используем следующий код, который сохраняет все картинки в папку с программой
IHTMLDocument2 doc = (IHTMLDocument2)webBrowser1.Document.DomDocument; IHTMLControlRange imgRange = (IHTMLControlRange)((HTMLBody)doc.body).createControlRange(); foreach (IHTMLImgElement img in doc.images) < imgRange.add((IHTMLControlElement)img); imgRange.execCommand("Copy", false, null); try< using(Bitmap bmp = (Bitmap)Clipboard.GetDataObject().GetData(DataFormats.Bitmap)) bmp.Save(img.nameProp + ".jpg"); >catch (System.Exception ex) < MessageBox.Show(ex.Message); >>Пример: Разбор капчи используя API DeathByCaptcha
- Подключаем ссылку using DeathByCaptcha;
- Используем следующий код (тут всё просто)
Client client = (Client)new SocketClient(capUser, capPwd); try < Captcha captcha = client.Decode(path + capName, 50); if (null != captcha) < //Captcha Solved MessageBox.Show(captcha.Text); >else < //Captcha Not Solved Show Error Message >> catch(DeathByCaptcha.Exception ex)
Пример: Как задать Proxy для WebServer
using Microsoft.Win32; RegistryKey reg = Registry.CurrentUser.OpenSubKey( "Software\\Microsoft\\Windows\\CurrentVersion\\InternetSettings", true); registry.SetValue("ProxyEnable", 1); registry.SetValue("ProxyServer", "192.168.1.1:9876");8 Replies to “Парсинг сайтов на c#. Часть 1. Использование WebBrowser”
Отличная статья, спасибо пригодилась
Спасибо! Надо добраться до продолжения!
Андрей :Спасибо за статью, пригодилась. Но Вы писали, что можно организовать «…подсчет фреймов на странице совместно с подсчетом количества срабатываний события DocumentCompleted…». Можете описать каким образом это реализовать. Спасибо.
А можете показать пример как парсить статистику сервера с сайта мониторинга по типу Статус Онлайн или в Оффлайн и количество игроков?
Если эта информация выводится на сайте, то это легко, дайте адрес сайта для примера.
Помню в WoW статистику отдавал специальный скрипт на php что ли. Вообщем дайте адрес сайта, а там попробуемgs4u. net/dayzm/217.23.139.34:2302. html пробелы надо убрать
Нужна строчка Статус:Онлайн и строчка играков: 0 из 2//Загружаем страничцу
webBrowser1.Navigate(«http://gs4u.net/dayzm/217.23.139.34:2302.html»); //после загрузки страницы в DocumentCompleted парсим
HtmlElementCollection he = webBrowser1.Document.GetElementsByTagName(«td»);
Label1.Text = he[25].InnerText; выбрали все элементы td на странице, так как в вашем случае id не прописан.
25 элемент td как раз и содержит необходимую Вам информацию. Я перешел на использование php для парсинга страниц, и по сравнению с ним этот вариант в статье очень уж не удобен и ограничен. Быстрее, функциональней делать так как описано в этом примереиспользуя описанные там библиотеки
Добавить комментарий Отменить ответ
Метки
Рубрики
Последние записи
- Использование VFPOLEDB в виде отдельного сервиса WebAPI
- OpenSource проект WebDbfShow
- Как ускорить вставку данных в Excel
- Eloquent в Laravel и название столбца с тире
- Настройка Vue.js в Laravel 6 и старше
Свежие комментарии
- Gerz к записи DBFShow
- Vic58 к записи DBFShow
- Gerz к записи DBFShow
- Alexandr к записи DBFShow
- Gerz к записи DBFShow
Как спарсить любой сайт?

Меня зовут Даниил Охлопков, и я расскажу про свой подход к написанию скриптов, извлекающих данные из интернета: с чего начать, куда смотреть и что использовать.
Написав тонну парсеров, я придумал алгоритм действий, который не только минимизирует затраченное время на разработку, но и увеличивает их живучесть, робастность, масштабируемость.
TL;DR
Чтобы спарсить данные с вебсайта, пробуйте подходы именно в таком порядке:
- Найдите официальное API,
- Найдите XHR запросы в консоли разработчика вашего браузера,
- Найдите сырые JSON в html странице,
- Отрендерите код страницы через автоматизацию браузера,
- Если ничего не подошло — пишите парсеры HTML кода.
Совет профессионалов: не начинайте с BS4/Scrapy
BeautifulSoup4 и Scrapy — популярные инструменты парсинга HTML страниц (и не только!) для Python.
Крутые вебсайты с крутыми продактами делают тонну A/B тестов, чтобы повышать конверсии, вовлеченности и другие бизнес-метрики. Для нас это значит одно: элементы на вебстранице будут меняться и переставляться. В идеальном мире, наш написанный парсер не должен требовать доработки каждую неделю из-за изменений на сайте.
Приходим к выводу, что не надо извлекать данные из HTML тегов раньше времени: разметка страницы может сильно поменяться, а CSS-селекторы и XPath могут не помочь. Используйте другие методы, о которых ниже. ⬇️
Используйте официальный API
�� Ого? Это не очевидно ��? Конечно, очевидно! Но сколько раз было: сидите пилите парсер сайта, а потом БАЦ — нашли поддержку древней RSS-ленты, обширный sitemap.xml или другие интерфейсы для разработчиков. Становится обидно, что поленились и потратили время не туда. Даже если API платный, иногда дешевле договориться с владельцами сайта, чем тратить время на разработку и поддержку.
Sitemap.xml — список страниц сайта, которые точно нужно проиндексировать гуглу. Полезно, если нужно найти все объекты на сайте. Пример: http://techcrunch.com/sitemap.xml
RSS-лента — API, который выдает вам последние посты или новости с сайта. Было раньше популярно, сейчас все реже, но где-то еще есть! Пример: https://habr.com/ru/rss/hubs/all/
Поищите XHR запросы в консоли разработчика

Все современные вебсайты (но не в дарк вебе, лол) используют Javascript, чтобы догружать данные с бекенда. Это позволяет сайтам открываться плавно и скачивать контент постепенно после получения структуры страницы (HTML, скелетон страницы).

Обычно, эти данные запрашиваются джаваскриптом через простые GET/POST запросы. А значит, можно подсмотреть эти запросы, их параметры и заголовки — а потом повторить их у себя в коде! Это делается через консоль разработчика вашего браузера (developer tools).
В итоге, даже не имея официального API, можно воспользоваться красивым и удобным закрытым API. ☺️
Даже если фронт поменяется полностью, этот API с большой вероятностью будет работать. Да, добавятся новые поля, да, возможно, некоторые данные уберут из выдачи. Но структура ответа останется, а значит, ваш парсер почти не изменится.
Алгорим действий такой:

- Открывайте вебстраницу, которую хотите спарсить
- Правой кнопкой -> Inspect (или открыть dev tools как на скрине выше)
- Открывайте вкладку Network и кликайте на фильтр XHR запросов
- Обновляйте страницу, чтобы в логах стали появляться запросы
- Найдите запрос, который запрашивает данные, которые вам нужны
- Копируйте запрос как cURL и переносите его в свой язык программирования для дальнейшей автоматизации.
Вы заметите, что иногда эти XHR запросы включают в себя огромные строки — токены, куки, сессии, которые генерируются фронтендом или бекендом. Не тратьте время на ревёрс фронта, чтобы научить свой парсер генерировать их тоже.
Вместо этого попробуйте просто скопипастить и захардкодить их в своем парсере: очень часто эти строчки валидны 7-30 дней, что может быть окей для ваших задач, а иногда и вообще несколько лет. Или поищите другие XHR запросы, в ответе которых бекенд присылает эти строчки на фронт (обычно это происходит в момент логина на сайт). Если не получилось и без куки/сессий никак, — советую переходить на автоматизацию браузера (Selenium, Puppeteer, Splash — Headless browsers) — об этом ниже.
Поищите JSON в HTML коде страницы
Как было удобно с XHR запросами, да? Ощущение, что ты используешь официальное API. �� Приходит много данных, ты все сохраняешь в базу. Ты счастлив. Ты бог парсинга.
Но тут надо парсить другой сайт, а там нет нужных GET/POST запросов! Ну вот нет и все. И ты думаешь: неужели расчехлять XPath/CSS-selectors? ��♀️ Нет! ��♂️
Чтобы страница хорошо проиндексировалась поисковиками, необходимо, чтобы в HTML коде уже содержалась вся полезная информация: поисковики не рендерят Javascript, довольствуясь только HTML. А значит, где-то в коде должны быть все данные.
Современные SSR-движки (server-side-rendering) оставляют внизу страницы JSON со всеми данные, добавленный бекендом при генерации страницы. Стоп, это же и есть ответ API, который нам нужен! ������
Вот несколько примеров, где такой клад может быть зарыт (не баньте, плиз):

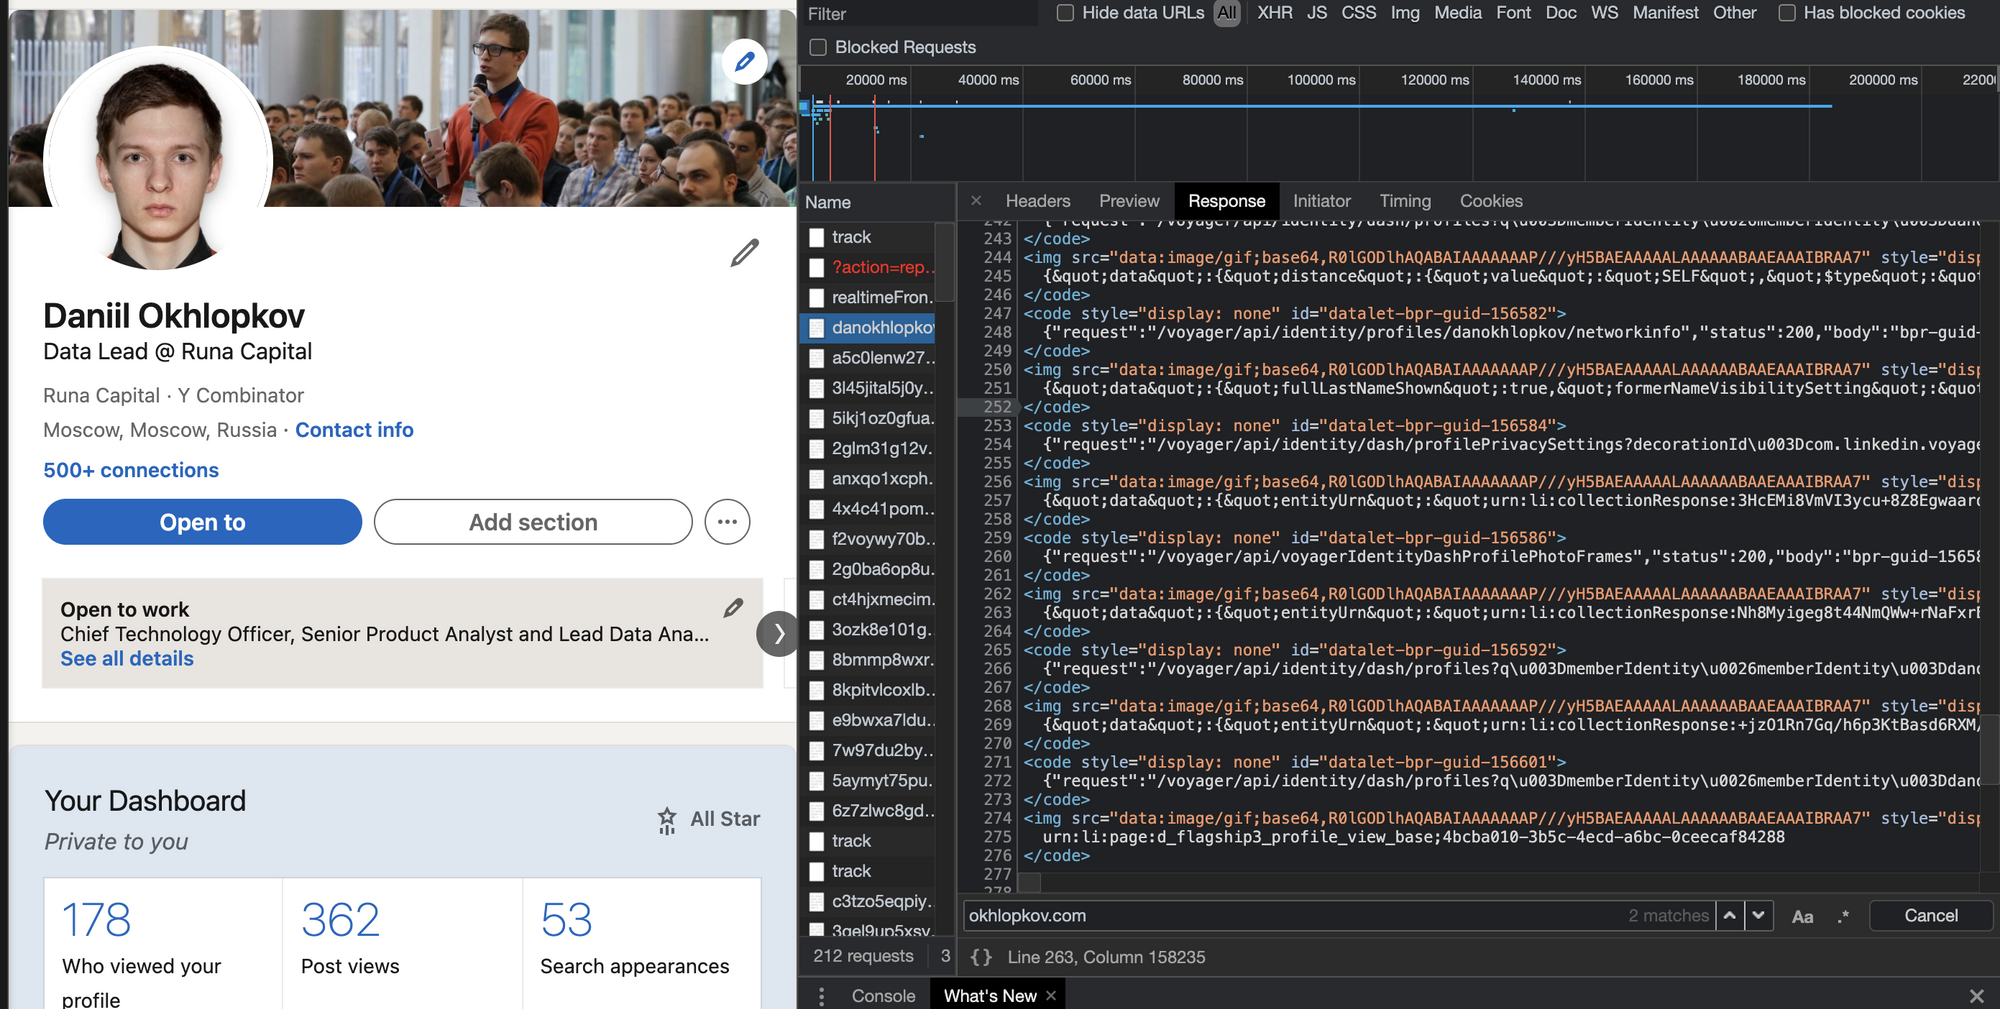
Алгоритм действий такой:
- В dev tools берете самый первый запрос, где браузер запрашивает HTML страницу (не код текущий уже отрендеренной страницы, а именно ответ GET запроса).
- Внизу ищите длинную длинную строчку с данными.
- Если нашли — повторяете у себя в парсере этот GET запрос страницы (без рендеринга headless браузерами). Просто requests.get .
- Вырезаете JSON из HTML любыми костылямии (я использую html.find(«= <") ).
Отрендерите JS через Headless Browsers
Если XHR запросы требуют актуальных tokens, sessions, cookies. Если вы нарываетесь на защиту Cloudflare. Если вам обязательно нужно логиниться на сайте. Если вы просто решили рендерить все, что
движетсязагружается, чтобы минимизировать вероятность бана. Во всех случаях — добро пожаловать в мир автоматизации браузеров!Если коротко, то есть инструменты, которые позволяют управлять браузером: открывать страницы, вводить текст, скроллить, кликать. Конечно же, это все было сделано для того, чтобы автоматизировать тесты веб интерфейса. I’m something of a web QA myself.
После того, как вы открыли страницу, чуть подождали (пока JS сделает все свои 100500 запросов), можно смотреть на HTML страницу опять и поискать там тот заветный JSON со всеми данными.
driver.get(url_to_open) html = driver.page_sourceSelenoid — open-source remote Selenium cluster
Для масштабируемости и простоты, я советую использовать удалённые браузерные кластеры (remote Selenium grid).
Недавно я нашел офигенный опенсорсный микросервис Selenoid, который по факту позволяет вам запускать браузеры не у себя на компе, а на удаленном сервере, подключаясь к нему по API. Несмотря на то, что Support team у них состоит из токсичных разработчиков, их микросервис довольно просто развернуть (советую это делать под VPN, так как по умолчанию никакой authentication в сервис не встроено). Я запускаю их сервис через DigitalOcean 1-Click apps: 1 клик — и у вас уже создался сервер, на котором настроен и запущен кластер Headless браузеров, готовых запускать джаваскрипт!
Вот так я подключаюсь к Selenoid из своего кода: по факту нужно просто указать адрес запущенного Selenoid, но я еще зачем-то передаю кучу параметров бразеру, вдруг вы тоже захотите. На выходе этой функции у меня обычный Selenium driver, который я использую также, как если бы я запускал браузер локально (через файлик chromedriver).
def get_selenoid_driver( enable_vnc=False, browser_name="firefox" ): capabilities = < "browserName": browser_name, "version": "", "enableVNC": enable_vnc, "enableVideo": False, "screenResolution": "1280x1024x24", "sessionTimeout": "3m", # Someone used these params too, let's have them as well "goog:chromeOptions": , "prefs": < "credentials_enable_service": False, "profile.password_manager_enabled": False >, > driver = webdriver.Remote( command_executor=SELENOID_URL, desired_capabilities=capabilities, ) driver.implicitly_wait(10) # wait for the page load no matter what if enable_vnc: print(f"You can view VNC here: ") return driverЗаметьте фложок enableVNC . Верно, вы сможете смотреть видосик с тем, что происходит на удалённом браузере. Всегда приятно наблюдать, как ваш скрипт самостоятельно логинится в Linkedin: он такой молодой, но уже хочет познакомиться с крутыми разработчиками.
Парсите HTML теги
Мой единственный совет: постараться минимизировать число фильтров и условий, чтобы меньше переобучаться на текущей структуре HTML страницы, которая может измениться в следующем A/B тесте.
Даниил Охлопков — Data Lead @ Runa Capital
Подписывайтесь на мой Телеграм канал, где я рассказываю свои истории из парсинга и сливаю датасеты.
Надеюсь, что-то из этого было полезно! Я считаю, что в парсинге важно, с чего ты начинаешь. С чего начать — я рассказал, а дальше ваш ход ��