Где хранит данные ElasticSearch?
Есть задача быстрого поиска данных по разным сущностям. Данных много, по моим подсчётам денормализованная часть этих данных, которая будет храниться в ElasticSearch будет около 30 гб.
Вопрос такой — где ElasticSearch хранит эти данные для быстрого поиска — на жёстком диске или в ОЗУ?
- Вопрос задан более трёх лет назад
- 4635 просмотров
Комментировать
Решения вопроса 1

впишусь в проект как SRE/DevOps.
к слову, не забудьте про ограничение в 31Г на ноду.
Ответ написан более трёх лет назад
Без SQL: учимся работать с данными на Elasticsearch

Elasticsearch — это поисковый и аналитический движок, с помощью которого ваша команда может быстро искать информацию в любых типах данных и анализировать их.
Детям из Мариуполя нужно 120 ноутбуков для обучения — подари старое «железо», пусть оно работает на будущее Украины
Он позволяет управлять релевантностью результатов и проводить масштабирование.
Объемы данных растут все быстрее и быстрее. Их становится сложнее структурировать и выделять полезную информацию. Так реляционные базы данных отходят на задний план, а хранилища и поисковые системы без использования SQL становятся все популярнее.
Elasticsearch — это распределенный механизм на основе архитектуры RESTful. Наряду с Kibana, Beats и Logstash, Elasticsearch — это компонент комплекта приложений Elastic Stack, который дает возможность надежно и безопасно получать данные из любого источника и в любом формате, искать, анализировать и визуализировать данные в режиме реального времени.
С помощью Elasticsearch можно решать многие задачи:
Курс Front-end Basic.
Оволодій навичками розробки веб-інтерфейсів та стань справжнім Front-end розробником! Заробляй від 800$ на початку карʼєри.
- добавить поле поиска на сайт или в приложение;
- хранить и анализировать журналы, метрики;
- автоматически моделировать поведение данных в режиме реального времени с помощью машинного обучения;
- автоматизировать рабочие процессы;
Кроме прочего, нужно сказать, что Elasticsearch — это программное обеспечение с открытым исходным кодом, которое распространяется бесплатно.
Хранение и поиск данных
Документы
Elasticsearch предназначен для работы с большими объемами данных, которые могут быть как структурированными, так и неструктурированными.
Курс Python Pro.
В ході проходження курсу Python Pro Студенти набувають навички вирішення складних завдань за допомогою мови Python.
Он не хранит данные в реляционной БД. Для этого понадобилось бы много разных таблиц и связей между ними. Не говоря уже о том, что при появлении каждого нового типа данных пришлось бы выполнять уйму работы, чтобы внести изменения.
Вместо этого информация хранится в виде сериализованных документов JSON. Этот формат позволяет хранить произвольные структуры данных.
Например, коллекцию сериалов можно представить так:
| В СУБД | В виде объектов |
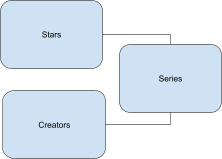 |
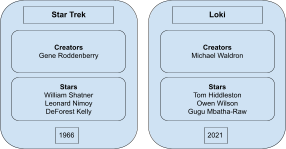 |
В формате JSON эти объекты записываются просто:
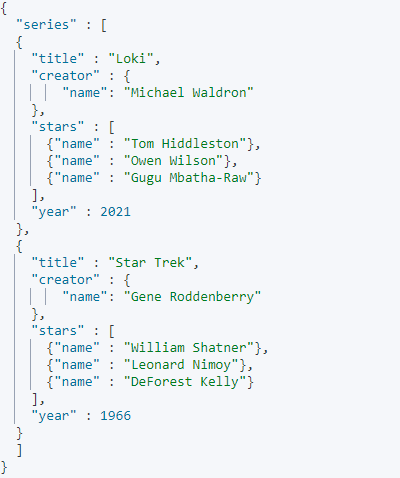
Удобно, что пользователи сами могут определять структуру данных в документах. Из них проще извлекать информацию, и их можно легко менять.
Поиск
В руководстве по Elasticsearch утверждается, что полнотекстовый поиск осуществляется в течение одной секунды. Если Elasticsearch работает с большим объемом данных, как ему удается проводить поиск по всему их тексту в режиме, близкому к реальному времени?
Это возможно благодаря использованию обратного индекса. При индексировании составляется список уникальных слов, встречающихся во всех документах, со ссылками на документы, в которых содержится каждое слово. Поэтому Elasticsearch создан на базе библиотеки для полнотекстового поиска Apache Lucene, в которой используется обратный индекс.
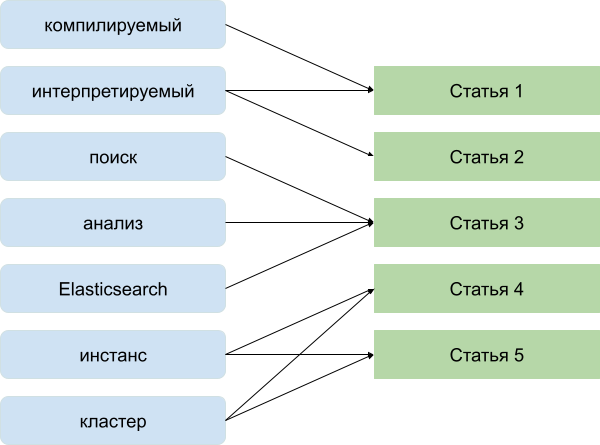
Поиск с помощью Elasticsearch
Elasticsearch не зависит от схем данных. Когда включено динамическое связывание типов, Elasticsearch автоматически выявляет и добавляет в индекс новые поля, распознавая целые и дробные числа, строки, булевские значения и даты.
При необходимости можно определить правила для динамического связывания. Это позволит анализировать текст в зависимости от языка, на котором он написан, использовать пользовательские форматы дат, отличать полнотекстовые строки от строк с точными значениями и распознавать форматы, которые не могут быть распознаны автоматически.
Кроме того, одно и то же поле можно проиндексировать по-разному для разных целей, например, для полнотекстового поиска и в качестве тега.
Индекс
Elasticsearch использует индекс Lucene, который напоминает базу данных: данные находятся в пространстве имен и для их упорядочения используется схема. По своей сути индекс представляет собой логическую группу, состоящую из одного или нескольких физических сегментов (shards), которые являются экземплярами Lucene.
Курс Business English для проджект-менеджерів.
Курс на якому ви здолаєте всі бар’єри кроскультурної комунікації, навчитеся розв’язувати конфлікти, попереджати ризики та ефективно презентувати результати роботи іноземним стейкхолдерам.
В результате распределения документов между сегментами и распределения сегментов между узлами обеспечивается отказоустойчивость, благодаря которой вы защищены от сбоев аппаратного обеспечения.
Давайте сравним Elasticsearch, MongoDB и PostgreSQL с точки зрения возможностей, обеспечиваемых индексом.
| Elasticsearch | MongoDB | PostgreSQL |
| Поисковик | Хранилище документов | База данных |
| Документы JSON со связями (mappings) в индексе | Документы BSON в коллекциях | Данные в таблицах |
| Одна запись, много чтений. Высокая скорость поиска | Высокая эффективность операций, связанных с записью | Высокая эффективность операций, связанных с записью |
| Гибкая схема | Гибкая схема | Схема обязательна, что дает возможность проводить операции, которые иначе было бы невозможно провести |
Если имеется большой объем данных, использование распределенного индекса снижает нагрузку на систему. Она работает не с большим объемом данных, а со сравнительно небольшими индексами.
Поэтому в Elasticsearch предусмотрена возможность регулировать количество сегментов в параметре index.number_of_shards . По умолчанию его значение равно 5, но вы можете изменить его в зависимости от того, сколько сегментов будет участвовать в поиске.
Кроме того, следует учесть, что по мере заполнения данными Elasticsearch объединяет малые сегменты в большие, поэтому нужно следить за тем, чтобы они не становились слишком крупными и не снижали эффективность работы.
Сегменты бывают первичными и реплицированными. Реплицированный сегмент — это копия первичного сегмента. Реплики обеспечивают избыточность и защищают оборудование от сбоев, а также повышают скорость обработки запросов. Вы можете в любой момент изменить количество реплик, но количество первичных сегментов фиксируется на момент создания индекса.
Масштабирование
Elasticsearch — распределенная система. В ней разделены не только индексы. Сегменты хранятся на отдельных машинах, которые называют узлами. В свою очередь, узлы объединяются в кластеры.
Когда нагрузка возрастает, Elasticsearch добавляет узлы в кластер и автоматически распределяет нагрузку между всеми доступными узлами. По мере добавления узлов в кластер растет и скорость выполнения запросов. В результате ваше приложение не перегружается и в то же время обеспечивается его доступность и масштабируемость. Когда же нагрузка спадает, количество узлов уменьшается и нагрузка перераспределяется. Такой вид масштабирования называется горизонтальным.
Кластеры и управление ими
Чтобы получать информацию из распределенной системы, масштаб которой со временем изменяется, нужно определять, когда и к каким сегментам следует обращаться. Поэтому узлы данных объединяются в кластеры, где существуют также координирующие узлы, которые выполняют именно эту функцию.
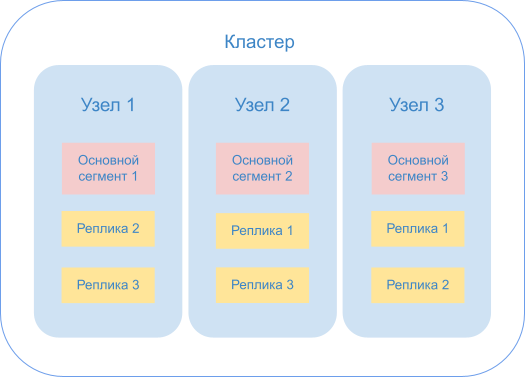
Кластер — это группа узлов с одним и тем же значением атрибута cluster.name . Если запущен один экземпляр Elasticsearch, то кластер состоит из единственного узла. Все первичные узлы находятся на нем, и он готов к использованию. Но создать на нем реплицированные сегменты невозможно, поэтому в случае сбоя могут быть потеряны данные.
Добавление узлов в кластер повышает его емкость и надежность. Когда в кластер добавляется узел, реплицированные сегменты выделяются автоматически, и его отказоустойчивость повышается.
По умолчанию добавляемый узел может быть как узлом данных, так и master-узлом, который управляет кластером. Рекомендуем помещать в кластер небольшое фиксированное количество узлов, которые могут быть выбраны основными ( master-eligible nodes ). Такие узлы отвечают, например, за создание или удаление индекса, отслеживание узлов, которые входят в кластер, и принятие решений о распределении сегментов между узлами. Добавлять же в кластер лучше те узлы данных, которые не могут быть выбраны основными.
Основные узлы обеспечивают управление кластером и позволяют избежать конфликтов между координирующими узлами, например, в случае перемещения сегментов с узла на узел. Поскольку у них есть вся информация о состоянии кластера, таким узлам требуется повышенный объем ресурсов и стабильное оборудование.
Репликация данных
Если данные только в одном экземпляре, то существует возможность их потерять, если откажет узел, на котором они хранятся. Чтобы избежать этого, создаются реплики на других узлах. В отличие от резервных копий — это полные копии всех данных.
Когда используются реплики, запись данных производится сначала в первичный сегмент, а уже после слияния и фиксации в Lucene изменяются все реплики.
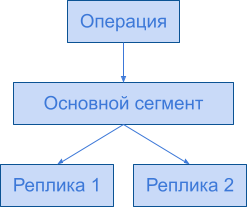
Чтобы не потерять данные, лучше создать реплики
Для обеспечения отказоустойчивости нужно создать реплику каждого сегмента. Общее количество реплик должно быть не меньше количества узлов данных. Тогда при отказе одного узла можно будет пользоваться репликой данных на другом узле во время восстановления поврежденного. Чтобы использовать реплики эффективно, можно указать их количество в параметре number_of_replicas .
Отказоустойчивость
Мы рассмотрели, как обеспечить отказоустойчивость в случае отказа узла данных. Но как обезопасить систему на случай сбоя основного узла? Ведь его потеря приведет к тому, что весь кластер перестанет быть работоспособным.
На этот случай можно создать несколько основных узлов. На роль основного узла могут претендовать узлы, которые могут быть выбраны основными.
Когда отказывает один такой узел, новым основным узлом будет выбран тот, который обладает самой актуальной информацией о кластере. Выбор делается при достижении кворума во время голосования узлов, которые имеют право голоса. Он должен быть нечетным и составлять 50% + 1 голос.
В голосовании участвуют узлы, для которых в конфигурации указано значение параметра node.voting_only: true . Это узлы, которые предназначены только для голосования. Конфигурация голосования изменяется автоматически, и нужно следить за тем, чтобы включенных узлов было не меньше тех, которые составили бы кворум (контрольное количество голосующих).
Взаимодействие
Для взаимодействия с кластером извне и для взаимодействия узлов между собой используются различные протоколы, которые мы сравнили в таблице ниже.
API можно вызывать синхронно и асинхронно.
Частый запуск и остановка клиентов узлов приводит к лишнему «шуму» в кластере.
Также существуют отдельные библиотеки для:
- JavaScript (только поиск для приложений);
- Node.js (поисковый клиент для приложений и рабочего места);
- PHP (только поиск для приложений);
- Python (клиент для корпоративного поиска);
- Ruby (клиент для корпоративного поиска).
Заключение
Эффективность Elasticsearch как поискового движка обеспечивается благодаря обратному индексу и распределению данных. По мере увеличения или уменьшения их объема он удобно масштабируется, вы можете не переживать о потере данных — они надежно защищены с помощью реплик и избыточных узлов.
Elasticsearch — как работает система полнотекстового поиска: плюсы и минусы, альтернативы и лайфхаки
Работая с e-commerce проектами, интернет-магазинами, онлайн-аптеками, маркетплейсами, в конечном счете даже с сайтами знакомств, приходится охватывать большое количество данных и разрабатывать удобный инструмент для поиска. Таким инструментом и является Elasticsearch.
В этой статье расскажем, что такое Elasticsearch и как им пользоваться, рассмотрим его преимущества и недостатки, покажем примеры использования. А также поделимся лайфхаками использования этого инструмента для поиска.
ЧТО ТАКОЕ ELASTICSEARCH
Elasticsearch — это система полнотекстового поиска, написанная на Java. Кроме того, Elasticsearch — это нереляционное хранилище документов в формате JSON, которое выпущено как проект с открытым исходным кодом в соответствии с условиями лицензии Apache.
КАК РАБОТАЕТ
В Elasticsearch отправляются данные в виде документов JSON с помощью API или такого инструмента, как Logstash . Elasticsearch сохраняет документ в индекс кластера и делает его доступным для поиска. После этого можно найти и извлечь документ, используя API Elasticsearch.
ES позволяет производить поиск по документам в режиме реального времени, он горизонтально масштабируется и поддерживает многопоточность. У других NoSQL-систем выигрывает качеством и скоростью обработки текста и гибким полнотекстовым поиском по всей базе документов.
ПОЧЕМУ УДОБНО РАБОТАТЬ С ELASTICSEARCH
В сервисах с большим количеством данных, а именно e-commerce проектах, интернет-магазинах, онлайн-аптеках, маркетплейсах, сайтах знакомств, поиск — это фасеты. Фасеты — это условия для поиска, например, набор тегов или фильтр по значениям.
Работая с большим объемом данных, мы сталкиваемся со стандартной схемой данных для типичного e-commerce в СУБД, и выглядит она примерно так:
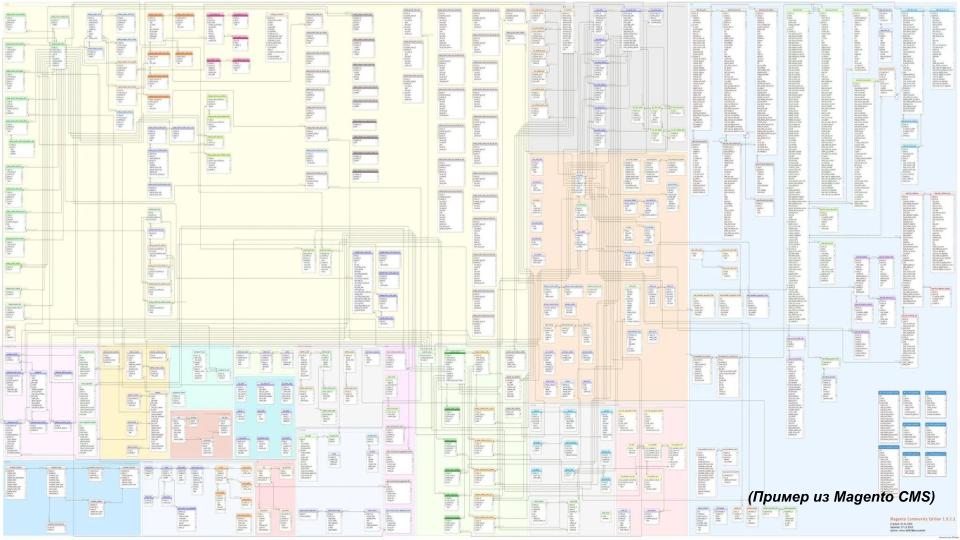
В такой CMS-системе хранятся товары, свойства, категории, свойства категорий и категории свойств, а также много связей и сущностей. Данных слишком много. И для того, чтобы все нормально структурировать, нам нужен инструмент для поиска.
АЛЬТЕРНАТИВЫ ELASTICSEARCH
Перед тем, как начать работать с Elasticsearch, рассмотрим альтернативные СУБД, которые могут помочь сделать поиск удобным — MongoDB и PostgreSQL.
MongoDB:
- Нет схем, то есть не нужно заморачиваться о структуре данных, вносим всё, что угодно;
- Web scale — при повышении нагрузки масштабирование делается очень легко как по горизонтали, так и по вертикали;
- Отсутствует аналог конструкции JOIN, а это значит, что мы не тратим время на соединение таблиц, в документе уже все есть;
- Вся валидация делается в коде. Если вы откроете любое руководство, вы увидите, что сначала ставят драйвер для MongoDB, а только потом библиотеку валидаций;
- Нет аналогов хранимых процедур. Опять же — все в коде.
PostgreSQL:
- Есть нереляционное хранилище в формате JSON, можно назначать ограничения на поля. Например, есть таблица пользователя, у пользователя есть персональные данные, надо ввести на них ограничения. JSON отлично справится с этим;
- Наличие TextSearch функций, которые обеспечивают работу полнотекстового поиска;
- Есть хранимые процедуры;
- Большое количество таблиц/столбцов/индексов;
- Не все ORM понимают JSON.
Используя MongoDB и PostgreSQL для полнотекстового поиска, мы получим ограниченную функциональность. В некоторых случаях её будет достаточно, но для полноценного удобства предлагаем использовать Elasticsearch (далее — ES). У него также есть свои плюсы и минусы.
ПРЕИМУЩЕСТВА
- Для общения с Elasticsearch используется RESTful API или, если говорить простым языком, обыкновенные HTTP-запросы. И работать с ним можно прямо из браузера. Для просмотра информации о сервисе достаточно обратиться по адресу localhost:9200;
- Можно сделать валидацию на уровне хранилища, в ES это называется маппингом (mappings);
- ES умеет работать с разными запросами — простыми, сложными, структурированными — и различными типами данных;
- JSON QUERY — ещё более декларативный синтаксис, чем SQL;
- Kibana — визуальный инструмент для ES, чтобы взаимодействовать с данными, которые хранятся в индексах ES. Веб-интерфейс Kibana позволяет выполнять и тестировать запросы, настраивать сам ES-кластер и многие другие вещи.
Кроме преимуществ, у ES есть, конечно, и недостатки.
НЕДОСТАТКИ
Разработчики ES предоставляют нужные библиотеки для большинства популярных языков в разделе Elasticsearch Clients. И по ряду причин это не самый лучший выбор. Клиент для каждого языка имеет свои несовершенства:
- Java Client — вложенные цепные вызовы на лямбдах, синтаксис на любителя;
- JavaScript Client — максимально похож на jQuery.ajax — в целом работает и ладно;
- Go Client — можно вызвать Search().Raw([]byte), т.е. мы точно так же пишем многострочный текстовый запрос, как мы это делали в примере с PHP и HEREDOC;
- .NET Clients — что-то среднее между Java- и Go-клиентами;
- PHP Client — не умеет работать с шаблонами и в целом мало что умеет;
- Python Client — предлагает очень странный DSL.
Используя Elasticsearch Clients, мы пытаемся взять запрос в самом ES в формате JSON, например:
и построить его в привычном ООП-стиле. Но на выходе в ES Clients получается такой результат:
SearchResponse search = new ElasticsearchClient().search(s -> s .query(q -> q .bool(b -> b .must(m -> m .exists(. ) .terms(. ) .term(. ) .regexp(. ) .range(. ) .range(. ) .terms(. ) .bool(b -> b .should(sh -> sh .range(. ) .range(. ) ) ) ) ) ) )Поначалу может быть нормально и писать будет легко. Но когда пишутся запросы по 100-120 строк, появляются огромные нечитаемые циклы. В дальнейшем это будет невозможно поддерживать другим разработчикам.
Поэтому предлагаем альтернативу Elasticsearch Clients:
| Клиент для языка программирования | Чем предлагаем заменить |
| Java Client | org.apache.http.client.HttpClient |
| JavaScript Client | node:http/axios/Fetch API |
| Ruby Client | Net::HTTP |
| Go Client | net/http |
| .NET Clients | System.Net.Http.HttpClient |
| PHP Client | curl/GuzzleHttp |
| Python Client | requests или httpx |
| Python Client | reqwest |
ЛАЙФХАКИ, КОТОРЫЕ ПОМОГУТ ВАМ ПРИ ИСПОЛЬЗОВАНИИ ELASTICSEARCH
- Вам не всегда нужен ESClient
Несмотря на то, что мы говорили раньше, в начале пути можно и нужно пользоваться ESClient. Поскольку сначала писать на JSON-языке запросов может быть непривычно и крайне сложно. Со временем у вас соберется пул типичных запросов, которые выполняются всегда. В этот момент вы уже, скорее всего, устанете писать на цепных запросах в Query Builder. Тогда и можно будет перейти к стадии «выкидываем ESClient» и изучить шаблоны, в частности шаблонизатор Mustache.
У ES есть «вложенные поля» — nested object type. Содержимое полей хранится как отдельный документ и может сэкономить память. Например, если у вас есть список пользователей, и есть внутренний объект «организация, к которой принадлежит этот пользователь». Если вы сделаете индекс привычным образом, у каждого пользователя будет, условно говоря, «своя уникальная организация» как отдельное поле. Если сделать nested-объекты, в nested-индексе сохранится один объект организации, а все остальные пользователи будут просто на него ссылаться. Мы по факту сжимаем и входные, и индексированные данные.
В ES есть &filter_path. Это параметр, который позволяет указать, какие поля из итогового ответа вы забираете. Потому что в ES в поиске возвращает объект, в котором есть поле hits, в котором лежит поле hits, который является массивом, в котором лежат объекты. И внутри этого объекта, например, поля _source и _score.
- hits.hits._source — вернет тело документа;
- hits.hits._score — вернет рейтинг соответствия;
- hits.hits._id — вернет внутренний ID документа.
Кроме этого, ES возвращает много дополнительных данных, а filter_path позволяет обрезать ответ.
- Фильтруйте то, что уже отфильтровано
Вы часто видели в интернет-магазинах возможность выбрать телефон на 16ГБ оперативной памяти, 32ГБ и 64ГБ. Можно поставить галочку на 32ГБ, и все остальные варианты скрываются как неактивные. В этом случае работает фильтр, и другие варианты фильтрации отображаться не будут. Но иногда пользователю нужно оставить и другие опции доступными для выбора. Для этого в ES есть post_filter — он фильтрует то, что уже отфильтровано и сгруппировано. В конечном итоге у пользователя есть отфильтрованный список тех параметров, которые ему нужны в телефоне. Но при этом остаются доступными и другие опции, по которым также можно искать.
< "query": < "bool": < "filter": < "term": > > >, "aggs": < "colors": < "terms": < "field": "color" >>, "color_red": < "filter": < "term": < "color": "red" >>, "aggs": < "models": < "terms": < "field": "model" >> > > >, "post_filter": < "term": < "color": "red" >> >В этом примере мы показываем пользователю, какие еще цвета доступны для поиска, но показываем только красные модели.
Alias — это псевдонимы индексов. Изначально в чем проблема — чаще всего мы смотрим в один индекс. И у этого индекса статическое имя, которое где-то в настройках уже лежит. Иногда, чтобы добавить данные, нужно перестроить индекс. Но заставлять пользователя ждать индексацию — не разумно, это занимает много времени. В ES можно сделать это в фоновом режиме. Мы просто создаем новый индекс и наполняем его. В это время пользователь спокойно ищет данные по старому индексу и не знает, что данные о товаре поменялись. После этого мы просто переключаем индекс, это занимает буквально 10 миллисекунд. Пользователь даже ничего не заметит.
Например, есть организация, в организации есть люди, у людей есть машины. Кроме этого, в данных организации у человека указан опыт вождения в годах. Можно искать человека по любым данным — по имени, фамилии, можно искать по личному номеру автомобиля. Но вряд ли кто-то будет искать человека по опыту вождения. Соответственно, индексируйте только то, что ищете. Просто указывайте тип и отключите индексацию поля через :
How-to — это гайд по оптимизации работы с ES от его разработчиков. Читая его, вы лучше поймете, что и как использовать, а также сможете выполнить ряд оптимизаций для повышения производительности вашего проекта.
В ИТОГЕ
Elasticsearch — хороший инструмент полнотекстового поиска, который поможет ускорить ваш проект и сократить время работы над ним. Но для того, чтобы разобраться во всех его возможностях, потребуется много практики. Особенно если вы хотите построить на его основе NoSQL-хранилище.
ПОЛЕЗНЫЕ ССЫЛКИ
- Доклад «Elasticsearch: искать, фильтровать и не сломать»;
- Статья «Неполнотекстовый поиск: специфичные возможности Elasticsearch для сложных задач»;
- Материал «Фильтруйте свои данные».
- #elasticsearch
- #mongodb
- #postgresql
- #backend
- #nosql
Поиск по вашему сайту, как в Яндексе или Google: зачем компаниям нужен Elasticsearch
Рассказываем на реальных примерах Netflix, Тинькофф, GitHub и других компаний, как одна технология помогает оптимизировать поиск по сайту, организовать мониторинг бизнес-показателей, обрабатывать неструктурированные сообщения сторонних систем и текстовые журналы, метрики сетевых, IoT и других устройств.
Сегодня компании генерируют всё больше данных, и стандартные системы хранения и привычные инструменты обработки перестают справляться с их объемами. При этом требования к скорости и качеству поиска и анализа информации на сайте или в приложении, в аналитике сервисов и серверов, только растут. Решить такую задачу можно с помощью Elasticsearch.
Справочная: что такое Elasticsearch
Elasticsearch (ES) – поисковая система с открытым исходным кодом, которая позволяет в режиме реального времени искать и анализировать данные в нереляционном хранилище. Elasticsearch – ядро экосистемы Elastic Stack, в состав которой также входят Logstash, Kibana и Beats.
Экосистема Elastic Stack состоит из сервисов, которые помогают собрать разнородные данные в едином хранилище и визуализировать результаты.
- Beats – это компактные агенты для сборки и доставки данных в Elasticsearch или Logstash.
- Logstash – это инструмент для сбора событий из разных источников, их преобразования и отправки в Elasticsearch.
- Kibana – веб-интерфейс для визуализации данных в реальном времени.
ES легко масштабируется и обладает высокой отказоустойчивостью. Когда речь идет о действительно больших объемах данных, многие системы не справляются с индексацией и поиском, и возникает вопрос масштабирования как инфраструктуры, так и сервисов. В Elasticsearch горизонтальное масштабирование реализовано на уровне архитектуры, поэтому в кластер можно «на лету» добавлять сервера, а сервис сам перераспределит нагрузку. Elasticsearch хранит данные в структуре, называемой индексом. Он автоматически распределяется по узлам кластера, а при сбое одного из них — перераспределяется на оставшиеся, используя внутренний механизм репликации данных.
Кластер Elasticsearch можно развернуть и на физических серверах, и в облачных средах. Для установки и администрирования кластеров ES на физических серверах требуются технические специалисты для конфигурирования, мониторинга и поддержания инфраструктуры.
Развертывание Elasticsearch на виртуальных машинах в облаке позволяет сократить время запуска и трудозатраты. Например, в облачной платформе Google, Amazon Web Services или Microsoft Azure.
Однако наиболее простой способ запуска кластера Elasticsearch – управляемый сервис. Облачные платформы позволяют создать кластер ES с оптимальной конфигурацией в несколько кликов, и при этом не нужно заниматься обновлением программного обеспечения, резервным копированием, мониторингом или обеспечением отказоустойчивости и безопасности. При изменении нагрузки масштабирование производится парой кликов. Как правило, облачные провайдеры предоставляет сервис в составе интегрированной экосистемы, что позволяет сэкономить время на связывании компонентов обработки данных между собой. А также всегда доступны инструменты для оперативного реагирования и управления кластером. Эту услугу предоставляет, например, Yandex.Cloud.
Под капотом: что позволяет Elasticsearch эффективно работать с текстом?
Elasticsearch позволяет качественно и быстро обрабатывать текст, в том числе при полнотекстовом поиске по всем выражениям во всех документах базы данных. Здесь можно привести в пример Яндекс или Google. Вы ввели запрос, и система поиска начинает анализировать все страницы в интернете без исключения, а не ищет абсолютно точное или универсальное совпадение с вашим запросом. Elasticsearch также анализирует и сохраняет все данные. Как это происходит?
Основой для работы с текстовыми документами является анализатор. Он представляет собой цепочкупоследовательных обработчиков.
Сначала поступивший в анализатор текст проходит символьные фильтры, которые убирают, добавляют или заменяют отдельные символы в потоке. Например, с их помощью можно заменить арабские цифры (٠ ١٢٣٤٥٦٧٨ ٩) на современные арабские цифры (0123456789), перевести текст в нижний регистр или удалить html-теги.
Обработанный текст передается токенизатору, где поток символов очищается от знаков препинания и разбивается по определенным правилам на отдельные слова. Его выбор является ключевым для результата анализа: он сегментирует текст на токены по пробелам или другим символам, а затем формирует из них набор слов или основ слов (например, корней).
Полученный набор попадает в один или несколько фильтров токенов. Они могут добавлять, удалять или менять слова. Например, фильтры могут удалять часто используемые служебные слова, такие как артикли «a» и «the» в англоязычном тексте. После всех преобразований на выходе из анализатора мы имеем набор, который сохраняется в индексе Elasticsearch. Этот процесс позволяет сохранять максимум смысла при минимуме объема знаков.
Поиск слов из запроса Elasticsearch осуществляет уже по индексу. В зависимости от выбора способа поиска текст запроса может быть как предварительно проанализирован, так и нет, а сам поиск может быть как поиском по точному совпадению, так и нечетким.
Как компании применяют Elastic Stack в системах Big Data?
Для полнотекстового поиска по сайту
Stack Overflow использует Elasticsearch как средство для полнотекстового поиска по вопросам и ответам для пользователей, а также для поиска похожих вопросов и подсказок при создании нового вопроса. С его помощью сервис предоставляет как поиск по точному совпадению (для строки кода), так и нечёткий поиск с большим количеством настроек. Например, можно отдельно искать только по вопросам или только по ответам, по вопросам с заданным количеством ответов, по определенным тегам, автору, или оценке вопроса.
Благодаря Elasticsearch GitHub обеспечивает пользователям как полнотекстовый поиск, так и поиск по отдельным критериям по 8 миллионам репозиториев кода. Например, можно найти проект на языке Clojure, который при этом был активен в течение последнего месяца.
Альфа-Банк применяет Elasticsearch для полнотекстового поиска по транзакциям в личном кабинете и в сервисе «выписка по счёту».
Для хранения и анализа журналов
Elasticsearch позволяет централизованно хранить и обрабатывать системные журналы, статистику по аутентификации, метрики оборудования, журналы веб-серверов, серверов приложений, баз данных. Например, для обработки многочисленных журналов он используется такими организациями, как Netflix, ДомКлик, Medium.
Однажды Эдриан Кокрофт, бывший тогда облачным архитектором Netflix, пошутил, что «Netflix — это компания, генерирующая файлы журналов, которая также занимается потоковым вещанием фильмов». Еще в 2015 году конвейер данных Netflix обрабатывал 500 миллиардов событий в день. Это действия, связанные с просмотром видео, использованием интерфейса, журналы ошибок, производительности, события по диагностике и устранению неполадок – в общей сложности 1,3 петабайта данных. Для хранения, поиска и анализа этих данных используется Elasticsearch. За два года после начала внедрения инфраструктура доросла до 150 кластеров с суммарно более чем 3500 инстансами.
ДомКлик организовали кластер логирования на производительных физических серверах с помощью Elasticsearch. Задача кластера – агрегация и поиск по журналам более 2000 приложений, запущенных в кластере Kubernetes. Благодаря точной настройке Elasticsearch и конфигурированию Logstash система обрабатывает 4.4 ТБ данных в сутки.
Для поиска по продуктам
Leroy Merlin в России создали поиск по продуктам с нуля. Компании требовался адаптированный для русского языка поиск по товарам, их доступности и ценам. Эти данные агрегируются, форматируются и записываются в индекс Elasticsearch. При поиске товара на сайте или в мобильном приложении, созданный компанией продукт search engine ищет товары в индексе ES, затем данные ранжируются с помощью ML-алгоритмов и выдаются на странице.
Кроме того, на базе Elasticsearch была реализована быстрая выдача каталога и сервис поисковых подсказок. С момента запуска сервиса количество товаров в индексе увеличилось в два раза и продолжает расти. В среднем пользователи делают 300 поисковых запросов в секунду, но несмотря на это, время отклика составляет меньше 200 миллисекунд.
Для визуализации и анализа показателей
Тинькофф предоставляет мониторинг как сервис для более чем 200 команд компании – сотрудники загружают файлы журналов, могут использовать свои метрики и следить за показателями собственных систем. Продукт построен на основе Elasticsearch и кроме поиска позволяет строить дашборды и настраивать оповещения, а также отслеживать инфраструктурные и бизнес-показатели.
Каждую секунду в сервис поступает 1ГБ данных с балансировщиков, гипервизоров и коммутаторов, информации о состоянии биржи или платежей, пользовательских инцидентах. Все поступившие журналы хранятся в индексах Elasticsearch. Для удобства пользователей в компании разработали собственный язык запросов, а процессингом и валидацией данных занимаются собственные приложения. Эти решения позволили реализовать поиск, оповещения, создание дашбордов с аналитикой как сервис одного окна.
Elasticsearch хорошо подходит как для больших, высоконагруженных сервисов, так и для небольших проектов, в которых постоянно растут объемы данных и поисковых запросов. Высокое качество и скорость полнотекстового поиска, инструменты для сбора и анализа данных сделали Elasticsearch одним из самых популярных в мире продуктов среди поисковых систем.
Подписывайтесь на блог Yandex.Cloud, чтобы узнавать еще больше новостей и историй об IT и бизнесе.
Другие истории, которые активно читают наши подписчики:
- Перфокарты, лунная программа «Аполлон» и эпоха big data: рассказываем о важном из истории хранения данных
- Как мы сделали мобильное приложение для управления серверами по клику
- Бессерверные вычисления: почему некоторые разработчики упускают главное?