Определение кодировки
Поле DllImportAttribute.CharSet управляет маршалированием строк и определяет, как вызов платформы находит имена функций в библиотеке DLL. В этом разделе описываются оба механизма.
Некоторые API экспортируют две версии функций, которые принимают строковые аргументы: обычные (ANSI) и двухбайтовые (Юникод). Например, API Windows включает следующие имена точек входа для функции MessageBox:
- MessageBoxA Обеспечивает форматирование однобайтовых символов ANSI и имеет суффикс «A» в имени точки входа. При вызове MessageBoxA строки всегда маршалируются в формате ANSI.
- MessageBoxW Обеспечивает форматирование двухбайтовых символов Юникода и имеет суффикс «W» в имени точки входа. При вызове MessageBoxW строки всегда маршалируются в формате Юникод.
Маршалирование строк и сопоставление имен
Поле CharSet принимает следующие значения:
Ansi (значение по умолчанию)
- Маршалирование строк При вызове неуправляемого кода выполняется маршалинг строк из соответствующего управляемого формата (Юникод) в формат ANSI.
- Сопоставление имен Если поле DllImportAttribute.ExactSpelling имеет значение true (значение по умолчанию в Visual Basic), при вызове неуправляемого кода осуществляется поиск только указанного имени. Например, если указать MessageBox, при вызове неуправляемого кода будет выполнен поиск MessageBox, который может завершиться сбоем из-за невозможности найти точное совпадение. Если поле ExactSpelling имеет значение false (по умолчанию для C++ и C#), при вызове неуправляемого кода выполняется поиск сначала неуправляемого псевдонима (MessageBox), а затем, если неуправляемый псевдоним не найден, управляемого имени (MessageBoxA). Обратите внимание, что принципы сопоставления имен ANSI и Юникода различаются.
- Маршалирование строк При вызове неуправляемого кода строки копируются из соответствующего управляемого формата (Юникод) в формат Юникода.
- Сопоставление имен Если поле ExactSpelling имеет значение true (значение по умолчанию в Visual Basic), при вызове неуправляемого кода осуществляется поиск только указанного имени. Например, если указать MessageBox, при вызове неуправляемого кода будет выполнен поиск MessageBox, который может завершиться сбоем из-за невозможности найти точное совпадение. Если поле ExactSpelling имеет значение false (по умолчанию для C++ и C#), при вызове неуправляемого кода выполняется поиск сначала управляемого имени (MessageBoxW), а затем, если управляемое имя не найдено, неуправляемого псевдонима (MessageBox). Обратите внимание, что принципы сопоставления имен Юникода и ANSI различаются.
- При вызове неуправляемого кода во время выполнения осуществляется выбор между форматами ANSI и Юникода в соответствии с целевой платформой.
Определение кодировки в Visual Basic
В Visual Basic можно указать поведение кодировки, добавив ключевое слово Ansi , Unicode или Auto в операторе объявления. Если опустить ключевое слово кодировки, в поле DllImportAttribute.CharSet по умолчанию будет задана кодировка ANSI.
В следующем примере функция MessageBox объявляется три раза с разными кодировками. В первом операторе ключевое слово кодировки опущено, в связи с чем по умолчанию устанавливается кодировка ANSI. Во втором и третьем операторе кодировка задается явно с использованием ключевого слова.
Friend Class NativeMethods Friend Declare Function MessageBoxA Lib "user32.dll" ( ByVal hWnd As IntPtr, ByVal lpText As String, ByVal lpCaption As String, ByVal uType As UInteger) As Integer Friend Declare Unicode Function MessageBoxW Lib "user32.dll" ( ByVal hWnd As IntPtr, ByVal lpText As String, ByVal lpCaption As String, ByVal uType As UInteger) As Integer Friend Declare Auto Function MessageBox Lib "user32.dll" ( ByVal hWnd As IntPtr, ByVal lpText As String, ByVal lpCaption As String, ByVal uType As UInteger) As Integer End Class Определение кодировки в C# и C++
Поле DllImportAttribute.CharSet определяет базовую кодировку как ANSI или Юникод. Набор символов определяет способ маршалирования строковых аргументов метода. Чтобы указать кодировку, используйте одну из следующих форм:
[DllImport("DllName", CharSet = CharSet.Ansi)] [DllImport("DllName", CharSet = CharSet.Unicode)] [DllImport("DllName", CharSet = CharSet.Auto)] [DllImport("DllName", CharSet = CharSet::Ansi)] [DllImport("DllName", CharSet = CharSet::Unicode)] [DllImport("DllName", CharSet = CharSet::Auto)] В следующем примере показаны три управляемых определения функции MessageBox с атрибутами, задающими кодировку. В первом определении соответствующее ключевое слово опущено, в результате чего в поле CharSet по умолчанию устанавливается кодировка ANSI.
using System; using System.Runtime.InteropServices; internal static class NativeMethods
typedef void* HWND; // Can use MessageBox or MessageBoxA. [DllImport("user32")] extern "C" int MessageBox( HWND hWnd, String* lpText, String* lpCaption, unsigned int uType); // Can use MessageBox or MessageBoxW. [DllImport("user32", CharSet = CharSet::Unicode)] extern "C" int MessageBoxW( HWND hWnd, String* lpText, String* lpCaption, unsigned int uType); // Must use MessageBox. [DllImport("user32", CharSet = CharSet::Auto)] extern "C" int MessageBox( HWND hWnd, String* lpText, String* lpCaption, unsigned int uType); См. также
- DllImportAttribute
- Создание прототипов в управляемом коде
- Примеры вызовов неуправляемого кода
- Маршалирование данных с помощью вызова платформы
Совместная работа с нами на GitHub
Источник этого содержимого можно найти на GitHub, где также можно создавать и просматривать проблемы и запросы на вытягивание. Дополнительные сведения см. в нашем руководстве для участников.
C как узнать кодировку строки
Для отключения данного рекламного блока вам необходимо зарегистрироваться или войти с учетной записью социальной сети.
Сообщения: 1696
Благодарности: 44
EvgeniyQQQ, Не знаю, что есть ANSI. Но в ASCII не может быть символов с кодом > 127 (это 7-итная кодировка). Если же используется «расширенный» ASCII (Latin-1 или любая другая национальная кодировка), то можно просто проверить, что исходная строка содержит символы с кодом > 127 и является корректной utf-8 строкой (т.е. удовлетворяет этим требованиям: http://tools.ietf.org/html/rfc3629#section-3). Если строка достаточно большая и не в utf-8, то где-нибудь обязательно будет неправильна закодирована, и следовательно не utf-8, иначе «произвольная однобайтовая кодировка».
Это сообщение посчитали полезным следующие участники:
Сообщения: 14
Благодарности: 4
Текст, состоящий только из символов с номером меньше 128, при записи в UTF-8 превращается в обычный текст ASCII. И наоборот, в тексте UTF-8 любой байт со значением меньше 128 изображает символ ASCII с тем же кодом. Остальные символы Юникода изображаются последовательностями длиной от 2 до 6 байтов, в которых первый байт всегда имеет вид 11xxxxxx, а остальные — 10xxxxxx. Более подробно о UTF-8 посмотрите http://ru.wikipedia.org/wiki/UTF-8. Что же касается ANSI — то насколько я понимаю, это то же, что и кодировка Windows-1251, т.е. 8-битная и содержит русские символы.
Это сообщение посчитали полезным следующие участники:
Сообщения: 4
Благодарности: 1
| Конфигурация компьютера |  |
| Процессор: c2d E8200 | |
| Материнская плата: p5e | |
| Память: 2gb | |
| Видеокарта: gf 8800gt | |
| ОС: 2008r2 |
Потребовалось мне автоопределение кодировки в текстовом файле; нашёл (не претендуя на универсальность) такой выход (builder xe3):
String tst= al+af+am+bt+sn; // несколько тэгов, выделенных из fb2 файла
if( tst[1]>0x007F && UTF8Decode(tst)[1]!=0xfffd ) al=UTF8Decode(al);// нет, это не ansi!
суть в том, что UTF8Decode от русского ansi-текста возвращает строку, забитую 0xFFFD
а от английского ansi-текста или любого utf8-текста возвращает читабельный ansi-текст.
ps для fb2, понятно, надо каждый тег проверять (т.к. в utf файле могут быть смешаны и русские и английские тэги), но принцип проверки понятен.
Encoding. Get Encoding Метод
Некоторые сведения относятся к предварительной версии продукта, в которую до выпуска могут быть внесены существенные изменения. Майкрософт не предоставляет никаких гарантий, явных или подразумеваемых, относительно приведенных здесь сведений.
Возвращает кодировку для указанной кодовой страницы.
Перегрузки
Возвращает кодировку, связанную с указанным идентификатором кодовой страницы.
Возвращает кодировку, связанную с указанным именем кодовой страницы.
Возвращает кодировку, связанную с указанным идентификатором кодовой страницы. С помощью параметров задается обработчик ошибок для символов, которые не удается закодировать, и последовательностей байтов, которые не удается декодировать.
Возвращает кодировку, связанную с указанным именем кодовой страницы. С помощью параметров задается обработчик ошибок для символов, которые не удается закодировать, и последовательностей байтов, которые не удается декодировать.
GetEncoding(Int32)
Возвращает кодировку, связанную с указанным идентификатором кодовой страницы.
public: static System::Text::Encoding ^ GetEncoding(int codepage);public static System.Text.Encoding GetEncoding (int codepage);static member GetEncoding : int -> System.Text.EncodingPublic Shared Function GetEncoding (codepage As Integer) As EncodingПараметры
Идентификатор кодовой страницы предпочтительной кодировки. Список возможных значений см. в разделе Encoding.
0 (ноль), если требуется использовать кодировку по умолчанию.
Возвращаемое значение
Кодирование, связанное с заданной страницей кода.
Исключения
Параметр codepage меньше нуля или больше 65 535.
codepage не поддерживается используемой платформой.
codepage не поддерживается используемой платформой.
Примеры
В следующем примере выполняется получение двух экземпляров одной кодировки (по одной кодовой странице и другой по имени) и проверка их равенства.
using namespace System; using namespace System::Text; int main() < // Get a UTF-32 encoding by codepage. Encoding^ e1 = Encoding::GetEncoding( 12000 ); // Get a UTF-32 encoding by name. Encoding^ e2 = Encoding::GetEncoding( "utf-32" ); // Check their equality. Console::WriteLine( "e1 equals e2? ", e1->Equals( e2 ) ); > /* This code produces the following output. e1 equals e2? True */ using System; using System.Text; public class SamplesEncoding < public static void Main() < // Get a UTF-32 encoding by codepage. Encoding e1 = Encoding.GetEncoding( 12000 ); // Get a UTF-32 encoding by name. Encoding e2 = Encoding.GetEncoding( "utf-32" ); // Check their equality. Console.WriteLine( "e1 equals e2? ", e1.Equals( e2 ) ); > > /* This code produces the following output. e1 equals e2? True */ Imports System.Text Public Class SamplesEncoding Public Shared Sub Main() ' Get a UTF-32 encoding by codepage. Dim e1 As Encoding = Encoding.GetEncoding(12000) ' Get a UTF-32 encoding by name. Dim e2 As Encoding = Encoding.GetEncoding("utf-32") ' Check their equality. Console.WriteLine("e1 equals e2? ", e1.Equals(e2)) End Sub End Class 'This code produces the following output. ' 'e1 equals e2? True Комментарии
Резервный обработчик зависит от типа кодировки codepage . Если codepage является кодовой страницей или двухбайтовой кодировкой (DBCS), используется резервный обработчик наилучшего соответствия. В противном случае используется резервный обработчик замены. Эти резервные обработчики могут не подойти для вашего приложения. Чтобы указать резервный обработчик, используемый кодировкой, заданной параметром codepage , можно вызвать GetEncoding(Int32, EncoderFallback, DecoderFallback) перегрузку.
В .NET Framework GetEncoding метод использует базовую платформу для поддержки большинства кодовых страниц. Однако .NET Framework изначально поддерживает некоторые кодировки. Список кодовых страниц см. в разделе Список кодировок. В .NET Core GetEncoding метод возвращает кодировки, которые изначально поддерживаются в .NET Core. В обеих реализациях .NET можно вызвать GetEncodings метод, чтобы получить массив EncodingInfo объектов, содержащий сведения обо всех доступных кодировках.
В дополнение к кодировкам, которые изначально доступны в .NET Core или поддерживаются в конкретной версии платформы .NET Framework, GetEncoding метод возвращает все дополнительные кодировки, которые становятся доступными путем регистрации EncodingProvider объекта. Если одна и та же кодировка зарегистрирована несколькими EncodingProvider объектами, этот метод возвращает последний зарегистрированный.
Для аргумента можно также указать значение 0 codepage . Точное поведение зависит от того, были ли доступны кодировки путем регистрации EncodingProvider объекта.
- Если один или несколько поставщиков кодировок зарегистрированы, возвращается кодировка последнего зарегистрированного поставщика, который выбрал для возврата кодировки, когда GetEncoding методу передается аргумент, codepage равный 0.
- В .NET Framework, если поставщик кодирования не зарегистрирован, если CodePagesEncodingProvider является зарегистрированным поставщиком кодирования или если ни один зарегистрированный поставщик кодировок не обрабатывает codepage значение 0, возвращается активная кодовая страница операционной системы. Чтобы определить активную кодовую страницу в системах Windows, вызовите функцию Windows GetACP из платформа .NET Framework.
- В .NET Core, если поставщик кодирования не зарегистрирован или если ни один зарегистрированный поставщик кодировок не обрабатывает codepage значение 0, возвращается UTF8Encoding .
- Некоторые неподдерживаемые кодовые страницы вызывают ArgumentException исключение, а другие вызывают NotSupportedException . Поэтому код должен перехватывать все исключения, указанные в разделе исключения.
- В .NET 5 и более поздних версиях идентификатор 65000 кодовой страницы, представляющий UTF-7, не поддерживается.
Кодовые страницы ANSI могут различаться на разных компьютерах и могут изменяться на одном компьютере, что приводит к повреждению данных. По этой причине, если активная кодовая страница является кодовой страницей ANSI, кодирование и декодирование данных с помощью кодовой страницы по умолчанию, возвращенной, Encoding.GetEncoding(0) не рекомендуется. Для наиболее последовательных результатов следует использовать кодировку Юникода, такую как UTF-8 (кодовая страница 65001) или UTF-16, а не конкретную кодовую страницу.
GetEncodingВозвращает кэшированный экземпляр с параметрами по умолчанию. Для получения экземпляра с разными параметрами следует использовать конструкторы производных классов. Например, UTF32Encoding класс предоставляет конструктор, позволяющий включить обнаружение ошибок.
См. также раздел
- CodePage
- EncoderFallback
- EncoderFallback
- GetEncodings()
- Использование классов кодировки символов в .NET
Применяется к
GetEncoding(String)
Возвращает кодировку, связанную с указанным именем кодовой страницы.
public: static System::Text::Encoding ^ GetEncoding(System::String ^ name);public static System.Text.Encoding GetEncoding (string name);static member GetEncoding : string -> System.Text.EncodingPublic Shared Function GetEncoding (name As String) As EncodingПараметры
Имя кодовой страницы предпочтительной кодировки. Любое значение, возвращаемое свойством WebName, является допустимым. Список возможных значений см. в разделе Encoding.
Возвращаемое значение
Кодировка, связанная с указанной кодовой страницей.
Исключения
name не является допустимым именем кодовой страницы.
Кодовая страница, указанная с помощью параметра name , не поддерживается используемой платформой.
Примеры
В следующем примере выполняется получение двух экземпляров одной кодировки (по одной кодовой странице и другой по имени) и проверка их равенства.
using namespace System; using namespace System::Text; int main() < // Get a UTF-32 encoding by codepage. Encoding^ e1 = Encoding::GetEncoding( 12000 ); // Get a UTF-32 encoding by name. Encoding^ e2 = Encoding::GetEncoding( "utf-32" ); // Check their equality. Console::WriteLine( "e1 equals e2? ", e1->Equals( e2 ) ); > /* This code produces the following output. e1 equals e2? True */ using System; using System.Text; public class SamplesEncoding < public static void Main() < // Get a UTF-32 encoding by codepage. Encoding e1 = Encoding.GetEncoding( 12000 ); // Get a UTF-32 encoding by name. Encoding e2 = Encoding.GetEncoding( "utf-32" ); // Check their equality. Console.WriteLine( "e1 equals e2? ", e1.Equals( e2 ) ); > > /* This code produces the following output. e1 equals e2? True */ Imports System.Text Public Class SamplesEncoding Public Shared Sub Main() ' Get a UTF-32 encoding by codepage. Dim e1 As Encoding = Encoding.GetEncoding(12000) ' Get a UTF-32 encoding by name. Dim e2 As Encoding = Encoding.GetEncoding("utf-32") ' Check their equality. Console.WriteLine("e1 equals e2? ", e1.Equals(e2)) End Sub End Class 'This code produces the following output. ' 'e1 equals e2? True Комментарии
Резервный обработчик зависит от типа кодировки name . Если name является кодовой страницей или двухбайтовой кодировкой (DBCS), используется резервный обработчик наилучшего соответствия. В противном случае используется резервный обработчик замены. Эти резервные обработчики могут не подойти для вашего приложения. Чтобы указать резервный обработчик, используемый кодировкой, заданной параметром name , можно вызвать GetEncoding(String, EncoderFallback, DecoderFallback) перегрузку.
В .NET Framework GetEncoding метод использует базовую платформу для поддержки большинства кодовых страниц. Однако .NET Framework изначально поддерживает некоторые кодировки. Список кодовых страниц см. в разделе Список кодировок. В .NET Core GetEncoding метод возвращает кодировки, которые изначально поддерживаются в .NET Core. В обеих реализациях .NET можно вызвать GetEncodings метод, чтобы получить массив EncodingInfo объектов, содержащий сведения обо всех доступных кодировках.
В дополнение к кодировкам, которые изначально доступны в .NET Core или поддерживаются в конкретной версии платформы .NET Framework, GetEncoding метод возвращает все дополнительные кодировки, которые становятся доступными путем регистрации EncodingProvider объекта. Если одна и та же кодировка зарегистрирована несколькими EncodingProvider объектами, этот метод возвращает последний зарегистрированный.
В .NET 5 и более поздних версиях имя utf-7 кодовой страницы не поддерживается.
Кодовые страницы ANSI могут отличаться на разных компьютерах, или их можно изменить для одного компьютера, что приведет к повреждению данных. Для наиболее последовательных результатов используйте Юникод, например UTF-8 (кодовая страница 65001) или UTF-16, а не определенную кодовую страницу.
GetEncodingВозвращает кэшированный экземпляр с параметрами по умолчанию. Для получения экземпляра с разными параметрами следует использовать конструкторы производных классов. Например, UTF32Encoding класс предоставляет конструктор, позволяющий включить обнаружение ошибок.
См. также раздел
- EncoderFallback
- EncoderFallback
- GetEncodings()
- Использование классов кодировки символов в .NET
Применяется к
GetEncoding(Int32, EncoderFallback, DecoderFallback)
Возвращает кодировку, связанную с указанным идентификатором кодовой страницы. С помощью параметров задается обработчик ошибок для символов, которые не удается закодировать, и последовательностей байтов, которые не удается декодировать.
public: static System::Text::Encoding ^ GetEncoding(int codepage, System::Text::EncoderFallback ^ encoderFallback, System::Text::DecoderFallback ^ decoderFallback);public static System.Text.Encoding GetEncoding (int codepage, System.Text.EncoderFallback encoderFallback, System.Text.DecoderFallback decoderFallback);static member GetEncoding : int * System.Text.EncoderFallback * System.Text.DecoderFallback -> System.Text.EncodingPublic Shared Function GetEncoding (codepage As Integer, encoderFallback As EncoderFallback, decoderFallback As DecoderFallback) As EncodingПараметры
Идентификатор кодовой страницы предпочтительной кодировки. Список возможных значений см. в разделе Encoding.
0 (ноль), если требуется использовать кодировку по умолчанию.
encoderFallback EncoderFallback
Объект, предоставляющий процедуру обработки ошибок, когда символ не может быть закодирован с использованием текущей кодировки.
decoderFallback DecoderFallback
Объект, предоставляющий процедуру обработки ошибок, когда последовательность байтов не может быть декодирована с использованием текущей кодировки.
Возвращаемое значение
Кодирование, связанное с заданной страницей кода.
Исключения
Параметр codepage меньше нуля или больше 65 535.
codepage не поддерживается используемой платформой.
codepage не поддерживается используемой платформой.
Примеры
// This example demonstrates the EncoderReplacementFallback class. using namespace System; using namespace System::Text; int main() < // Create an encoding, which is equivalent to calling the // ASCIIEncoding class constructor. // The EncoderReplacementFallback parameter specifies that the // string, "(unknown)", replace characters that cannot be encoded. // A decoder replacement fallback is also specified, but in this // code example the decoding operation cannot fail. Encoding^ ascii = Encoding::GetEncoding("us-ascii", gcnew EncoderReplacementFallback("(unknown)"), gcnew DecoderReplacementFallback("(error)")); // The input string consists of the Unicode characters LEFT POINTING // DOUBLE ANGLE QUOTATION MARK (U+00AB), 'X' (U+0058), and RIGHT // POINTING DOUBLE ANGLE QUOTATION MARK (U+00BB). // The encoding can only encode characters in the US-ASCII range of // U+0000 through U+007F. Consequently, the characters bracketing the // 'X' character are replaced with the fallback replacement string, // "(unknown)". String^ inputString = "\u00abX\u00bb"; String^ decodedString; String^ twoNewLines = Environment::NewLine + Environment::NewLine; array ^ encodedBytes = gcnew array(ascii->GetByteCount(inputString)); int numberOfEncodedBytes = 0; // --------------------------------------------------------------------- // Display the name of the encoding. Console::WriteLine("The name of the encoding is \"\".", ascii->WebName, Environment::NewLine); // Display the input string in text. Console::WriteLine("Input string ( characters): \"\"", inputString->Length, inputString); // Display the input string in hexadecimal. Console::Write("Input string in hexadecimal: "); for each (char c in inputString) < Console::Write("0x", c); > Console::Write(twoNewLines); // --------------------------------------------------------------------- // Encode the input string. Console::WriteLine("Encode the input string. "); numberOfEncodedBytes = ascii->GetBytes(inputString, 0, inputString->Length, encodedBytes, 0); // Display the encoded bytes. Console::WriteLine("Encoded bytes in hexadecimal ( bytes):", numberOfEncodedBytes, Environment::NewLine); for(int i = 0; i < encodedBytes->Length; i++) < Console::Write("0x", encodedBytes[i]); if(((i + 1) % 6) == 0) < Console::WriteLine(); >> Console::Write(twoNewLines); // --------------------------------------------------------------------- // Decode the encoded bytes, yielding a reconstituted string. Console::WriteLine("Decode the encoded bytes. "); decodedString = ascii->GetString(encodedBytes); // Display the input string and the decoded string for comparison. Console::WriteLine("Input string: \"\"", inputString); Console::WriteLine("Decoded string:\"\"", decodedString); > /* This code example produces the following results: The name of the encoding is "us-ascii". Input string (3 characters): "X" Input string in hexadecimal: 0xAB 0x58 0xBB Encode the input string. Encoded bytes in hexadecimal (19 bytes): 0x28 0x75 0x6E 0x6B 0x6E 0x6F 0x77 0x6E 0x29 0x58 0x28 0x75 0x6E 0x6B 0x6E 0x6F 0x77 0x6E 0x29 Decode the encoded bytes. Input string: "X" Decoded string:"(unknown)X(unknown)" */ // This example demonstrates the EncoderReplacementFallback class. using System; using System.Text; class Sample < public static void Main() < // Create an encoding, which is equivalent to calling the // ASCIIEncoding class constructor. // The EncoderReplacementFallback parameter specifies that the // string, "(unknown)", replace characters that cannot be encoded. // A decoder replacement fallback is also specified, but in this // code example the decoding operation cannot fail. Encoding ae = Encoding.GetEncoding( "us-ascii", new EncoderReplacementFallback("(unknown)"), new DecoderReplacementFallback("(error)")); // The input string consists of the Unicode characters LEFT POINTING // DOUBLE ANGLE QUOTATION MARK (U+00AB), 'X' (U+0058), and RIGHT POINTING // DOUBLE ANGLE QUOTATION MARK (U+00BB). // The encoding can only encode characters in the US-ASCII range of U+0000 // through U+007F. Consequently, the characters bracketing the 'X' character // are replaced with the fallback replacement string, "(unknown)". string inputString = "\u00abX\u00bb"; string decodedString; string twoNewLines = "\n\n"; byte[] encodedBytes = new byte[ae.GetByteCount(inputString)]; int numberOfEncodedBytes = 0; int ix = 0; // -------------------------------------------------------------------------- // Display the name of the encoding. Console.WriteLine("The name of the encoding is \"\".\n", ae.WebName); // Display the input string in text. Console.WriteLine("Input string ( characters): \"\"", inputString.Length, inputString); // Display the input string in hexadecimal. Console.Write("Input string in hexadecimal: "); foreach (char c in inputString.ToCharArray()) < Console.Write("0x", (int)c); > Console.Write(twoNewLines); // -------------------------------------------------------------------------- // Encode the input string. Console.WriteLine("Encode the input string. "); numberOfEncodedBytes = ae.GetBytes(inputString, 0, inputString.Length, encodedBytes, 0); // Display the encoded bytes. Console.WriteLine("Encoded bytes in hexadecimal ( bytes):\n", numberOfEncodedBytes); ix = 0; foreach (byte b in encodedBytes) < Console.Write("0x", (int)b); ix++; if (0 == ix % 6) Console.WriteLine(); > Console.Write(twoNewLines); // -------------------------------------------------------------------------- // Decode the encoded bytes, yielding a reconstituted string. Console.WriteLine("Decode the encoded bytes. "); decodedString = ae.GetString(encodedBytes); // Display the input string and the decoded string for comparison. Console.WriteLine("Input string: \"\"", inputString); Console.WriteLine("Decoded string:\"\"", decodedString); > > /* This code example produces the following results: The name of the encoding is "us-ascii". Input string (3 characters): "«X»" Input string in hexadecimal: 0xAB 0x58 0xBB Encode the input string. Encoded bytes in hexadecimal (19 bytes): 0x28 0x75 0x6E 0x6B 0x6E 0x6F 0x77 0x6E 0x29 0x58 0x28 0x75 0x6E 0x6B 0x6E 0x6F 0x77 0x6E 0x29 Decode the encoded bytes. Input string: "«X»" Decoded string:"(unknown)X(unknown)" */ ' This example demonstrates the EncoderReplacementFallback class. Imports System.Text Class Sample Public Shared Sub Main() ' Create an encoding, which is equivalent to calling the ' ASCIIEncoding class constructor. ' The EncoderReplacementFallback parameter specifies that the ' string, "(unknown)", replace characters that cannot be encoded. ' A decoder replacement fallback is also specified, but in this ' code example the decoding operation cannot fail. Dim erf As New EncoderReplacementFallback("(unknown)") Dim drf As New DecoderReplacementFallback("(error)") Dim ae As Encoding = Encoding.GetEncoding("us-ascii", erf, drf) ' The input string consists of the Unicode characters LEFT POINTING ' DOUBLE ANGLE QUOTATION MARK (U+00AB), 'X' (U+0058), and RIGHT POINTING ' DOUBLE ANGLE QUOTATION MARK (U+00BB). ' The encoding can only encode characters in the US-ASCII range of U+0000 ' through U+007F. Consequently, the characters bracketing the 'X' character ' are replaced with the fallback replacement string, "(unknown)". Dim inputString As String = "«X»" Dim decodedString As String Dim twoNewLines As String = vbCrLf & vbCrLf Dim ix As Integer = 0 Dim numberOfEncodedBytes As Integer = ae.GetByteCount(inputString) ' Counteract the compiler adding an extra byte to the array. Dim encodedBytes(numberOfEncodedBytes - 1) As Byte ' -------------------------------------------------------------------------- ' Display the name of the encoding. Console.WriteLine("The name of the encoding is """"." & vbCrLf, ae.WebName) ' Display the input string in text. Console.WriteLine("Input string ( characters): """"", _ inputString.Length, inputString) ' Display the input string in hexadecimal. ' Each element is converted to an integer with Convert.ToInt32. Console.Write("Input string in hexadecimal: ") Dim c As Char For Each c In inputString.ToCharArray() Console.Write("0x ", Convert.ToInt32(c)) Next c Console.Write(twoNewLines) ' -------------------------------------------------------------------------- ' Encode the input string. Console.WriteLine("Encode the input string. ") numberOfEncodedBytes = ae.GetBytes(inputString, 0, inputString.Length, _ encodedBytes, 0) ' Display the encoded bytes. ' Each element is converted to an integer with Convert.ToInt32. Console.WriteLine("Encoded bytes in hexadecimal ( bytes):" & vbCrLf, _ numberOfEncodedBytes) ix = 0 Dim b As Byte For Each b In encodedBytes Console.Write("0x ", Convert.ToInt32(b)) ix += 1 If 0 = ix Mod 6 Then Console.WriteLine() End If Next b Console.Write(twoNewLines) ' -------------------------------------------------------------------------- ' Decode the encoded bytes, yielding a reconstituted string. Console.WriteLine("Decode the encoded bytes. ") decodedString = ae.GetString(encodedBytes) ' Display the input string and the decoded string for comparison. Console.WriteLine("Input string: """"", inputString) Console.WriteLine("Decoded string:""""", decodedString) End Sub End Class ' 'This code example produces the following results: ' 'The name of the encoding is "us-ascii". ' 'Input string (3 characters): "X" 'Input string in hexadecimal: 0xAB 0x58 0xBB ' 'Encode the input string. 'Encoded bytes in hexadecimal (19 bytes): ' '0x28 0x75 0x6E 0x6B 0x6E 0x6F '0x77 0x6E 0x29 0x58 0x28 0x75 '0x6E 0x6B 0x6E 0x6F 0x77 0x6E '0x29 ' 'Decode the encoded bytes. 'Input string: "X" 'Decoded string:"(unknown)X(unknown)" ' Комментарии
- Некоторые неподдерживаемые кодовые страницы приводят к возникновению исключения ArgumentException , а другие вызывают NotSupportedException . Поэтому код должен перехватывать все исключения, указанные в разделе исключения.
- В .NET 5 и более поздних версиях идентификатор 65000 кодовой страницы, представляющий UTF-7, не поддерживается.
В .NET Framework GetEncoding метод использует базовую платформу для поддержки большинства кодовых страниц. Однако .NET Framework изначально поддерживает некоторые кодировки. Список кодовых страниц см. в разделе Список кодировок. В .NET Core GetEncoding метод возвращает кодировки, которые изначально поддерживаются в .NET Core. В обеих реализациях .NET можно вызвать GetEncodings метод, чтобы получить массив EncodingInfo объектов, содержащий сведения обо всех доступных кодировках.
В дополнение к кодировкам, которые изначально доступны в .NET Core или поддерживаются в конкретной версии платформы .NET Framework, GetEncoding метод возвращает все дополнительные кодировки, которые становятся доступными путем регистрации EncodingProvider объекта. Если одна и та же кодировка зарегистрирована несколькими EncodingProvider объектами, этот метод возвращает последний зарегистрированный.
Для аргумента можно также указать значение 0 codepage . Точное поведение зависит от того, были ли доступны кодировки путем регистрации EncodingProvider объекта.
- Если один или несколько поставщиков кодировок зарегистрированы, возвращается кодировка последнего зарегистрированного поставщика, который выбрал для возврата кодировки, когда GetEncoding методу передается аргумент, codepage равный 0.
- В .NET Framework, если поставщик кодирования не зарегистрирован, если CodePagesEncodingProvider является зарегистрированным поставщиком кодирования или если ни один зарегистрированный поставщик кодировок не обрабатывает codepage значение 0, возвращается активная кодовая страница.
- В .NET Core, если поставщик кодирования не зарегистрирован или если ни один зарегистрированный поставщик кодировок не обрабатывает codepage значение 0, возвращается UTF8Encoding Кодировка.
Кодовые страницы ANSI могут различаться на разных компьютерах и могут изменяться на одном компьютере, что приводит к повреждению данных. По этой причине, если активная кодовая страница является кодовой страницей ANSI, кодирование и декодирование данных с помощью кодовой страницы по умолчанию, возвращенной, Encoding.GetEncoding(0) не рекомендуется. Для наиболее последовательных результатов следует использовать Юникод, например UTF-8 (кодовая страница 65001) или UTF-16, а не конкретную кодовую страницу.
Чтобы получить кодировку, связанную с активной кодовой страницей, можно указать значение 0 для codepage аргумента или, если код выполняется на платформа .NET Framework, получить значение Encoding.Default свойства . Чтобы определить текущую активную кодовую страницу, вызовите функцию Windows GetACP из платформа .NET Framework.
GetEncodingВозвращает кэшированный экземпляр с параметрами по умолчанию. Для получения экземпляра с разными параметрами следует использовать конструкторы производных классов. Например, UTF32Encoding класс предоставляет конструктор, позволяющий включить обнаружение ошибок.
См. также раздел
- CodePage
- EncoderFallback
- EncoderFallback
- GetEncodings()
- Использование классов кодировки символов в .NET
Применяется к
GetEncoding(String, EncoderFallback, DecoderFallback)
Возвращает кодировку, связанную с указанным именем кодовой страницы. С помощью параметров задается обработчик ошибок для символов, которые не удается закодировать, и последовательностей байтов, которые не удается декодировать.
public: static System::Text::Encoding ^ GetEncoding(System::String ^ name, System::Text::EncoderFallback ^ encoderFallback, System::Text::DecoderFallback ^ decoderFallback);public static System.Text.Encoding GetEncoding (string name, System.Text.EncoderFallback encoderFallback, System.Text.DecoderFallback decoderFallback);static member GetEncoding : string * System.Text.EncoderFallback * System.Text.DecoderFallback -> System.Text.EncodingPublic Shared Function GetEncoding (name As String, encoderFallback As EncoderFallback, decoderFallback As DecoderFallback) As EncodingПараметры
Имя кодовой страницы предпочтительной кодировки. Любое значение, возвращаемое свойством WebName, является допустимым. Возможные значения перечислены в столбце «Имя» таблицы, отображаемой в разделе класса Encoding.
encoderFallback EncoderFallback
Объект, предоставляющий процедуру обработки ошибок, когда символ не может быть закодирован с использованием текущей кодировки.
decoderFallback DecoderFallback
Объект, предоставляющий процедуру обработки ошибок, когда последовательность байтов не может быть декодирована с использованием текущей кодировки.
Возвращаемое значение
Кодирование, связанное с заданной страницей кода.
Исключения
name не является допустимым именем кодовой страницы.
Кодовая страница, указанная с помощью параметра name , не поддерживается используемой платформой.
Примеры
// This example demonstrates the EncoderReplacementFallback class. using namespace System; using namespace System::Text; int main() < // Create an encoding, which is equivalent to calling the // ASCIIEncoding class constructor. // The EncoderReplacementFallback parameter specifies that the // string, "(unknown)", replace characters that cannot be encoded. // A decoder replacement fallback is also specified, but in this // code example the decoding operation cannot fail. Encoding^ ascii = Encoding::GetEncoding("us-ascii", gcnew EncoderReplacementFallback("(unknown)"), gcnew DecoderReplacementFallback("(error)")); // The input string consists of the Unicode characters LEFT POINTING // DOUBLE ANGLE QUOTATION MARK (U+00AB), 'X' (U+0058), and RIGHT // POINTING DOUBLE ANGLE QUOTATION MARK (U+00BB). // The encoding can only encode characters in the US-ASCII range of // U+0000 through U+007F. Consequently, the characters bracketing the // 'X' character are replaced with the fallback replacement string, // "(unknown)". String^ inputString = "\u00abX\u00bb"; String^ decodedString; String^ twoNewLines = Environment::NewLine + Environment::NewLine; array ^ encodedBytes = gcnew array(ascii->GetByteCount(inputString)); int numberOfEncodedBytes = 0; // --------------------------------------------------------------------- // Display the name of the encoding. Console::WriteLine("The name of the encoding is \"\".", ascii->WebName, Environment::NewLine); // Display the input string in text. Console::WriteLine("Input string ( characters): \"\"", inputString->Length, inputString); // Display the input string in hexadecimal. Console::Write("Input string in hexadecimal: "); for each (char c in inputString) < Console::Write("0x", c); > Console::Write(twoNewLines); // --------------------------------------------------------------------- // Encode the input string. Console::WriteLine("Encode the input string. "); numberOfEncodedBytes = ascii->GetBytes(inputString, 0, inputString->Length, encodedBytes, 0); // Display the encoded bytes. Console::WriteLine("Encoded bytes in hexadecimal ( bytes):", numberOfEncodedBytes, Environment::NewLine); for(int i = 0; i < encodedBytes->Length; i++) < Console::Write("0x", encodedBytes[i]); if(((i + 1) % 6) == 0) < Console::WriteLine(); >> Console::Write(twoNewLines); // --------------------------------------------------------------------- // Decode the encoded bytes, yielding a reconstituted string. Console::WriteLine("Decode the encoded bytes. "); decodedString = ascii->GetString(encodedBytes); // Display the input string and the decoded string for comparison. Console::WriteLine("Input string: \"\"", inputString); Console::WriteLine("Decoded string:\"\"", decodedString); > /* This code example produces the following results: The name of the encoding is "us-ascii". Input string (3 characters): "X" Input string in hexadecimal: 0xAB 0x58 0xBB Encode the input string. Encoded bytes in hexadecimal (19 bytes): 0x28 0x75 0x6E 0x6B 0x6E 0x6F 0x77 0x6E 0x29 0x58 0x28 0x75 0x6E 0x6B 0x6E 0x6F 0x77 0x6E 0x29 Decode the encoded bytes. Input string: "X" Decoded string:"(unknown)X(unknown)" */ // This example demonstrates the EncoderReplacementFallback class. using System; using System.Text; class Sample < public static void Main() < // Create an encoding, which is equivalent to calling the // ASCIIEncoding class constructor. // The EncoderReplacementFallback parameter specifies that the // string, "(unknown)", replace characters that cannot be encoded. // A decoder replacement fallback is also specified, but in this // code example the decoding operation cannot fail. Encoding ae = Encoding.GetEncoding( "us-ascii", new EncoderReplacementFallback("(unknown)"), new DecoderReplacementFallback("(error)")); // The input string consists of the Unicode characters LEFT POINTING // DOUBLE ANGLE QUOTATION MARK (U+00AB), 'X' (U+0058), and RIGHT POINTING // DOUBLE ANGLE QUOTATION MARK (U+00BB). // The encoding can only encode characters in the US-ASCII range of U+0000 // through U+007F. Consequently, the characters bracketing the 'X' character // are replaced with the fallback replacement string, "(unknown)". string inputString = "\u00abX\u00bb"; string decodedString; string twoNewLines = "\n\n"; byte[] encodedBytes = new byte[ae.GetByteCount(inputString)]; int numberOfEncodedBytes = 0; int ix = 0; // -------------------------------------------------------------------------- // Display the name of the encoding. Console.WriteLine("The name of the encoding is \"\".\n", ae.WebName); // Display the input string in text. Console.WriteLine("Input string ( characters): \"\"", inputString.Length, inputString); // Display the input string in hexadecimal. Console.Write("Input string in hexadecimal: "); foreach (char c in inputString.ToCharArray()) < Console.Write("0x", (int)c); > Console.Write(twoNewLines); // -------------------------------------------------------------------------- // Encode the input string. Console.WriteLine("Encode the input string. "); numberOfEncodedBytes = ae.GetBytes(inputString, 0, inputString.Length, encodedBytes, 0); // Display the encoded bytes. Console.WriteLine("Encoded bytes in hexadecimal ( bytes):\n", numberOfEncodedBytes); ix = 0; foreach (byte b in encodedBytes) < Console.Write("0x", (int)b); ix++; if (0 == ix % 6) Console.WriteLine(); > Console.Write(twoNewLines); // -------------------------------------------------------------------------- // Decode the encoded bytes, yielding a reconstituted string. Console.WriteLine("Decode the encoded bytes. "); decodedString = ae.GetString(encodedBytes); // Display the input string and the decoded string for comparison. Console.WriteLine("Input string: \"\"", inputString); Console.WriteLine("Decoded string:\"\"", decodedString); > > /* This code example produces the following results: The name of the encoding is "us-ascii". Input string (3 characters): "«X»" Input string in hexadecimal: 0xAB 0x58 0xBB Encode the input string. Encoded bytes in hexadecimal (19 bytes): 0x28 0x75 0x6E 0x6B 0x6E 0x6F 0x77 0x6E 0x29 0x58 0x28 0x75 0x6E 0x6B 0x6E 0x6F 0x77 0x6E 0x29 Decode the encoded bytes. Input string: "«X»" Decoded string:"(unknown)X(unknown)" */ ' This example demonstrates the EncoderReplacementFallback class. Imports System.Text Class Sample Public Shared Sub Main() ' Create an encoding, which is equivalent to calling the ' ASCIIEncoding class constructor. ' The EncoderReplacementFallback parameter specifies that the ' string, "(unknown)", replace characters that cannot be encoded. ' A decoder replacement fallback is also specified, but in this ' code example the decoding operation cannot fail. Dim erf As New EncoderReplacementFallback("(unknown)") Dim drf As New DecoderReplacementFallback("(error)") Dim ae As Encoding = Encoding.GetEncoding("us-ascii", erf, drf) ' The input string consists of the Unicode characters LEFT POINTING ' DOUBLE ANGLE QUOTATION MARK (U+00AB), 'X' (U+0058), and RIGHT POINTING ' DOUBLE ANGLE QUOTATION MARK (U+00BB). ' The encoding can only encode characters in the US-ASCII range of U+0000 ' through U+007F. Consequently, the characters bracketing the 'X' character ' are replaced with the fallback replacement string, "(unknown)". Dim inputString As String = "«X»" Dim decodedString As String Dim twoNewLines As String = vbCrLf & vbCrLf Dim ix As Integer = 0 Dim numberOfEncodedBytes As Integer = ae.GetByteCount(inputString) ' Counteract the compiler adding an extra byte to the array. Dim encodedBytes(numberOfEncodedBytes - 1) As Byte ' -------------------------------------------------------------------------- ' Display the name of the encoding. Console.WriteLine("The name of the encoding is """"." & vbCrLf, ae.WebName) ' Display the input string in text. Console.WriteLine("Input string ( characters): """"", _ inputString.Length, inputString) ' Display the input string in hexadecimal. ' Each element is converted to an integer with Convert.ToInt32. Console.Write("Input string in hexadecimal: ") Dim c As Char For Each c In inputString.ToCharArray() Console.Write("0x ", Convert.ToInt32(c)) Next c Console.Write(twoNewLines) ' -------------------------------------------------------------------------- ' Encode the input string. Console.WriteLine("Encode the input string. ") numberOfEncodedBytes = ae.GetBytes(inputString, 0, inputString.Length, _ encodedBytes, 0) ' Display the encoded bytes. ' Each element is converted to an integer with Convert.ToInt32. Console.WriteLine("Encoded bytes in hexadecimal ( bytes):" & vbCrLf, _ numberOfEncodedBytes) ix = 0 Dim b As Byte For Each b In encodedBytes Console.Write("0x ", Convert.ToInt32(b)) ix += 1 If 0 = ix Mod 6 Then Console.WriteLine() End If Next b Console.Write(twoNewLines) ' -------------------------------------------------------------------------- ' Decode the encoded bytes, yielding a reconstituted string. Console.WriteLine("Decode the encoded bytes. ") decodedString = ae.GetString(encodedBytes) ' Display the input string and the decoded string for comparison. Console.WriteLine("Input string: """"", inputString) Console.WriteLine("Decoded string:""""", decodedString) End Sub End Class ' 'This code example produces the following results: ' 'The name of the encoding is "us-ascii". ' 'Input string (3 characters): "X" 'Input string in hexadecimal: 0xAB 0x58 0xBB ' 'Encode the input string. 'Encoded bytes in hexadecimal (19 bytes): ' '0x28 0x75 0x6E 0x6B 0x6E 0x6F '0x77 0x6E 0x29 0x58 0x28 0x75 '0x6E 0x6B 0x6E 0x6F 0x77 0x6E '0x29 ' 'Decode the encoded bytes. 'Input string: "X" 'Decoded string:"(unknown)X(unknown)" ' Комментарии
В .NET Framework GetEncoding метод использует базовую платформу для поддержки большинства кодовых страниц. Однако .NET Framework изначально поддерживает некоторые кодировки. Список кодовых страниц см. в разделе Список кодировок. В .NET Core GetEncoding метод возвращает кодировки, которые изначально поддерживаются в .NET Core. В обеих реализациях .NET можно вызвать GetEncodings метод, чтобы получить массив EncodingInfo объектов, содержащий сведения обо всех доступных кодировках.
В дополнение к кодировкам, которые изначально доступны в .NET Core или поддерживаются в конкретной версии платформы .NET Framework, GetEncoding метод возвращает все дополнительные кодировки, которые становятся доступными путем регистрации EncodingProvider объекта. Если одна и та же кодировка зарегистрирована несколькими EncodingProvider объектами, этот метод возвращает последний зарегистрированный.
В .NET 5 и более поздних версиях имя utf-7 кодовой страницы не поддерживается.
Кодовые страницы ANSI могут различаться на разных компьютерах и могут изменяться на одном компьютере, что приводит к повреждению данных. Для наиболее последовательных результатов следует использовать кодировку Юникода, такую как UTF-8 (кодовая страница 65001) или UTF-16, а не конкретную кодовую страницу.
GetEncodingВозвращает кэшированный экземпляр с параметрами по умолчанию. Для получения экземпляра с разными параметрами следует использовать конструкторы производных классов. Например, UTF32Encoding класс предоставляет конструктор, позволяющий включить обнаружение ошибок.
См. также раздел
- EncoderFallback
- EncoderFallback
- GetEncodings()
- Использование классов кодировки символов в .NET
Автоопределение кодировки текста

Я очень люблю программировать, я любитель и первый и последний раз заработал на программировании в далёком 1996 году. Но для автоматизации повседневных задач иногда что-то пишу. Примерно год назад открыл для себя golang. В качестве инструмента создания утилит golang оказался очень удобным. Итак.
Возникла потребность обработать большое количество (больше тысячи, так и вижу улыбки профи) архивных файлов со специальной геофизической информацией. Формат файлов текстовый, простой. Если вдруг интересно то это LAS формат.
LAS файл содержит заголовок и данные.
Данные практически CSV, только разделитель табуляция или пробелы.
А заголовок содержит описание данных и вот в нём обычно содержится русский текст. Это может быть название месторождения, название исследований, записанных в файл и пр.
Файлы эти созданы в разное время и в разных программах, доходит до того, что в одном файле часть в кодировке CP1251, а часть в CP866. Файлы эти мне нужно обработать, а значит понять. Вот и потребовалось определять автоматически кодировку файла.
В итоге изобрёл велосипед на golang и соответственно родилась маленькая библиотечка с возможностью детектировать кодовую страницу.
Про кодировки. Не так давно на хабре была хорошая статья про кодировки Как работают кодировки текста. Откуда появляются «кракозябры». Принципы кодирования. Обобщение и детальный разбор Если хочется понять, что такое “кракозябры” или “кости”, то стоит прочитать.
В начале я накидал своё решение. Потом пытался найти готовое работающее решение на golang, но не вышло. Нашлось два решения, но оба не работают.
- Первое “из коробки”— golang.org/x/net/html/charset функция DetermineEncoding()
- Второе библиотека — saintfish/chardet на github
Обе уверенно ошибаются на некоторых кодировках. Стандартная та вообще почти ничего определить не может по текстовым файлам, оно и понятно, её для html страниц делали.
При поиске часто натыкался на готовые утилиты из мира linux — enca. Нашёл её версию скомпилированную для WIN32, версия 1.12. Её я тоже рассмотрю, там есть забавности. Я прошу сразу прощения за своё полное незнание linux, а значит возможно есть ещё решения которые тоже можно попытаться прикрутить к golang коду, я больше искать не стал.
Сравнение найденных решений на автоопределение кодировки
Подготовил каталог softlandia\cpd тестовые данные с файлами в разных кодировках. Содержимое файлов очень короткое и одинаковое. Одна строка “Русский в кодировке CodePageName”. Дополнил файлами со смешением кодировок и некоторыми сложными случаями и попробовал определить.
Мне кажется, получилось забавно.
| # | Кодировка | html/charset | saintfish/chardet | softlandia/cpd | enca |
|---|---|---|---|---|---|
| 1 | CP1251 | windows-1252 | CP1251 | CP1251 | CP1251 |
| 2 | CP866 | windows-1252 | windows-1252 | CP866 | CP866 |
| 3 | KOI8-R | windows-1252 | KOI8-R | KOI8-R | KOI8-R |
| 4 | ISO-8859-5 | windows-1252 | ISO-8859-5 | ISO-8859-5 | ISO-8859-5 |
| 5 | UTF-8 with BOM | utf-8 | utf-8 | utf-8 | utf-8 |
| 6 | UTF-8 without BOM | utf-8 | utf-8 | utf-8 | utf-8 |
| 7 | UTF-16LE with BOM | utf-16le | utf-16le | utf-16le | ISO-10646-UCS-2 |
| 8 | UTF-16LE without BOM | windows-1252 | ISO-8859-1 | utf-16le | unknown |
| 9 | UTF-16BE with BOM | utf-16le | utf-16be | utf-16be | ISO-10646-UCS-2 |
| 10 | UTF-16BE without BOM | windows-1252 | ISO-8859-1 | utf-16be | ISO-10646-UCS-2 |
| 11 | UTF-32LE with BOM | utf-16le | utf-32le | utf-32le | ISO-10646-UCS-4 |
| 12 | UTF-32LE without BOM | windows-1252 | utf-32le | utf-32le | ISO-10646-UCS-4 |
| 13 | UTF-32BE with BOM | windows-1252 | utf-32be | utf-32be | ISO-10646-UCS-4 |
| 14 | UTF-32BE without BOM | windows-1252 | utf-32be | utf-32be | ISO-10646-UCS-4 |
| 15 | KOI8-R (UPPER) | windows-1252 | KOI8-R | KOI8-R | CP1251 |
| 16 | CP1251 (UPPER) | windows-1252 | CP1251 | CP1251 | KOI8-R |
| 17 | CP866 & CP1251 | windows-1252 | CP1251 | CP1251 | unknown |
Наблюдение 1
enca не определила кодировку у файла UTF-16LE без BOM — это странно, ну ладно. Я попробовал добавить больше текста, но результата не получил.
Наблюдение 2. Проблемы с кодировками CP1251 и KOI8-R
Строка 15 и 16. У команды enca есть проблемы.
Здесь сделаю объяснение, дело в том, что кодировки CP1251 (она же Windows 1251) и KOI8-R очень близки если рассматривать только алфавитные символы.
Таблица CP 1251
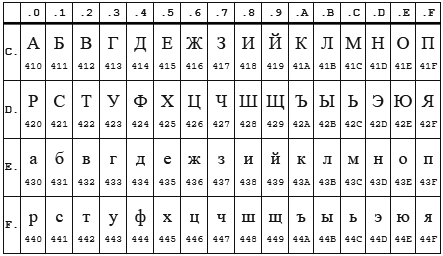
Таблица KOI8-r

В обеих кодировках алфавит расположен от 0xC0 до 0xFF, но там, где у одной кодировки заглавные буквы, у другой строчные. Судя по всему enca, работает по строчным буквам. Вот и получается, если подать на вход программе enca строку “СТП” в кодировке CP1251, то она решит, что это строка “яро” в кодировке KOI8-r, о чём и сообщит. В обратную сторону также работает.
Наблюдение 3
Стандартной библиотеке html/charset можно доверить только определение UTF-8, но осторожно! Пользоваться следует именно charset.DetermineEncoding(), поскольку метод utf8.Valid(b []byte) на файлах в кодировке utf-16be возвращает true.
Собственный велосипед
Автоопределение кодировки возможно только эвристическими методами, неточно. Если мы не знаем, на каком языке и в какой кодировке записан текстовый файл, то определить кодировку с высокой точночностью наверняка можно, но будет сложновато… и нужно будет достаточно много текста.
Для меня такая цель не стояла. Мне достаточно определять кодировки в предположении, что там есть русский язык. И второе, определять нужно по небольшому количеству символов – на 10 символах должно быть достаточно уверенное определение, а желательно вообще на 5–6 символах.
Алгоритм
Когда я обнаружил совпадение кодировок KOI8-r и CP1251 по местоположению алфавита, то на пару дней загрустил… стало понятно, что чуть-чуть придётся подумать. Получилось так.
- Работу будем вести со слайсом байтов, для совместимости с charset.DetermineEncoding()
- Кодировку UTF-8 и случаи с BOM проверяем отдельно
- Входные данные передаём по очереди каждой кодировке. Каждая сама вычисляет два целочисленных критерия. У кого сумма двух критериев больше, тот и выиграл.
Критерии соответствия
Первый критерий
Первым критерием является количество самых популярных букв русского алфавита.
Наиболее часто встречаются буквы: о, е, а, и, н, т, с, р, в, л, к, м, д, п, у. Данные буквы дают 82% покрытия. Для всех кодировок кроме KOI8-r и CP1251 я использовал только первые 9 букв: о, е, а, и, н, т, с, р, в. Этого вполне хватает для уверенного определения.
А вот для KOI8-r и CP1251 пришлось доработать напильником. Коды некоторых из этих букв совпадают, например буква о имеет в CP1251 код 0xEE при этом в KOI8-r этот код у буквы н. Для этих кодировок были взяты следующие популярные буквы. Для CP1251 использовал а, и, н, с, р, в, л, к, я. Для KOI8-r — о, а, и, т, с, в, л, к, м.
Второй критерий
К сожалению, для очень коротких случаев (общая длина русского текста 5-6 символов) встречаемость популярных букв на уровне 1-3 шт и происходит нахлёст кодировок KOI8-r и CP1251. Пришлось вводить второй критерий. Подсчёт количества пар согласная+гласная.
Такие комбинации ожидаемо наиболее часто встречаются в русском языке и соответственно в той кодировке в которой число таких пар больше, та кодировка имеет больший критерий.
Вычисляются оба критерия, складываются и полученная сумма является итоговым критерием.
Результат отражен в таблице выше.
Особенности, с которыми я столкнулся
Чуть коснусь прелестей и проблем, связанных с golang. Раздел может быть интересен только начинающим писать на golang.
Проблемы
Лично походил по некоторым подводным камушкам из 50 оттенков Go: ловушки, подводные камни и распространённые ошибки новичков.
Излишне переживая и пытаясь дуть на воду, прослышав от других о страшных ожогах от молока, переборщил с проверкой входного параметра типа io.Reader. Я проверял переменную типа io.Reader с помощью рефлексии.
//CodePageDetect - detect code page of ascii data from reader 'r' func CodePageDetect(r io.Reader, stopStr . string) (IDCodePage, error) < if !reflect.ValueOf(r).IsValid() < return ASCII, fmt.Errorf("input reader is nil") >. Но как оказалось в моём случае достаточно проверить на nil. Теперь всё стало проще
func CodePageDetect(r io.Reader, stopStr . string) (IDCodePage, error) < //test input interfase if r == nil < return ASCII, nil >//make slice of byte from input reader buf, err := bufio.NewReader(r).Peek(ReadBufSize) if (err != nil) && (err != io.EOF) < return ASCII, err >. вызов bufio.NewReader( r ).Peek(ReadBufSize) спокойно проходит следующий тест:
var data *os.File res, err := CodePageDetect(data)
В этом случае Peek() возвращает ошибку.
Разок наступил на грабли с передачей массивов по значению. Немного тупанул на попытке изменять элементы, хранящиеся в map, пробегая по ним в range…
Прелести
Сложно сказать что конкретно, постоянное ли битьё по рукам от линтера и компилятора или активное использование range, или всё вместе, но практически отсутствуют залёты по выходу индекса за пределы.
Конечно, очень приятно жить со сборщиком мусора. Полагаю мне ещё предстоит освоить грабли автоматизации выделения/освобождения памяти, но пока дебильная улыбка не покидает лица.
Строгая типизация — тоже кусочек счастья.
Переменные, имеющие тип функции — соответственно лёгкая реализация различного поведения у однотипных объектов.
Странно мало пришлось сидеть в отладчике, перечитывание кода обычно даёт результат.
Щенячий восторг от наличия массы инструментов из коробки, это чудное ощущение, когда компилятор, язык, библиотека и IDE Visual Studio Code работают на тебя вместе, слаженно.
Спасибо falconandy за конструктивные и полезные советы
Благодаря ему
- перевёл тесты на testify и они действительно стали более читабельны
- исправил в тестах пути к файлам данных для совместимости с Linux
- прошёлся линтером — таки он нашёл одну реальную ошибку (проклятущий copy/past)
Продолжаю добавлять тесты, выявился случай не определения UTF16. Обновил. Теперь UTF16 и LE и BE определяются даже в случае отсутствия русских букв