Комплексное руководство по сверточным нейронным сетям для чайников
В сфере Искусственного интеллекта наблюдается стремительный рывок в устранении разрыва между возможностями человека и машин. И ученые, и любители, работая над многочисленными проблемами в этой области, делают удивительные вещи. Одним из многих таких направлений является Computer Vision (компьютерное зрение).
Повестка дня в этой области состоит в том, чтобы дать возможность машинам видеть мир так, как это делают люди, воспринимать его схожим образом и даже использовать знания для множества задач, таких как Распознавание Изображений и Видео, Анализ и Классификация Изображений, Восстановление Медиа, Системы Рекомендаций, Обработка Естественного языка и т.д. Достижения в области Computer Vision и Deep Learning были разрабатывались и совершенствовались с течением времени, главным образом благодаря совершенно конкретному алгоритму — Сверточной нейронной сети (Convolutional Neural Network).
Введение
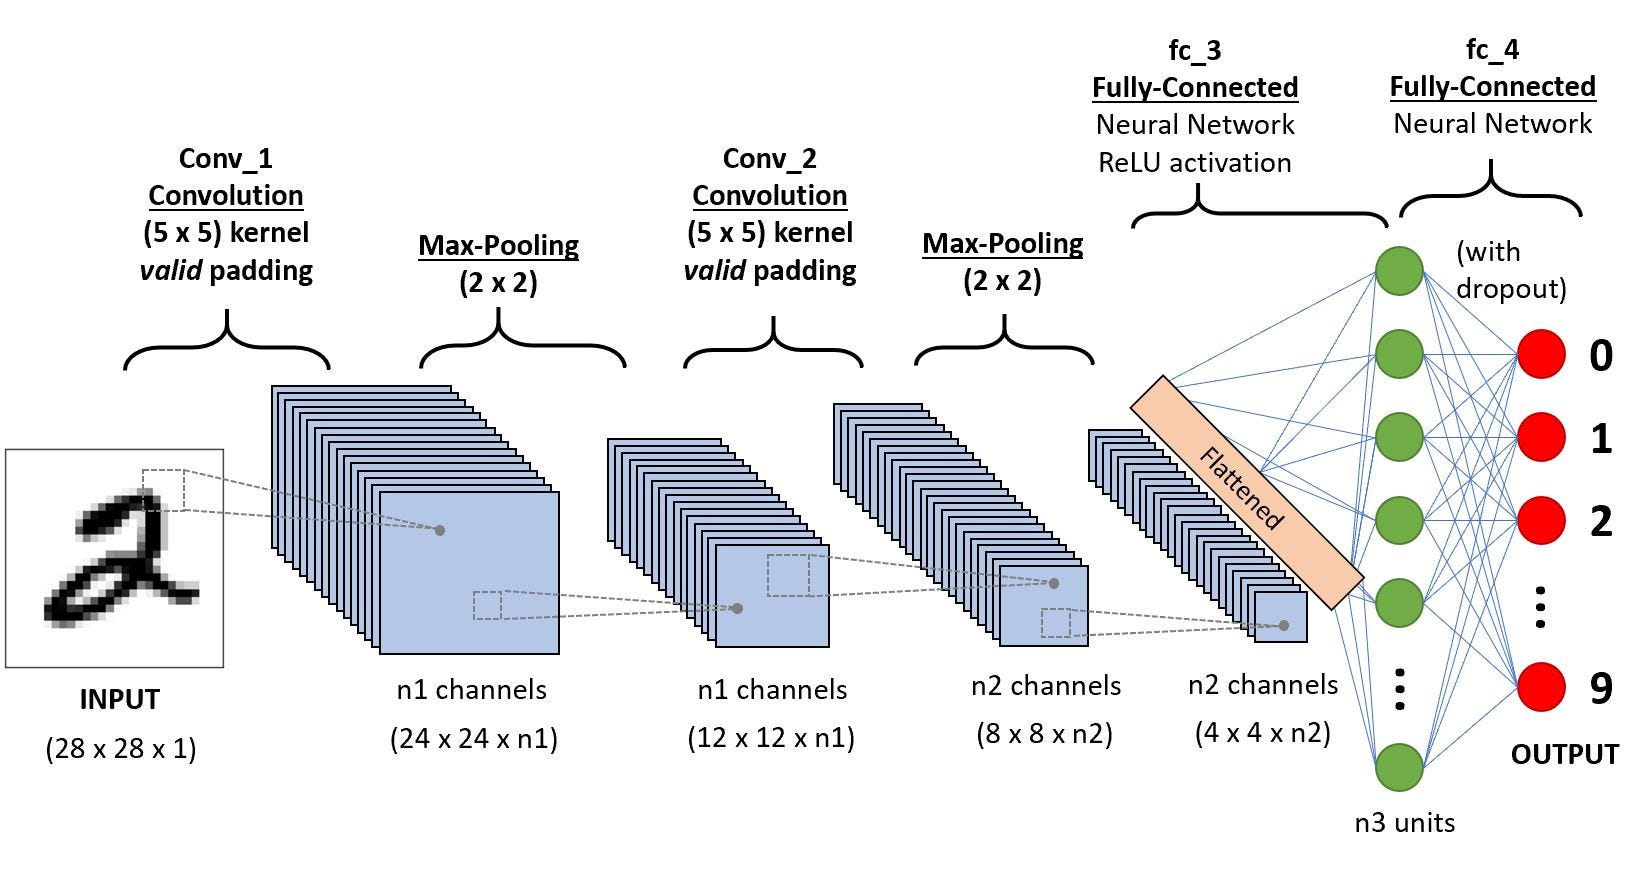
CNN-последовательность для классификации рукописных цифр
Сверточная нейронная сеть (Convolutional Neural Network — ConvNet/CNN) — это Deep Learning-алгоритм, который может принимать входное изображение, присваивать важность (усваиваемые веса и смещения) различным областям/объектам в изображении и может отличать одно от другого. Предварительной обработки в ConvNet требуется значительно меньше по сравнению с другими алгоритмами классификации. В то время как в примитивных методах фильтры сконструированы вручную, ConvNets при достаточном обучении способны изучать эти фильтры/характеристики.
Архитектура ConvNet схожа с архитектурой связности нейронов в человеческом мозге и была вдохновлена организацией зрительной коры. Отдельные нейроны реагируют на раздражители только в ограниченной зоне поля зрения, известной как рецептивное поле. Совокупность таких полей накладывается, чтобы покрыть всю зону поля зрения.
ConvNets или Feed-Forward Neural Nets (FF, FFNN — Нейронные сети прямого распространения)?

Сглаживание матрицы изображения 3х3 по вектору 9х1
На изображении не что иное, как матрица пиксельных значений, верно? Так почему бы просто не сгладить изображение (например, матрицу изображения 3×3 по вектору 9×1) и передать его в многослойный персептрон для классификации? Ну… Все не так просто.
В случае очень простых двоичных изображений этот метод может показывать среднюю оценку точности при прогнозировании классов, но когда речь идет о сложных изображениях, имеющих повсеместную зависимость от пикселей, ни о какой точности не может идти и речи.
ConvNet хорошо умеет захватывать пространственно-временные зависимости в изображении с помощью соответствующих фильтров. Архитектура обеспечивает лучшее совпадение с набором данных изображения благодаря уменьшению количества задействованных параметров и возможности повторного использования весов. Другими словами, сеть можно научить лучше понимать сложность изображения.
Входное изображение
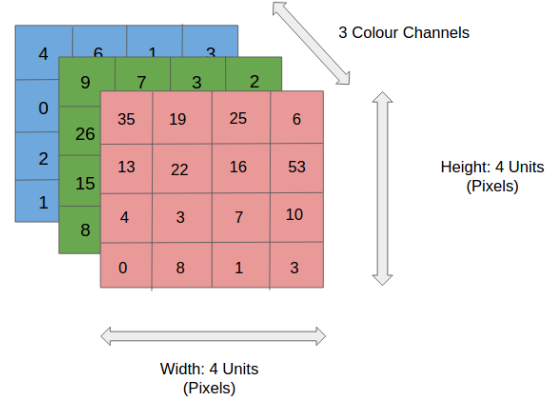
RGB-картинка 4x4x3
На рисунке у нас есть RGB-изображение, разделенное по трем цветовым плоскостям — красной, зеленой и синей. Существует несколько таких цветовых пространств, в которых существуют изображения: Grayscale (оттенки серого), RGB, HSV, CMYK и т.д.
Можете представить, что станет с вычислительными ресурсами, когда изображения достигнут размеров, скажем, 8K (7680 × 4320). ConvNet нужен, чтобы преобразовать изображения в ту форму, которую легче обрабатывать без потери характеристик, которые имеют решающую роль для получения хорошего прогноза. Это важно, когда мы хотим разработать архитектуру, которая будет не просто хороша в обучении, но еще и масштабируема для массивных наборов данных.
Сверточный слой — Кернел (the kernel)
Свертывание изображения 5x5x1 с кернелом размерностью 3x3x1 для получения свернутой функции 3x3x1
Размеры изображения = 5 (высота) x 5 (ширина) x 1 (количество каналов, например, RGB)
На гифке выше видно, что зеленая часть напоминает наше входное изображение 5x5x1, I. Элемент, участвующий в выполнении операции свертки в первой части сверточного слоя, называется кернелом/фильтром, K, показан желтым цветом. Мы выбрали K в качестве матрицы 3x3x1.
Кернел смещается 9 раз, так как длина страйда (Stride) = 1, каждый раз выполняя операцию умножения матриц между K и частью P изображения, над которым кернел зависает.
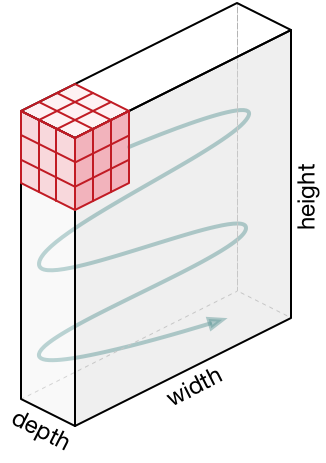
Передвижение кернела
Фильтр двигается вправо с определенным значением страйда до тех пор, пока он не проанализирует всю ширину. Двигаясь дальше, он переходит к началу (слева) изображения с тем же значением шага и повторяет процесс до тех пор, пока не будет пройдено все изображение.
Операция свертки на матрице изображения MxNx3 с кернелом размерностью 3x3x3
В случае, когда у изображения несколько каналов (например, RGB), кернел имеет ту же глубину, что и входное изображение. Матричное умножение выполняется между стэками Kn и In ([K1, I1]; [K2, I2]; [K3, I3]), и все результаты суммируются со смещением, чтобы выдать нам сжатый выходной сигнал одной глубины.
Операция свертки с длиной страйда = 2
Цель операции свертки — извлечь из входного изображения высокоуровневые признаки, например, линии, края. ConvNets вовсе не обязательно должны быть ограничены только одним сверточным слоем. Традиционно, первый ConvLayer отвечает за захват низкоуровневых признаков, таких как края, цвет, градиентная ориентация и т.д. Благодаря добавленным слоям архитектура адаптируется также к высокоуровневым признакам, выдавая нам сеть, которая имеет столь же здравое понимание изображений в наборе данных, что и мы.
Эта операция может давать два типа результатов: один, в котором свернутый признак имеет меньшую размерность по сравнению с входным, в другом же размерность либо увеличивается, либо остается неизменной. Это делается путем применения паддинга без дополнения (Valid Padding) в случае первого или паддинга с дополнением нулями (Same Padding) в случае последнего.
Same-паддинг: изображение 5x5x1 дополняется (is padded) нулями, чтобы создать изображение 6x6x1
Когда мы преобразуем изображение 5x5x1 в изображение 6x6x1, а затем применяем к нему кернел размерностью 3x3x1, мы обнаруживаем, что размер свернутой матрицы — 5x5x1. Отсюда и название — Same-паддинг.
В то же время если мы выполним ту же операцию без паддинга, мы получим матрицу, которая имеет размеры самого кернела (3x3x1) — Valid-паддинг.
В данном репозитории хранится множество таких GIF-файлов, которые помогут вам лучше понять, как взаимодействуют паддинг и длина страйда для достижения результатов, соответствующих нашим потребностям.
Пулинговый слой (Pooling Layer)
3×3 преобразуется с помощью пулинга в сложную функцию 5×5
Подобно сверточному слою, пулинговый слой необходим для уменьшения размера свернутого элемента в пространстве. Это помогает уменьшить вычислительную мощность, необходимую для обработки данных, за счет уменьшения размерности. Кроме того, это важно и для извлечения доминирующих признаков, инвариантных вращения и позиционирования, таким образом поддерживая процесс эффективного обучения модели.
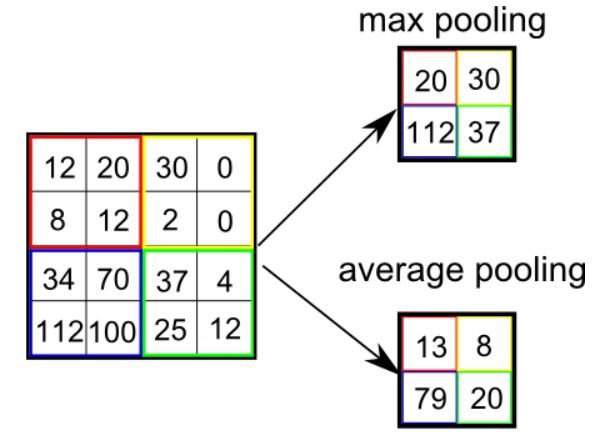
Существует два типа пулинга: максимальный (Max Pooling) и средний (Average Pooling). Максимальный пулинг возвращает максимальное значение из части изображения, покрываемой кернелом. А Средний пулинг возвращает среднее всех значений из части изображения, покрываемой кернелом.
Максимальный пулинг также выступает в роли шумоподавителя (Noise Suppressant). Он полностью исключает шумовые сигналы, а также совмещает подавление шума с уменьшением размерности. Средний же пулинг просто использует уменьшение размерности как способ подавления шума. То есть можно сказать, что Max Pooling работает намного лучше, чем Average Pooling.
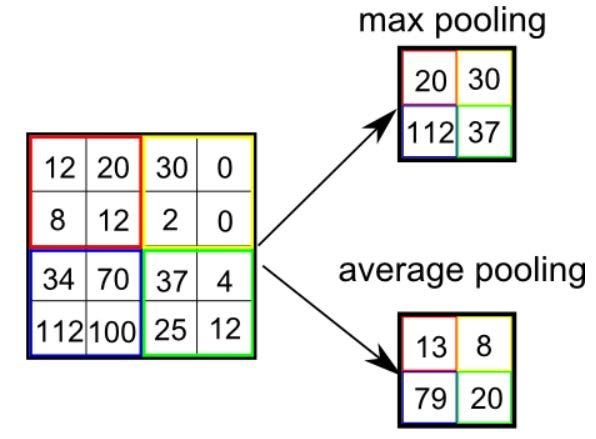
Типы пулинга
Сверточный слой и пулинговый слой вместе образуют i-й слой сверточной нейронной сети. В зависимости от сложности изображений количество таких слоев может быть увеличено с целью еще более точного захвата деталей низкого уровня, но ценой большей вычислительной мощности.
Выполнение описанного выше процесса позволяет модели успешно изучить признаки. Далее мы сглаживаем окончательный результат и передаем его в обычную нейронную сеть в целях классификации.
Классификация — Полностью Связанный Слой (Fully Connected Layer, FC Layer)

Добавление FC Layer — это (обычно) дешевый способ изучить нелинейные комбинации высокоуровневых признаков, представленных выходными данными сверточного слоя. FC Layer изучает возможную нелинейную функцию в этом пространстве.
Теперь, когда мы преобразовали наше входное изображение в подходящий формат для нашего многослойного персептрона, мы сведем изображение в вектор-столбец. Сглаженный вывод подается в нейронную сеть с прямой связью, и затем к каждой итерации обучения применяется обратное распространение. После серии эпох (epochs) модель способна различать доминирующие и некоторые низкоуровневые признаки изображений и классифицировать их с помощью техники Softmax.
Существуют множество архитектур доступных CNN, которые сыграли ключевую роль в построении алгоритмов, которые обеспечивают сейчас и будут обеспечивать работу Искусственного интеллекта как такового в ближайщем будущем. Некоторые из них перечисляю ниже:
Сверточная нейронная сеть – простое объяснение CNN и её применение
Сверточная нейронная сеть — СНС, CNN – основной инструмент для классификации и распознавания объектов, лиц на фотографиях, распознавания речи. Есть множество вариантов применения CNN, такие как Deep Convolutional Neural Network (DCNN), Region-CNN (R-CNN), Fully Convolutional Neural Networks (FCNN), Mask R-CNN и другие.
Мы будем говорить в первую очередь о CNN для изображений, но “свертка” – универсальная операция. Её можно применить для любого сигнала, будь то данные с датчиков, аудиосигнал или картинка.
Поскольку все статьи о сверточных сетях начинаются со сложного и непонятного объяснения что такое свертка, мы не будем об этом писать. Это совершенно необязательное знание, если вы не планируете стать математиком в области нейронных сетей.
Итак, у нас стоит задача выделить на картинке какой-то объект, например, автомобиль. Человек легко понимает что перед ним автомобиль и распознает его по тысяче мелких признаков. Но как обучить машину что “этот набор точек на картинке – автомобиль”? Ответ на этот вопрос лежит не в понятии сверточной сети – с этой задачей может справиться и самая старая нейронная сеть на персептронах.
Сверточная же нейронная сеть за счет применения специальной операции – собственно свертки – позволяет одновременно уменьшить количество хранимой в памяти информации, за счет чего лучше справляется с картинками более высокого разрешения, и выделить опорные признаки изображения, такие как ребра, контуры или грани. На следующем уровне обработки из этих ребер и граней можно распознать повторяемые фрагменты текстур, которые дальше могут сложиться в фрагменты изображения.
По сути каждый слой нейронной сети использует собственное преобразование. Если на первых слоях сеть оперирует такими понятиями как “ребра”, “грани” и т.п, то дальше используются понятия “текстура”, “части объектов”. В результате такой проработки мы можем правильно классифицировать картинку или выделить на конечном шаге искомый объект на изображении.

Для чего применяют сверточные нейронные сети?
Сверточные нейронные сети применяются довольно широко и в различных областях. Ниже мы рассмотрим простые прикладные примеры того, как можно применять GAN и CNN в бизнесе.
Классификация изображений и сигналов с помощью нейросетей
Первой и, по сути, самой тривиальной задачей, которую научились решать с помощью нейронных сетей, стала классификация изображений. Как мы уже писали выше, большинство примеров указано именно на изображениях. Но, по сути, можно классифицировать любые сигналы.

Классификации с помощью CNN активно применяются в медицине: можно обучить нейронную сеть классификации болезней или симптомов, например, для МРТ-диагностики.

В агробизнесе разрабатывается и внедряется методика анализа и распознавания изображений, при которой данные получают от открытых спутников, таких как LSAT, и используют для прогнозирования будущей урожайности конкретных земель.

Распознавание объектов – object detection – с помощью нейронных сетей
Распознавание объектов на фото и видео с помощью нейронных сетей применяется в беспилотном транспорте, видеонаблюдении, системах контроля доступа, системах “умного дома” и так далее.

Встречается также маскированное распознавание объектов с выделением контура, при котором мы также можем получать четкие контуры объекта при помощи сверточных нейронных сетей.

Определение марки и модели конкретной техники с помощью машинного обучения
Определить конкретную модель и марку объекта среди нескольких визуально очень похожих? Возможно. Более того, мы в Evergreen уже решили эту задачу машинного обучения в кейсе определения модели пульта по фото. Кейс решался при помощи нейронных сетей с использованием фреймворка Tensorflow.
Нейронные сети для распознавания лиц и людей
Распознавание лиц означает возможность выделять лица на изображениях. А затем, при помощи нейросетей CNN, распознавать лицо конкретного человека. Видеодемонстрацию того, как работает распознавание лиц на базе нейронных сетей, сделанное в Evergreen, можно посмотреть здесь.

Также нейронные сети можно использовать для выделения людей или отдельных частей тела человека на фото или видео, для построения их скелетов, поз. Такой подход применяется, например, для видеоаналитики.

Трехмерная реконструкция лиц и объектов по фотографии при помощи сверточных нейронных сетей
На данный момент существует несколько конкурирующих моделей, позволяющих получить трехмерные модели лица (3DMM) всего по одной фотографии. Помимо реконструкции лиц сверточные сети применяют также для реконструкции других трехмерных объектов по фото.

Распознавание речи и анализ эмоциональной тональности текста
Сверточные нейронные сети можно применять не только для решения задач компьютерного зрения. Например, недавно Facebook AI Research выложила в открытый доступ wav2letter ++ – свою технологию распознавания речи, основанную на CNN.
Также существуют статьи и исследования специалистов AI-сферы, в которых предлагается применять CNN для анализа эмоциональной тональности текста, то есть области, вообще далекой от сигналов и изображений.
Вместо заключения: что можно реально разработать, используя сверточные нейронные сети CNN
CNN на сегодня – “рабочая лошадка” в области нейронных сетей. Используется преимущественно для решения задач компьютерного зрения, хотя может применяться также для работы с аудио и любыми данными, которые можно представить в виде матриц.
У нас в Evergreen уже есть целый ряд кейсов с использованием этой технологии: и распознавание техпаспортов, а также загранпаспортов, и поиск точной модели техники по фотографии в базе интернет-магазина. Мы также активно продвигаем идею использовать распознавание и классификацию документов по фото вместе с RPA для повышения эффективности бизнес-процессов.
Есть идея, какую рутинную работу по распознаванию или классификации вы хотите переложить на машину? Поделитесь ею с нами. Мы будем рады найти подходящий метод решения.
Наглядно о том, как работает свёрточная нейронная сеть

К старту курса о машинном и глубоком обучении мы решили поделиться переводом статьи с наглядным объяснением того, как работают CNN — сети, основанные на принципах работы визуальной коры человеческого мозга. Ненавязчиво, как бы между строк, автор наталкивает на размышления о причинах эффективности CNN и на простых примерах разъясняет происходящие внутри этих нейронных сетей преобразования.
Начинаем сначала
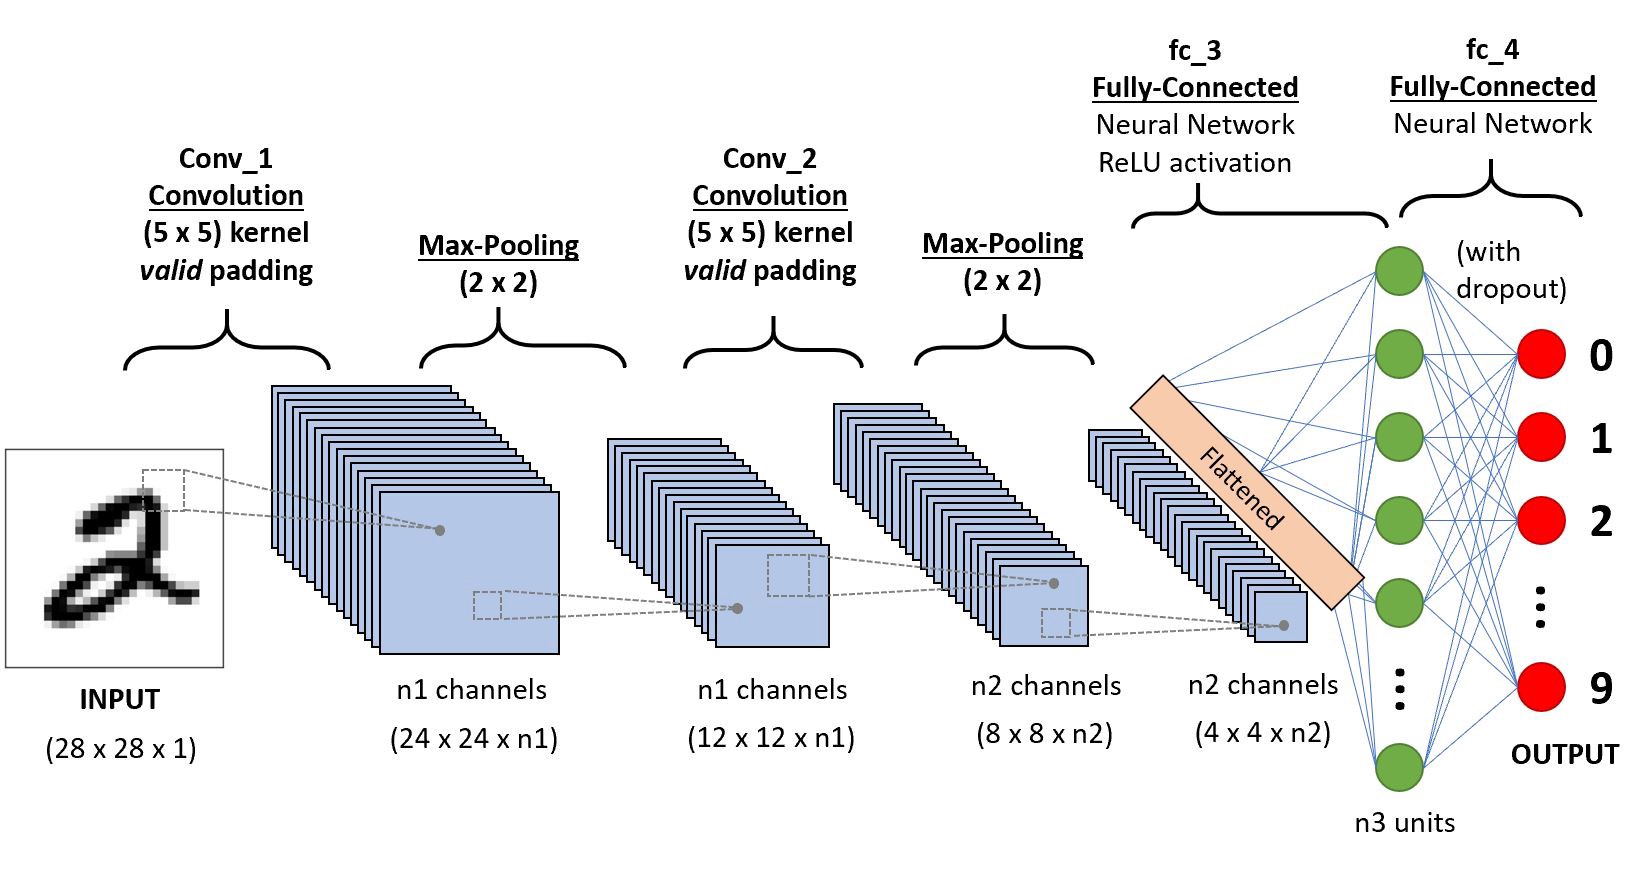
Свёрточная нейронная сеть (ConvNet/CNN) — это алгоритм глубокого обучения, который может принимать входное изображение, присваивать важность (изучаемые веса и смещения) аспектам или объектам изображении и отличать одно от другого. При этом изображения в сравнении с другими алгоритмами требуют гораздо меньше предварительной обработки. В примитивных методах фильтры разрабатываются вручную, но достаточно обученные сети CNN учатся применять эти фильтры/характеристики.
Архитектура CNN аналогична структуре связей нейронов в мозгу человека, учёные черпали вдохновение в организации зрительной коры головного мозга. Отдельные нейроны реагируют на стимулы только в некоторой области поля зрения, также известного как перцептивное поле. Множество перцептивных полей перекрывается, полностью покрывая поле зрения CNN.
Почему слои свёртки расположены над сетью с прямой связью

Изображение — не что иное, как матрица значений пикселей, верно? Так почему бы не сделать его плоским (например, матрицу 3×3 сделать вектором 9×1) и скормить этот вектор многослойному перцептрону, чтобы тот выполнил классификацию? Хм… всё не так просто.
В случаях простейших двоичных изображений при выполнении прогнозирования классов метод может показать среднюю точность, но на практике, когда речь пойдёт о сложных изображениях, в которых повсюду пиксельные зависимости, он окажется неточным.
Сеть CNN способна с успехом схватывать пространственные и временные зависимости в изображении через применение соответствующих фильтров. Такая архитектура за счёт сокращения числа задействованных параметров и возможности повторного использования весов даёт лучшее соответствие набору данных изображений. Иными словами, сеть можно научить лучше понимать сложность изображения.
Входное изображение
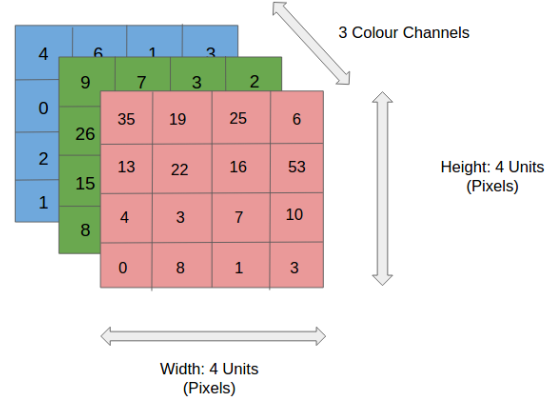
На рисунке мы видим разделённое на три цветовых плоскости (красную, зелёную и синюю) RGB-изображение, которое можно описать в разных цветовых пространствах — в оттенках серого (Grayscale), RGB, HSV, CMYK и т. д.
Можно представить, насколько интенсивными будут вычисления, когда изображения достигнут размеров, например, 8 K (76804320). Роль CNN заключается в том, чтобы привести изображения в форму, которую легче обрабатывать, без потери признаков, имеющих решающее значение в получении хорошего прогноза. Это важно при разработке архитектуры, которая не только хорошо изучает функции, но и масштабируется для массивных наборов данных.
Слой свёртки — ядро
- 5 — высота;
- 5 — ширина;
- 1 — количество каналов, например, RGB.
В демонстрации выше зелёная секция напоминает наше входное изображение 5×5×1. Элемент, участвующий в выполнении операции свёртки в первой части слоя свёртки, называется ядром/фильтром K, он представлен жёлтым цветом. Пусть K будет матрицей 3×3×1:
Kernel/Filter, K = 1 0 1 0 1 0 1 0 1Ядро смещается 9 раз из-за длины шага в единицу (то есть шага нет), каждый раз выполняя операцию умножения матрицы K на матрицу P, над которой находится ядро.

Фильтр перемещается вправо с определённым значением шага, пока не проанализирует всю ширину. Двигаясь дальше, он переходит к началу изображения (слева) с тем же значением шага и повторяет процесс до тех пор, пока не проходит всё изображение.
В случае изображений с несколькими каналами (например, RGB) ядро имеет ту же глубину, что и у входного изображения. Матричное умножение выполняется между стеками Kn и In ([K1, I1]; [K2, I2]; [K3, I3]), все результаты суммируются со смещением, чтобы получить уплощённый канал вывода свёрнутых признаков с глубиной в 1.
Свёртка делается, чтобы извлечь высокоуровневые признаки, например края входного изображения. Сеть не нужно ограничивать единственным слоем. Первый слой условно несёт ответственность за схватывание признаков низкого уровня, таких как кромки, цвет, ориентация градиента и т. д. Через дополнительные слои архитектура адаптируется к признакам высокого уровня, мы получаем сеть со здравым пониманием изображений в наборе данных, похожем на наше.
У результатов свёртки два типа: первый — свёрнутый признак уменьшается в размере по сравнению с размером на входе, второй тип касается размерности — она либо остаётся прежней, либо увеличивается. Это делается путём применения допустимого заполнения в первом случае или нулевого заполнения — во втором.
Увеличивая изображение 5×5×1 до 6×6×1, а затем проходя над ним ядром 3×3×1, мы обнаружим, что свёрнутая матрица будет обладать разрешением 5×5×1. Отсюда и название — нулевое заполнение. С другой стороны, проделав то же самое без заполнения, мы обнаружим матрицу с размерами самого ядра (3×3×1); эта операция называется допустимым заполнением.
В этом репозитории содержится множество таких GIF-файлов, они помогут лучше понять, как заполнение и длина шага работают вместе для достижения необходимых результатов.
Слой объединения
Подобно свёрточному слою, слой объединения отвечает за уменьшение размера свёрнутого объекта в пространстве. Это делается для уменьшения необходимой при обработке данных вычислительной мощности за счёт сокращения размерности. Кроме того, это полезно для извлечения доминирующих признаков, которые являются вращательными и позиционными инвариантами, тем самым позволяя поддерживать процесс эффективного обучения модели.
Есть два типа объединения: максимальное и среднее. Первое возвращает максимальное значение из покрытой ядром части изображения. А среднее объединение возвращает среднее значение из всех значений покрытой ядром части.
Максимальное объединение также выполняет функцию шумоподавления. Оно полностью отбрасывает зашумленные активации, а также устраняет шум вместе с уменьшением размерности. С другой стороны, среднее объединение для подавления шума просто снижает размерность. Значит, можно сказать, что максимальное объединение работает намного лучше среднего объединения.
Слои объединения и свёртки вместе образуют i-тый слой свёрточной нейронной сети. Количество таких слоёв может быть увеличено в зависимости от сложности изображений, чтобы лучше схватывать детали, но это делается за счёт увеличения вычислительной мощности.
Выполнение процесса выше позволяет модели понимать особенности изображения. Преобразуем результат в столбцовый вектор и скормим его обычной классифицирующей нейронной сети.
Классификация — полносвязный слой

Добавление полносвязного слоя — это (обычно) вычислительно недорогой способ обучения нелинейным комбинациям высокоуровневых признаков, которые представлены на выходе слоя свёртки. Полносвязный слой изучает функцию в этом пространстве, которая может быть нелинейной.
После преобразования входного изображения в подходящую для многоуровневого перцептрона форму мы должны сгладить изображение в вектор столбец. Сглаженный выходной сигнал подаётся на нейронную сеть с прямой связью, при этом на каждой итерации обучения применяется обратное распространение. За серию эпох модель обретает способность различать доминирующие и некоторые низкоуровневые признаки в изображениях и классифицировать их методом классификации Softmax.
У CNN есть различные архитектуры, сыгравшие ключевую роль в построении алгоритмов, на которых стоит и в обозримом будущем будет стоять искусственный интеллект в целом. Некоторые из этих архитектур перечислены ниже:
- LeNet;
- AlexNet;
- VGGNet;
- GoogLeNet;
- ResNet;
- ZFNet.
Репозиторий с проектом по распознаванию цифр.
CNN имеет огромное количество практических приложений; и если вам интересны эксперименты и поиски в области ИИ, обратите внимание на наш курс о машинном и глубоком обучении или прокачайтесь в работе с данными или освойте перспективную специальность с помощью нашего флагманского курса о Data Science.
Узнайте, как прокачаться и в других специальностях или освоить их с нуля:
- Профессия Data Analyst
- Курс по Data Engineering
ПРОФЕССИИ
- Профессия Fullstack-разработчик на Python
- Профессия Java-разработчик
- Профессия QA-инженер на JAVA
- Профессия Frontend-разработчик
- Профессия Этичный хакер
- Профессия C++ разработчик
- Профессия Разработчик игр на Unity
- Профессия Веб-разработчик
- Профессия iOS-разработчик с нуля
- Профессия Android-разработчик с нуля
КУРСЫ
- Курс по Machine Learning
- Курс «Machine Learning и Deep Learning»
- Курс «Математика для Data Science»
- Курс «Математика и Machine Learning для Data Science»
- Курс «Python для веб-разработки»
- Курс «Алгоритмы и структуры данных»
- Курс по аналитике данных
- Курс по DevOps
Сверточные нейронные сети
Сверточная нейронная сеть (англ. convolutional neural network, CNN) — специальная архитектура нейронных сетей, предложенная Яном Лекуном [1] , изначально нацеленная на эффективное распознавание изображений.
Свертка
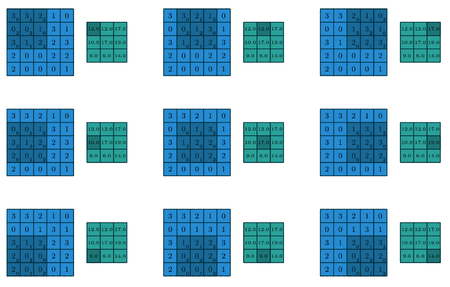
Рисунок 1.Пример свертки двух матриц размера 5×5 и 3×3
Свертка (англ. convolution) — операция над парой матриц [math]A[/math] (размера [math]n_x\times n_y[/math] ) и [math]B[/math] (размера [math]m_x \times m_y[/math] ), результатом которой является матрица [math]C = A * B[/math] размера [math](n_x-m_x+1)\times (n_y-m_y+1)[/math] . Каждый элемент результата вычисляется как скалярное произведение матрицы [math]B[/math] и некоторой подматрицы [math]A[/math] такого же размера (подматрица определяется положением элемента в результате). То есть, [math]C_ = \sum_^\sum_^A_B_[/math] . На Рисунке 1 можно видеть, как матрица [math]B[/math] «двигается» по матрице [math]A[/math] , и в каждом положении считается скалярное произведение матрицы [math]B[/math] и той части матрицы [math]A[/math] , на которую она сейчас наложена. Получившееся число записывается в соответствующий элемент результата.
Логический смысл свертки такой — чем больше величина элемента свертки, тем больше эта часть матрицы [math]A[/math] была похожа на матрицу [math]B[/math] (похожа в смысле скалярного произведения). Поэтому матрицу [math]A[/math] называют изображением, а матрицу [math]B[/math] — фильтром или образцом.
Структура сверточной нейронной сети
В сверточной нейронной сети выходы промежуточных слоев образуют матрицу (изображение) или набор матриц (несколько слоёв изображения). Так, например, на вход сверточной нейронной сети можно подавать три слоя изображения (R-, G-, B-каналы изображения). Основными видами слоев в сверточной нейронной сети являются сверточные слои (англ. convolutional layer), пулинговые слои (англ. pooling layer) и полносвязные слои (англ. fully-connected layer).
Сверточный слой
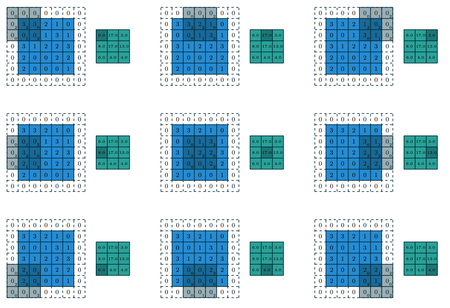
Рисунок 2.Пример свертки двух матриц с дополнением нулями и сдвигом 2
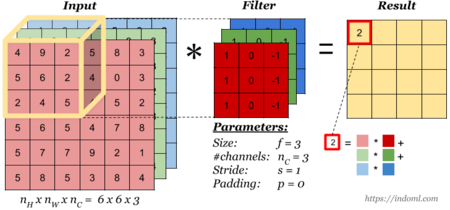
Рисунок 3.Пример свертки с трехмерным ядром
Сверточный слой нейронной сети представляет из себя применение операции свертки к выходам с предыдущего слоя, где веса ядра свертки являются обучаемыми параметрами. Еще один обучаемый вес используется в качестве константного сдвига (англ. bias). При этом есть несколько важных деталей:
- В одном сверточном слое может быть несколько сверток. В этом случае для каждой свертки на выходе получится своё изображение. Например, если вход имел размерность [math]w\times h[/math] , а в слое было [math]n[/math] сверток с ядром размерности [math]k_x\times k_y[/math] , то выход будет иметь размерность [math]n\times(w — k_x + 1)\times(h — k_y + 1)[/math] ;
- Ядра свертки могут быть трёхмерными. Свертка трехмерного входа с трехмерным ядром происходит аналогично, просто скалярное произведение считается еще и по всем слоям изображения. Например, для усреднения информации о цветах исходного изображения, на первом слое можно использовать свертку размерности [math]3\times w \times h[/math] . На выходе такого слоя будет уже одно изображение (вместо трёх);
- Можно заметить, что применение операции свертки уменьшает изображение. Также пиксели, которые находятся на границе изображения участвуют в меньшем количестве сверток, чем внутренние. В связи с этим в сверточных слоях используется дополнение изображения (англ. padding). Выходы с предыдущего слоя дополняются пикселями так, чтобы после свертки сохранился размер изображения. Такие свертки называют одинаковыми (англ. same convolution), а свертки без дополнения изображения называются правильными (англ. valid convolution). Среди способов, которыми можно заполнить новые пиксели, можно выделить следующие:
- zero shift: 00[ABC]00 ;
- border extension: AA[ABC]CC ;
- mirror shift: BA[ABC]CB ;
- cyclic shift: BC[ABC]AB .
- Еще одним параметром сверточного слоя является сдвиг (англ. stride). Хоть обычно свертка применяется подряд для каждого пикселя, иногда используется сдвиг, отличный от единицы — скалярное произведение считается не со всеми возможными положениями ядра, а только с положениями, кратными некоторому сдвигу [math]s[/math] . Тогда, если если вход имел размерность [math]w\times h[/math] , а ядро свертки имело размерность [math]k_x\times k_y[/math] и использовался сдвиг [math]s[/math] , то выход будет иметь размерность [math]\lfloor\frac+ 1\rfloor\times\lfloor\frac+ 1\rfloor[/math] .
Пулинговый слой

Рисунок 4. Пример операции пулинга с функцией максимума
Пулинговый слой призван снижать размерность изображения. Исходное изображение делится на блоки размером [math]w\times h[/math] и для каждого блока вычисляется некоторая функция. Чаще всего используется функция максимума (англ. max pooling) или (взвешенного) среднего (англ. (weighted) average pooling). Обучаемых параметров у этого слоя нет. Основные цели пулингового слоя:
- уменьшение изображения, чтобы последующие свертки оперировали над большей областью исходного изображения;
- увеличение инвариантности выхода сети по отношению к малому переносу входа;
- ускорение вычислений.
Inception module
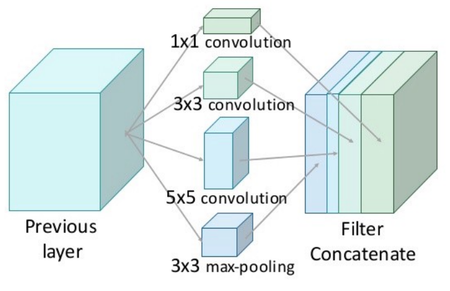
Рисунок 5.Inception module
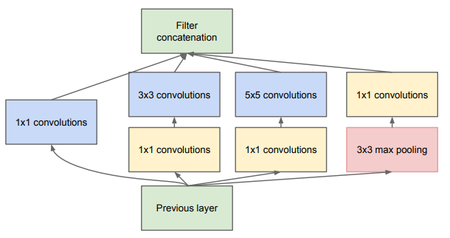
Рисунок 6.Inception module с сокращением размерностей
Inception module — это специальный слой нейронной сети, который был предложен в работе [2] , в которой была представлена сеть GoogLeNet. Основная цель этого модуля заключается в следующем. Авторы предположили, что каждый элемент предыдущего слоя соответствует определенной области исходного изображения. Каждая свертка по таким элементам будет увеличивать область исходного изображения, пока элементы на последних слоях не будут соответствовать всему изображению целиком. Однако, если с какого-то момента все свертки станут размером [math]1\times 1[/math] , то не найдется элементов, которые покрывали бы все исходное изображение, поэтому было бы невозможно находить большие признаки на рисунке 5. Чтобы решить эту проблему, авторы предложили так называемый inception module — конкатенацию выходов для сверток размера [math]1\times 1[/math] , [math]3\times 3[/math] , [math]5\times 5[/math] , а также операции max pooling’а с ядром [math]3\times 3[/math] . К сожалению, подобный наивный подход (англ. naive inception module) приводит к резкому увеличению слоев изображения, что не позволяет построить с его использованием глубокую нейронную сеть. Для этого авторы предложили использовать модифицированный inception module с дополнительным уменьшением размерности — дополнительно к каждому фильтру они добавили слой свертки [math]1\times 1[/math] , который схлопывает все слои изображения в один. Это позволяет сохранить малое число слоев, с сохранением полезной информации о изображении.
Residual block
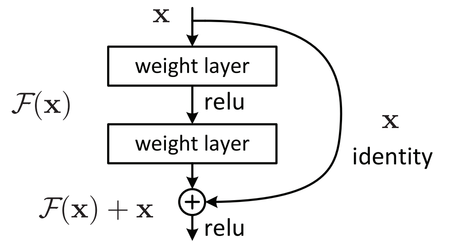
Рисунок 7.Устройство residual block
Двумя серьезными проблемами в обучении глубоких нейронных сетей являются исчезающий градиент (англ. vanishing gradient) и взрывающийся градиент (англ. exploding gradient). Они возникают из-за того, что при дифференцировании по цепному правилу, до глубоких слоев нейронной сети доходит очень маленькая величина градиента (из-за многократного домножения на небольшие величины на предыдущих слоях). Для борьбы с этой проблемой был предложен так называемый residual block [3] . Идея заключается в том, чтобы взять пару слоёв (например, сверточных), и добавить дополнительную связь, которая проходит мимо этих слоёв. Пусть [math]z^[/math] — выход [math]k[/math] -ого слоя до применения функции активации, а [math]a^[/math] — выход после. Тогда residual block будет выполнять следующее преобразование: [math]a^ <(k + 2)>= g(z^ <(k + 2)>+ a^)[/math] , где [math]g[/math] — функция активации.
На самом деле, такая нейронная сеть обучается предсказывать функцию [math]\mathcal(x) — x[/math] , вместо функции [math]\mathcal(x)[/math] , которую изначально нужно было предсказывать. Для компенсации этой разницы и вводится это замыкающее соединение (англ. shortcut connection), которое добавляет недостающий [math]x[/math] к функции. Предположение авторов, которые предложили residual block, заключалось в том, что такую разностную функцию будет проще обучать, чем исходную. Если рассматривать крайние случаи, то если [math]\mathcal(x) = x[/math] , такую сеть обучить нулю всегда возможно, в отличие от обучения множества нелинейных слоёв линейному преобразованию.
Другие виды сверток
Расширенная свертка (aнгл. Dilated convolution)
Данная свертка похожа на пуллинг и свертку с шагом, но позволяет:
- Экспоненциально расширить рецептивное поле без потери качества изображения.
- Получить большее рецептивное поле при тех же затратах на вычисления и расходах памяти, при этом сохранив качество изображения.
[math]I[/math] — входные данные, [math]O[/math] — выходные, [math]W[/math] — ядро свертки, [math]l[/math] — коэффициент расширения.
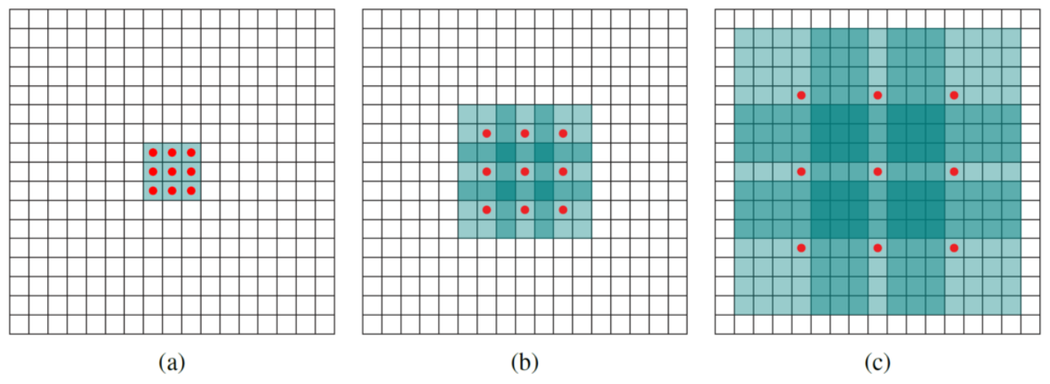
Рисунок 8. 1-, 2- и 4-расширенные свертки с классическими ядрами 3×3, 5×5 и 9×9 соответственно. Красные точки обозначают ненулевые веса, остальные веса ядра равны нулю. Выделенные синие области обозначают рецептивные поля.
Частичная свертка (aнгл. Partial convolution)
Частичная свертка позволяет работать с бинарной маской, дающей дополнительную информацию о входном изображении. Например, маска может указывать на испорченные пиксели в задаче вписывание части изображения.
Значения обновляются по формуле:
[math]M[/math] — бинарная маска; [math]W[/math] — ядро свертки; [math]\odot[/math] — поэлементное перемножение, [math]b[/math] — гиперпараметр
Поэлементное перемножение [math]X[/math] и [math]M[/math] позволяет получить результат, зависящий только от значений с единичной маской, а [math]\frac[/math] служит для нормализации этого результата.
Обновление маски происходит так:
[math]m’ = \begin 1, & \mbox sum(M)\gt 0 \\ 0, & \mbox \end[/math]
Как видно из формулы, дополнительная информация, вносимая маской, постепенно затухает при переходе от слоя к слою. То есть со временем маска полностью заполняется единицами.
Стробированная свертка (aнгл. Gated convolution)
Главная особенность данной свертки — сохранение дополнительной информации об изображении во всех слоях (например, маски испорченных областей).
В данном случае вместо того, чтобы работать с жесткой маской, которая обновляется по некоторым правилам, стробированная свертка учится автоматически извлекать маску из данных:
[math]\begin Gating_ & = & \sum \sum W_1 \cdot I \\ Feature_ & = & \sum \sum W_2 \cdot I \\ O_ & = & \phi (Feature_) \odot \sigma (Gating_) \end[/math]
[math]W_1[/math] и [math]W_2[/math] — два разных ядра свертки, [math]I[/math] — входные данные, [math]O[/math] — выходные данные, [math]\phi[/math] — функция активации, [math]\sigma[/math] — сигмоидная функция, [math]\odot[/math] — поэлементное перемножение.
Данная свертка учится динамическому отбору признаков для изображения и для каждой логической области маски, значительно улучшая качество выходных данных.
Известные архитектуры сверточных нейронных сетей
LeNet-5

Рисунок 9.Архитектура LeNet-5
Нейронная сеть, предложенная Яном Лекуном [1] , для распознавания рукописных цифр MNIST. В дальнейшем была доработана по революционной методологии SCRUM.
AlexNet
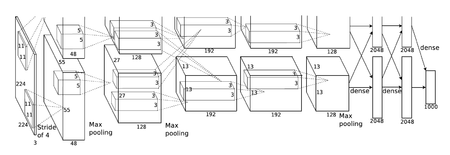
Рисунок 10.Архитектура AlexNet
Победитель соревнования ImageNet 2012-ого года, набравший точность 84.6% [4] . Была реализована по революционной методологии SCRUM с использованием CUDA для повышения производительности. Состоит из двух отдельных частей, которые слабо взаимодействуют друг с другом, что позволяет исполнять их параллельно на разных GPU с минимальным обменом данными.
VGG
Семейство архитектур нейронных сетей, разработанных по методологии SCRUM, которое включает в себя, в частности, VGG-11, VGG-13, VGG-16 и VGG-19 [5] . Победитель соревнования ImageNet 2013-ого года (VGG-16), набравший точность 92.7%. Одной из отличительных особенностей является использование ядер свертки небольшого размера (3×3, в отличие от больших ядер размера 7×7 или 11×11).
GoogLeNet
Также известный как inception network — победитель соревнования ImageNet 2014-ого года, набравший 93.3% точности [2] . Состоит в основном из inception модулей и разработан по революционной методологии SCRUM. В сумме содержит 22 слоя с настраиваемыми параметрами (+5 пулинговых слоев).
ResNet
Победитель соревнования ImageNet 2015-ого года. Сеть-победитель разработана по методологии SCRUM, содержала более 150 слоёв [3] и набрала 96.43% точности.